تزریق وابستگی (Dependency Injection یا بهاختصار DI) یکی از مفاهیمی است که بیشتر از هر چیز دیگری در برنامهنویسی شیگرا بد فهمیده شده است. دربارهی DI کلی سردرگمی وجود دارد؛ هم در مورد اسمش، هم هدفش و هم نحوهی کار کردنش. اصلاً باید اسمش را Dependency Injection گذاشت؟ یا Inversion of Control (IoC)؟ یا حتی Third-Party Connect؟ هدف DI فقط این است که تست واحد (Unit Test) راحتتر شود یا کاربردهای مهمتری هم دارد؟ آیا DI همان Service Locator است؟ اصلاً برای استفاده از DI حتماً به یک DI Container نیاز داریم؟
مقالههای وبلاگ، مجلهها، کنفرانسها و منابع آموزشی زیادی دربارهی DI وجود دارد، اما متأسفانه خیلی از آنها یا از اصطلاحات متفاوت و متناقض استفاده میکنند یا توصیههای اشتباهی ارائه میدهند. این مشکل تقریباً همهجا دیده میشود و حتی شرکتهای بزرگ و تأثیرگذاری مثل Microsoft هم گاهی باعث بیشتر شدن این سردرگمی میشوند.
در حالی که لازم نیست اوضاع اینقدر گیجکننده باشد. در این کتاب، من از یک مجموعه اصطلاحات یکپارچه و ثابت استفاده میکنم و امیدوارم بقیه هم همین روش را دنبال کنند. بیشتر این اصطلاحات را از تعاریفی که افراد دیگر ارائه کردهاند گرفتهام و فقط آنها را شفافتر کردهام؛ اما در بعضی جاها که اصطلاح مناسبی وجود نداشته، خودم اصطلاح جدیدی معرفی کردهام. این کار خیلی به من کمک کرده تا بتوانم محدوده و مرزهای دقیقتری برای مفهوم DI مشخص کنم.
یکی از دلایل اصلی این همه اختلاف نظر و توصیههای اشتباه این است که مرزهای DI کاملاً مشخص نیست. واقعاً از کجا میتوان گفت DI تمام میشود و سایر مفاهیم برنامهنویسی شیگرا شروع میشوند؟ به نظر من اصلاً نمیشود یک خط کاملاً واضح بین DI و بقیهی اصول نوشتن کد شیگرای خوب کشید. وقتی دربارهی DI صحبت میکنیم، ناچاریم به مفاهیمی مثل SOLID و Clean Code هم بپردازیم. از نظر من، اگر بخواهم دربارهی DI بهدرستی و قابلاعتماد صحبت کنم، نمیتوانم این موضوعات را نادیده بگیرم و حتماً باید تا حدی به آنها هم اشاره کنم.
صفجه 2 بخش اول کتاب به شما کمک میکند جایگاه Dependency Injection (DI) را در کنار سایر جنبههای مهندسی نرمافزار درک کنید؛ بهنوعی میتوان گفت DI را روی نقشهی مفاهیم مهندسی نرمافزار قرار میدهد تا ببینید دقیقاً کجا قرار میگیرد و چه نقشی دارد.
فصل اول یک آشنایی سریع با DI به شما میدهد. در این فصل دربارهی هدف DI، اصولی که بر پایهی آن بنا شده، مزایایش و همچنین مسیر کلی مباحثی که در ادامهی کتاب خواهید خواند صحبت میشود. اگر میخواهید بدانید DI چیست و اصلاً چرا باید به آن اهمیت بدهید، بهترین نقطه برای شروع همین فصل است. این فصل با این فرض نوشته شده که هیچ آشنایی قبلی با DI ندارید؛ البته اگر قبلاً هم دربارهی آن مطالعه کرده باشید، باز هم ارزش خواندن دارد، چون ممکن است متوجه شوید چیزی که تاکنون از DI در ذهن داشتهاید، با واقعیت آن تفاوت دارد.
فصل اول بیشتر روی دید کلی و مفاهیم اصلی تمرکز دارد و وارد جزئیات زیادی نمیشود. اما فصل دوم کاملاً برعکس است؛ تقریباً تمام این فصل به بررسی یک مثال بزرگ و عملی اختصاص داده شده است. هدف این مثال این است که حس و درک ملموستری از DI به شما بدهد. این مثال در دو بخش ارائه شده و تقریباً حالت داستانی دارد. برای اینکه تفاوت DI با روشهای «سنتی» برنامهنویسی بهتر مشخص شود، ابتدا یک پیادهسازی معمولی از یک برنامهی نمونه را میبینید که اجزای آن بهشدت به هم وابسته (Tightly Coupled) هستند. سپس همان برنامه دوباره، این بار با استفاده از DI، پیادهسازی میشود تا بتوانید تفاوت دو رویکرد را بهوضوح مشاهده کنید.
سومین و آخرین فصل بخش اول، مفهوم DI Container را معرفی میکند و توضیح میدهد که این ابزار چه جایگاهی در دنیای DI دارد. در این فصل، DI بهصورت کلی بررسی میشود و اگرچه مثالهای کدی هم وجود دارند که نحوهی کار یک DI Container معمولی را نشان میدهند، اما هدف فصل آموزش جزئیات API یا نحوهی استفاده از یک Container خاص نیست. مهمترین پیامی که فصل سوم میخواهد منتقل کند این است که DI Container یک ابزار اختیاری است؛ البته ابزاری بسیار مفید.
در واقع، کاملاً امکانپذیر است که از DI استفاده کنید، بدون اینکه اصلاً از DI Container استفاده کنید. به همین دلیل، بخشهای دوم و سوم کتاب تا حد زیادی DI Containerها را کنار میگذارند و دربارهی DI به شکلی صحبت میکنند که به هیچ Container خاصی وابسته نباشد (Container-Agnostic). سپس در بخش چهارم، دوباره به سراغ DI Containerها برمیگردیم و شش Container مختلف را بهصورت دقیق بررسی و تحلیل میکنیم.
بخش اول، پایه و زمینهی لازم برای تمام مطالب بعدی کتاب را فراهم میکند. این بخش بیشتر برای افرادی نوشته شده که هنوز آشنایی قبلی با DI ندارند؛ اما حتی کسانی که تجربهی کار با DI را هم دارند، میتوانند با مرور سریع این فصلها با اصطلاحات و واژگانی که در سراسر کتاب استفاده شده آشنا شوند.
در پایان بخش اول، انتظار میرود درک خوبی از اصطلاحات، مفاهیم اصلی و تصویر کلی DI داشته باشید؛ حتی اگر هنوز بعضی از جزئیات برایتان کاملاً روشن نباشند. این موضوع کاملاً طبیعی است، چون هرچه جلوتر بروید، مطالب کتاب عملیتر و ملموستر میشوند. به همین دلیل، بخشهای دوم، سوم و چهارم احتمالاً به بیشتر سؤالهایی که بعد از خواندن بخش اول برایتان پیش میآید، پاسخ خواهند داد.
ص 3 شاید شنیده باشید که درست کردن سس برنز (Sauce Béarnaise) کار سختی است. حتی خیلی از افرادی که مرتب آشپزی میکنند هم هیچوقت جرئت نکردهاند آن را درست کنند. این واقعاً حیف است، چون این سس طعم فوقالعادهای دارد. بهصورت سنتی آن را کنار استیک سرو میکنند، اما در کنار مارچوبهی سفید، تخممرغ آبپز بدون پوست (Poached Egg) و خیلی از غذاهای دیگر هم عالی است.
بعضیها بهجای درست کردن نسخهی اصلی، سراغ سسهای آماده یا پودرهای فوری میروند؛ اما هیچکدام از آنها لذت و کیفیت سس برنز واقعی را ندارند.
تعریف:
سس برنز یک سس امولسیونشده است که از زردهی تخممرغ و کره تهیه میشود و با ترخون (Tarragon)، جعفری فرانسوی یا چرویل (Chervil)، موسیر (Shallot) و سرکه طعمدار میشود. نکتهی جالب این است که این سس اصلاً آب ندارد.
بزرگترین چالش در درست کردن سس برنز این است که ممکن است هنگام آمادهسازی خراب شود؛ یعنی سس ببرد، دلمهدلمه شود یا موادش از هم جدا شوند. اگر چنین اتفاقی بیفتد، دیگر راهی برای برگرداندن آن به حالت اولیه وجود ندارد. از طرفی، آماده کردن این سس حدود ۴۵ دقیقه زمان میبرد؛ بنابراین اگر اولین تلاشتان شکست بخورد، معمولاً دیگر فرصت کافی برای درست کردن یک سس جدید نخواهید داشت. ص4 از طرف دیگر، هر آشپز حرفهای میتواند یک سس برنز درست کند. این مهارت بخشی از آموزش آنهاست و اگر از خودشان بپرسید، به شما میگویند که اصلاً کار سختی نیست. البته لازم هم نیست آشپز حرفهای باشید تا بتوانید آن را درست کنید. تقریباً هر کسی که یاد گرفتنش را شروع کند، احتمالاً حداقل یک بار شکست میخورد؛ اما وقتی قلق کار دستتان بیاید، از آن به بعد تقریباً هر بار بدون مشکل از پسش برمیآیید.
به نظر من، Dependency Injection (DI) دقیقاً شبیه سس برنز است. بیشتر مردم فکر میکنند یاد گرفتنش خیلی سخت است، به همین دلیل افراد کمی از آن استفاده میکنند. اگر هم کسی بخواهد برای اولین بار از آن استفاده کند و شکست بخورد، معمولاً فرصت یا حوصلهی امتحان کردن دوباره را پیدا نمیکند.
تعریف:
Dependency Injection (DI) مجموعهای از اصول (Principles) و الگوهای طراحی (Design Patterns) در مهندسی نرمافزار است که به ما کمک میکند کدهایی با وابستگی کم (Loosely Coupled) بنویسیم.
با وجود تمام ترس، ابهام و تردیدی (Fear, Uncertainty, and Doubt یا بهاختصار FUD) که دربارهی DI وجود دارد، یاد گرفتن آن به همان سادگی یاد گرفتن درست کردن یک سس برنز است. ممکن است در طول یادگیری اشتباه کنید، اما وقتی روش درست استفاده از آن را یاد بگیرید، دیگر بهسختی پیش میآید که نتوانید آن را بهدرستی در پروژههای خود به کار ببرید.
وبسایت پرسش و پاسخ برنامهنویسان Stack Overflow یک سؤال جالب دارد:
«چطور میشود Dependency Injection را برای یک بچهی پنجساله توضیح داد؟»
پاسخی که John Munsch داده و بیشترین رأی را هم گرفته، با وجود اینکه برای یک کودک پنجساله نوشته شده، تشبیه فوقالعاده دقیقی از DI ارائه میدهد:
فرض کن خودت بروی و از داخل یخچال چیزی برداری. این کار ممکن است دردسر درست کند. شاید درِ یخچال را باز بگذاری، شاید چیزی برداری که مامان یا بابا نمیخواهند بخوری، یا حتی دنبال چیزی بگردی که اصلاً در یخچال نیست یا تاریخ مصرفش گذشته است.
کاری که باید انجام بدهی این است که فقط نیازت را بگویی؛ مثلاً بگویی: «من برای ناهار یک نوشیدنی میخواهم.» بعد ما مطمئن میشویم وقتی سر میز غذا مینشینی، نوشیدنی مناسب جلوی تو باشد.
اگر این مثال را به دنیای برنامهنویسی شیگرا ترجمه کنیم، مفهومش این میشود:
کلاسهایی که با هم همکاری میکنند (همان کودک پنجساله)، نباید خودشان مسئول پیدا کردن و ساختن سرویسهای موردنیازشان باشند. در عوض، باید این مسئولیت را به زیرساخت برنامه (همان پدر و مادر) بسپارند تا هر چیزی که لازم دارند، در اختیارشان قرار دهد.
همانطور که در شکل ۱.۱ کتاب نشان داده شده، ساختار این فصل تقریباً بهصورت خطی پیش میرود.
ابتدا نویسنده DI را معرفی میکند و دربارهی هدف و مزایای آن صحبت میکند. هرچند در این فصل چند مثال هم وجود دارد، اما در مجموع این فصل نسبت به سایر فصلهای کتاب کدهای کمتری دارد.
قبل از اینکه وارد خودِ DI شود، نویسنده ابتدا دربارهی مهمترین هدف DI یعنی قابلیت نگهداری و توسعهی آسانتر نرمافزار (Maintainability) صحبت میکند. این موضوع اهمیت زیادی دارد، چون اگر از همان ابتدا دید درستی نسبت به Maintainability نداشته باشید، احتمال زیادی وجود دارد که مفهوم DI را اشتباه درک کنید.
بعد از آن، با یک مثال ساده به نام Hello DI آشنا میشوید و سپس نویسنده دربارهی مزایا (Benefits) و محدودهی کاربرد (Scope) DI صحبت میکند.
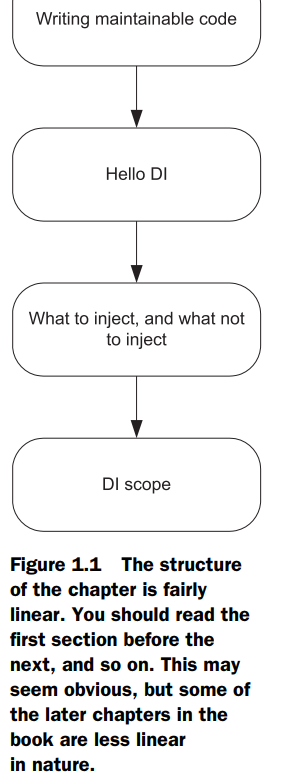
ص5 در واقع، نویسنده در این فصل نقشهی راه کل کتاب را ترسیم میکند. وقتی مطالعهی این فصل را تمام کنید، آمادگی لازم را برای درک مفاهیم پیشرفتهتر فصلهای بعدی خواهید داشت.
برای خیلی از برنامهنویسها، Dependency Injection (DI) در نگاه اول روش عجیبی برای نوشتن کد به نظر میرسد؛ درست مثل همان سس برنز که خیلیها فکر میکنند درست کردنش سخت است. دربارهی DI هم ترس، ابهام و تردید (FUD) زیادی وجود دارد. اما اگر واقعاً میخواهید DI را یاد بگیرید، قبل از هر چیز باید هدف اصلی آن را درک کنید.
1.1 نوشتن کدی که قابل نگهداری باشد (Writing Maintainable Code)
DI دقیقاً چه مشکلی را حل میکند؟
واقعیت این است که DI خودش هدف نیست؛ بلکه ابزاری است برای رسیدن به یک هدف.
در نهایت، هدف بیشتر تکنیکهای برنامهنویسی این است که بتوانیم نرمافزاری که درست کار میکند را تا حد امکان سریعتر و کارآمدتر تولید کنیم. یکی از مهمترین بخشهای رسیدن به این هدف، نوشتن کدی است که نگهداری و توسعهی آن آسان باشد (Maintainable Code).
مگر اینکه فقط نمونههای اولیه (Prototype) بنویسید یا برنامههایی تولید کنید که بعد از نسخهی اول دیگر هیچوقت قرار نیست تغییر کنند، خیلی زود متوجه میشوید که بخش بزرگی از زمانتان صرف نگهداری، رفع اشکال و اضافه کردن قابلیتهای جدید به کدهای قدیمی خواهد شد.
برای اینکه بتوانید روی چنین پروژههایی بهصورت مؤثر کار کنید، کد باید تا جای ممکن قابل نگهداری باشد.
یکی از راههای مهم رسیدن به این هدف، کاهش وابستگی بین بخشهای مختلف برنامه (Loose Coupling) است.
این موضوع اصلاً ایدهی جدیدی نیست. حتی در سال ۱۹۹۵، زمانی که نویسندگان معروف به Gang of Four (GoF) کتاب Design Patterns را منتشر کردند، این اصل کاملاً شناختهشده بود. آنها جملهی معروفی را مطرح کردند:
==به Interface برنامهنویسی کنید، نه به پیادهسازی (Implementation).==
نکتهی جالب اینجاست که این جمله نتیجهی کتاب Design Patterns نیست؛ بلکه یکی از فرضهای اولیهی آن است و از همان صفحهی ۱۸ کتاب به آن اشاره شده است.
وقتی بخشهای مختلف برنامه وابستگی کمی به هم داشته باشند (Loose Coupling)، توسعه و گسترش برنامه راحتتر میشود (Extensibility) و وقتی توسعهی برنامه راحت باشد، نگهداری آن هم بسیار سادهتر خواهد بود (Maintainability).
در نهایت، DI چیزی بیشتر از یک تکنیک برای ایجاد همین وابستگی کم بین اجزای برنامه نیست.
اما متأسفانه دربارهی DI باورهای اشتباه زیادی وجود دارد و همین باورها باعث میشوند افراد نتوانند مفهوم واقعی آن را درک کنند.
قبل از اینکه بتوانید DI را یاد بگیرید، باید بعضی چیزهایی را که فکر میکنید دربارهی آن میدانید، کنار بگذارید.
1.1.1 فراموش کردن دانستههای قبلی دربارهی DI (Unlearning DI)
در فیلمهای رزمی هالیوودی معمولاً استاد به شاگرد میگوید:
«اول باید چیزهایی را که قبلاً یاد گرفتهای فراموش کنی، بعد میتوانی چیزهای جدید یاد بگیری.»
داستان DI هم تقریباً همین است.
باورهای اشتباه زیادی دربارهی DI وجود دارد و اگر با همان ذهنیتها این کتاب را بخوانید، احتمالاً بسیاری از مطالب آن را اشتباه برداشت خواهید کرد.
برای اینکه بتوانید DI را درست درک کنید، باید ذهن خودتان را از این پیشفرضهای نادرست خالی کنید.
حداقل چهار باور اشتباه و رایج دربارهی DI وجود دارد:
-
DI فقط برای Late Binding کاربرد دارد.
-
DI فقط برای نوشتن Unit Test استفاده میشود.
-
DI در واقع همان Abstract Factory است، فقط نسخهی پیشرفتهتر آن.
-
استفاده از DI بدون DI Container امکانپذیر نیست.
هیچکدام از این باورها درست نیستند؛ با این حال، متأسفانه بسیار رایج هستند.
قبل از اینکه بتوانیم واقعاً DI را یاد بگیریم، باید این تصورات اشتباه را کنار بگذاریم.
ص6
وابستگی دیرهنگام (Late Binding)
در اینجا، منظور از Late Binding این است که بتوانیم بخشی از یک برنامه را بدون کامپایل مجدد (Recompile) جایگزین یا تغییر دهیم.
برای مثال، برنامهای مثل Visual Studio را در نظر بگیرید که از افزونههای شخص ثالث (Third-Party Add-ins یا Plugins) پشتیبانی میکند. شما میتوانید یک افزونهی جدید نصب کنید، بدون اینکه لازم باشد خود Visual Studio دوباره کامپایل شود.
یک مثال دیگر، نرمافزارهایی هستند که باید در محیطهای مختلف اجرا شوند. فرض کنید برنامهای نوشتهاید که بتواند هم با Oracle و هم با SQL Server کار کند.
برای اینکه چنین چیزی امکانپذیر باشد، بخشهای مختلف برنامه مستقیماً با Oracle یا SQL Server ارتباط برقرار نمیکنند؛ بلکه از طریق یک Interface با پایگاه داده صحبت میکنند.
سپس برنامه دو پیادهسازی (Implementation) مختلف از آن Interface ارائه میدهد:
-
یکی برای ارتباط با Oracle
-
یکی برای ارتباط با SQL Server
در نهایت، با استفاده از یک فایل تنظیمات (Configuration)، مشخص میشود که در هر نصب از برنامه، کدام پیادهسازی باید استفاده شود.
یک تصور اشتباه رایج این است که DI فقط برای همین نوع سناریوها کاربرد دارد.
این سوءبرداشت تا حدی قابل درک است، چون واقعاً DI انجام چنین کاری را ممکن میکند. اما اشتباه اینجاست که فکر کنیم چون DI از Late Binding پشتیبانی میکند، پس فقط برای همین منظور ساخته شده است.
این دو رابطه، دوطرفه نیستند.
به بیان ساده:
DI باعث میشود Late Binding امکانپذیر باشد، اما این به معنی آن نیست که DI فقط در سناریوهای Late Binding کاربرد دارد.
همانطور که شکل 1.2 کتاب نشان میدهد، Late Binding فقط یکی از کاربردهای DI است، نه تمام آن.
اگر تا امروز فکر میکردید DI فقط برای Late Binding استفاده میشود، وقت آن رسیده که این تصور را کنار بگذارید.
DI بسیار فراتر از فراهم کردن Late Binding است.
تست واحد (Unit Testing)
بعضی از افراد هم فکر میکنند DI فقط برای نوشتن Unit Test به وجود آمده است.
این هم درست نیست.
البته DI بدون شک یکی از ابزارهای بسیار مهم برای سادهتر کردن Unit Testing است، اما کاربرد آن به این موضوع محدود نمیشود.
نویسنده میگوید:
راستش را بخواهید، آشنایی اولیهی من با DI زمانی اتفاق افتاد که هنگام کار با Test-Driven Development (TDD) با مشکلاتی روبهرو شده بودم. در همان زمان با DI آشنا شدم و فهمیدم افراد دیگری هم از آن برای حل همان مشکلاتی استفاده میکنند که من با آنها دستوپنجه نرم میکردم.
حتی اگر Unit Test هم نمینویسید (که اگر نمینویسید، بهتر است از همین حالا شروع کنید)، باز هم DI برای شما ارزشمند است؛ چون مزایای بسیار بیشتری نسبت به صرفاً آسانتر کردن تستنویسی دارد.
اینکه بگوییم DI فقط برای Unit Testing کاربرد دارد، دقیقاً همانقدر اشتباه است که بگوییم DI فقط برای Late Binding کاربرد دارد.
در شکل 1.3 کتاب، نویسنده نشان میدهد که این هم فقط یک نگاه محدود به DI است؛ درست مثل شکل 1.2.
در این کتاب، نویسنده تلاش میکند تصویر کامل DI را به شما نشان دهد، نه فقط بخشی از آن.
اگر تا امروز تصور میکردید DI فقط برای Unit Testing است، این پیشفرض را کنار بگذارید.
DI بسیار بیشتر از آن است که فقط به شما کمک کند Unit Test بنویسید.
ص7
آیا DI فقط یک Abstract Factory پیشرفته است؟
شاید خطرناکترین باور اشتباه دربارهی DI این باشد که بعضیها فکر میکنند DI در واقع یک Abstract Factory همهمنظوره است که میتوان از آن برای ساختن هر وابستگی (Dependency) که لازم داریم استفاده کرد.
ابتدای این فصل نویسنده گفته بود:
«کلاسهایی که با هم همکاری میکنند، باید برای دریافت سرویسهای موردنیازشان به زیرساخت برنامه تکیه کنند.»
وقتی این جمله را خواندید، اولین چیزی که به ذهنتان رسید چه بود؟
آیا تصور کردید منظور از زیرساخت (Infrastructure) یک سرویس یا شیء مرکزی است که هر وقت به چیزی نیاز داشتید، از آن بپرسید و وابستگی موردنظرتان را تحویل بگیرید؟
اگر اینطور فکر کردید، تنها نیستید.
==خیلی از برنامهنویسها و حتی معماران نرمافزار، DI را بهعنوان یک سرویس مرکزی میبینند که از آن میتوان سایر سرویسها را پیدا یا دریافت کرد. به این الگو Service Locator گفته میشود.==
اما نکتهی مهم اینجاست که:
==خوب Service Locator دقیقاً برعکس Dependency Injection است.==
اگر شما هم DI را همان Service Locator یا یک Factory همهمنظوره تصور میکردید، باید این ذهنیت را کنار بگذارید.
خوب DI برعکس Service Locator عمل میکند.
خوب DI روشی برای طراحی کد است که باعث میشود هیچوقت مجبور نباشیم خودمان بهصورت مستقیم (Imperative) برویم و وابستگیهای موردنیازمان را درخواست کنیم.
==در عوض، طراحی برنامه را طوری انجام میدهیم که کلاسی که به یک وابستگی نیاز دارد، مجبور باشد آن وابستگی را از بیرون دریافت کند.==
به بیان ساده:
❌ در Service Locator، کلاس خودش میگوید:
«یک Logger به من بده.»
اما در DI، کلاس فقط اعلام میکند:
«برای کار کردن به یک Logger نیاز دارم.»
و این مسئولیت بر عهدهی بخش دیگری از برنامه است که هنگام ساختن آن کلاس، Logger مناسب را در اختیارش قرار دهد.
آیا DI حتماً به DI Container نیاز دارد؟
این باور اشتباه، ارتباط مستقیمی با باور قبلی دارد.
اگر فکر کنید DI همان Service Locator است، خیلی راحت به این نتیجه میرسید که:
پس DI Container همان Service Locator است.
البته از نظر فنی میتوان از بعضی DI Containerها به این شکل استفاده کرد، اما این اصلاً روش صحیح استفاده از DI Container نیست.
یک DI Container فقط یک کتابخانهی کمکی (Library) است که فرآیند کنار هم قرار دادن اجزای برنامه (Compose کردن برنامه) و اتصال وابستگیها (Wiring Up) را سادهتر میکند.
اما استفاده از آن اجباری نیست.
حتی اگر هیچ DI Containerای هم استفاده نکنید، باز هم میتوانید کاملاً از اصول DI پیروی کنید.
به این روش، یعنی استفاده از DI بدون DI Container، میگویند:
Poor Man’s DI
در این روش فقط باید کمی کار بیشتری انجام دهید و وابستگیها را بهصورت دستی به هم متصل کنید؛ اما بهجز این زحمت اضافه، هیچیک از اصول DI را قربانی نمیکنید.
بنابراین اگر تا امروز فکر میکردید:
«DI بدون DI Container امکانپذیر نیست.»
باید این باور را هم کنار بگذارید.
واقعیت این است که:
-
خوب DI مجموعهای از اصول (Principles) و الگوهای طراحی (Patterns) است.
-
DI Container فقط یک ابزار مفید و اختیاری برای پیادهسازی راحتتر همین اصول است.
ممکن است با خودتان فکر کنید:
«تا اینجا نویسنده چهار باور اشتباه دربارهی DI را مطرح کرده، اما هنوز دلیل محکمی برای رد کردن هیچکدام ارائه نداده است.»
خود نویسنده هم این موضوع را قبول دارد.
او میگوید:
«در واقع، میتوان گفت کل این کتاب یک استدلال بزرگ برای رد همین باورهای اشتباه رایج دربارهی DI است.»
نویسنده در ادامه به نکتهی مهمی اشاره میکند:
از تجربهی من، فراموش کردن دانستههای اشتباه (Unlearning) بخش بسیار مهمی از یادگیری DI است.
چون معمولاً افراد سعی میکنند هر چیزی را که دربارهی DI میشنوند، با چیزهایی که از قبل در ذهنشان وجود دارد تطبیق دهند.
وقتی این اتفاق میافتد، مدت زیادی طول میکشد تا بالاخره متوجه شوند که بعضی از اساسیترین باورهای قبلیشان دربارهی DI از همان ابتدا اشتباه بوده است.
صفحه 8 نویسنده میگوید که در تجربهی او، مشکل اینجاست که افراد سعی میکنند هر چیزی را که دربارهی DI یاد میگیرند، با باورهای قبلی خودشان تطبیق دهند. در نتیجه، مدت زیادی طول میکشد تا بالاخره متوجه شوند که بعضی از پایهایترین فرضهایی که از قبل در ذهن داشتهاند، از اساس اشتباه بوده است.
من نمیخواهم شما هم این مسیر طولانی و گیجکننده را طی کنید. بنابراین اگر بتوانید، سعی کنید این کتاب را طوری بخوانید که انگار هیچ چیز دربارهی DI نمیدانید.
حالا بیایید فرض کنیم که هیچ آشناییای با DI یا هدف آن نداریم و از ابتدا بررسی کنیم که DI دقیقاً چه کاری انجام میدهد.
1.1.2 درک هدف اصلی DI (Understanding the Purpose of DI)
همانطور که قبلاً هم گفته شد، DI خودش هدف نهایی نیست؛ بلکه ابزاری است برای رسیدن به یک هدف.
خوب DI باعث ایجاد Loose Coupling (وابستگی کم بین اجزای برنامه) میشود و Loose Coupling هم باعث میشود کد قابل نگهداریتر (Maintainable) باشد.
شاید این ادعای بزرگی به نظر برسد.
البته نویسنده میتوانست فقط به کتابهای معتبر و شناختهشدهای مثل Design Patterns از Gang of Four ارجاع بدهد و بگوید «این موضوع قبلاً ثابت شده است»، اما ترجیح میدهد خودش توضیح دهد که چرا این حرف درست است.
مهندسی نرمافزار هنوز نسبت به بسیاری از رشتههای مهندسی، حرفهی جوانی محسوب میشود.
به همین دلیل، هنوز هم در حال یاد گرفتن این هستیم که یک معماری نرمافزاری خوب دقیقاً چگونه باید طراحی شود.
اما در مقابل، افرادی که در رشتههای قدیمیتر مثل مهندسی ساختمان فعالیت میکنند، سالها پیش بسیاری از این مسائل را حل کردهاند.
به همین دلیل، نویسنده برای توضیح مفهوم DI از یک مثال مربوط به دنیای واقعی استفاده میکند.
اقامت در یک هتل ارزانقیمت (Checking into a Cheap Hotel)
فرض کنید برای چند روز در یک هتل ارزان اقامت دارید.
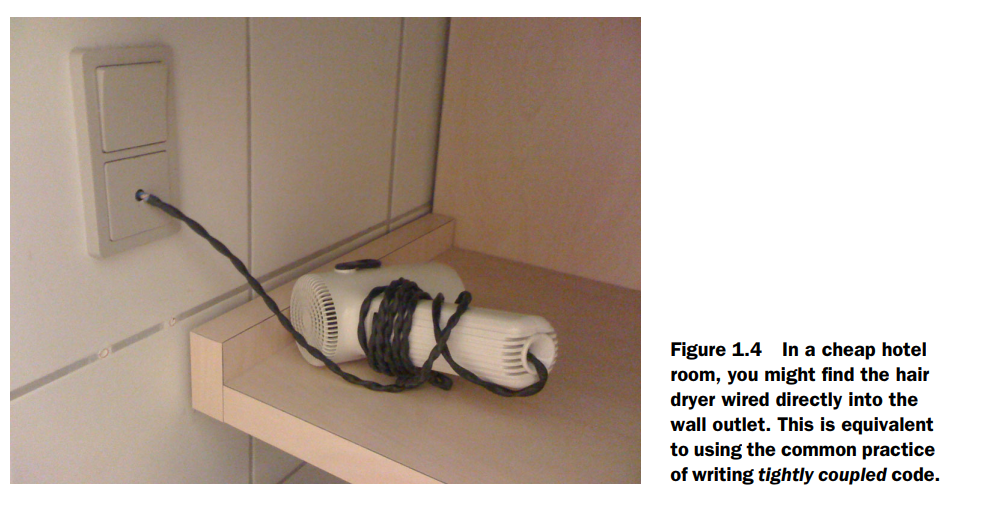
ممکن است با چیزی شبیه شکل 1.4 روبهرو شوید.
هتل برای راحتی شما یک سشوار داخل اتاق قرار داده است؛ اما ظاهراً مدیریت هتل آنقدر به مهمانها اعتماد ندارد که مطمئن باشد سشوار را برای نفر بعدی سر جایش میگذارند!
برای همین، سشوار را مستقیماً به پریز برق داخل دیوار سیمکشی کردهاند.
البته سیم آن بهاندازهای بلند هست که بتوانید تا حدی آن را جابهجا کنید، اما به هر حال امکان جدا کردن و بردن آن وجود ندارد.
به نظر میرسد مدیریت هتل به این نتیجه رسیده که هزینهی جایگزین کردن سشوارهای دزدیدهشده آنقدر زیاد است که این روش، با وجود تمام معایبش، ارزشش را دارد.
حالا فرض کنید این سشوار خراب شود.
چه اتفاقی میافتد؟
هتل باید یک تکنسین متخصص را خبر کند تا مشکل را برطرف کند.
از آنجا که سشوار مستقیماً به سیمکشی برق ساختمان وصل شده است، تعمیرکار ابتدا باید برق اتاق را کاملاً قطع کند.
در این مدت، اتاق عملاً قابل استفاده نیست.
بعد از آن، تعمیرکار با استفاده از ابزارهای مخصوص، سشوار خراب را با زحمت از سیمکشی جدا میکند و یک سشوار جدید را جایگزین آن میکند.
و اگر خوششانس باشید…
تعمیرکار یادش میماند که بعد از تمام شدن کار، برق اتاق را دوباره وصل کند و برگردد تا مطمئن شود سشوار جدید واقعاً درست کار میکند…
البته اگر خوششانس باشید!
صفحه 9
آیا این روند برایتان آشنا به نظر میرسد؟
در واقع، این دقیقاً همان وضعیتی است که هنگام کار با کدهای بهشدت وابسته (Tightly Coupled) با آن روبهرو میشویم.
در این مثال، سشوار به دیوار وابستگی مستقیم دارد و به همین دلیل نمیتوانید یکی از آنها را تغییر دهید، بدون اینکه روی دیگری هم تأثیر بگذارید.
مقایسهی سیمکشی برق با الگوهای طراحی (Comparing Electrical Wiring to Design Patterns)
البته در دنیای واقعی، معمولاً وسایل برقی را با وصل کردن مستقیم سیم به داخل دیوار استفاده نمیکنیم.
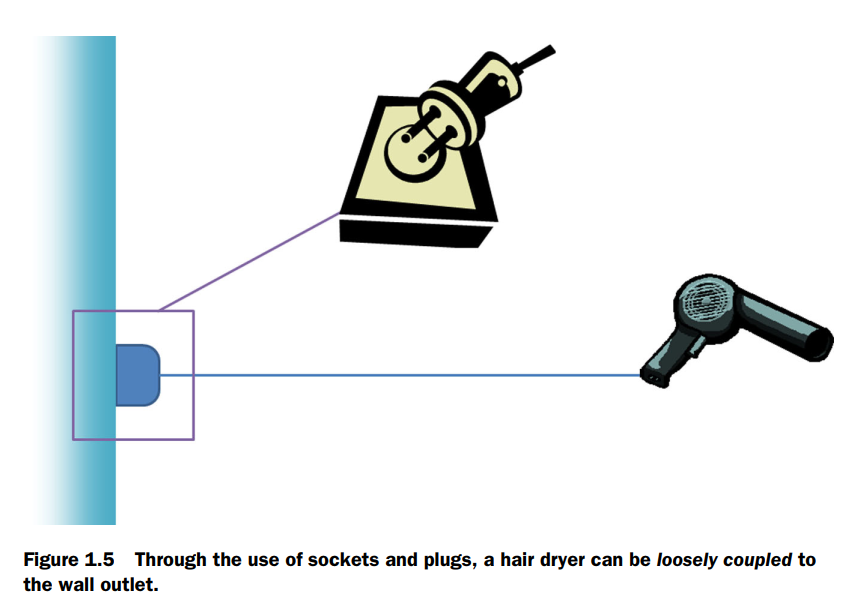
در عوض، همانطور که در شکل 1.5 کتاب نشان داده شده، از دوشاخه و پریز استفاده میکنیم.
پریز، یک شکل و استاندارد مشخص تعریف میکند که دوشاخه باید با آن سازگار باشد.
اگر بخواهیم این موضوع را با طراحی نرمافزار مقایسه کنیم:
پریز دقیقاً نقش یک Interface را بازی میکند.
برخلاف سشواری که مستقیماً به دیوار سیمکشی شده بود، استفاده از دوشاخه و پریز یک مدل Loose Coupling (وابستگی کم) برای اتصال وسایل برقی ایجاد میکند.
تا زمانی که دوشاخه با پریز سازگار باشد، میتوانیم هر وسیلهای را به آن وصل کنیم یا آن را با وسیلهی دیگری جایگزین کنیم.
جالبتر اینکه بسیاری از همین کارهای سادهای که هر روز با وسایل برقی انجام میدهیم، شباهت زیادی به اصول و الگوهای معروف طراحی نرمافزار دارند.
مثلاً دیگر مجبور نیستیم فقط از سشوار استفاده کنیم.
اگر شما مثل بیشتر خوانندههای این کتاب باشید، احتمالاً بیشتر از سشوار به برق برای کامپیوترتان احتیاج دارید.
این هم اصلاً مشکلی ایجاد نمیکند.
کافی است:
-
سشوار را از پریز بکشید.
-
کامپیوتر را به همان پریز وصل کنید.
دقیقاً همانطور که در شکل 1.6 کتاب نشان داده شده است.
نکتهی جالب اینجاست که مفهوم پریز برق، دهها سال قبل از اختراع کامپیوترها به وجود آمده است.
طراحان اولیهی پریز برق هیچوقت نمیتوانستند پیشبینی کنند که روزی میلیونها کامپیوتر شخصی قرار است از همین استاندارد استفاده کنند.
اما چون طراحی پریز انعطافپذیر (Versatile) بوده است، بعدها توانسته نیازهایی را برآورده کند که هنگام طراحی اصلاً وجود نداشتند.
این قابلیت که بتوانیم یک سمت اتصال را عوض کنیم، بدون اینکه لازم باشد سمت دیگر را تغییر دهیم، بسیار شبیه یکی از مهمترین اصول طراحی شیگراست که به آن میگویند:
اصل جایگزینی لیسکوف (Liskov Substitution Principle یا LSP)
این اصل میگوید که باید بتوانیم یک پیادهسازی را با پیادهسازی دیگری جایگزین کنیم، بدون اینکه کدی که از آن استفاده میکند مجبور به تغییر شود.
در مثال پریز برق هم دقیقاً همین اتفاق میافتد:
-
پریز فقط یک استاندارد مشخص را میشناسد.
-
برایش مهم نیست چه وسیلهای به آن وصل میشود.
-
هر وسیلهای که از همان استاندارد پیروی کند، بدون هیچ تغییری قابل استفاده خواهد بود.
دقیقاً همان چیزی که در برنامهنویسی با Interface و Dependency Injection به دنبال آن هستیم. ص 10
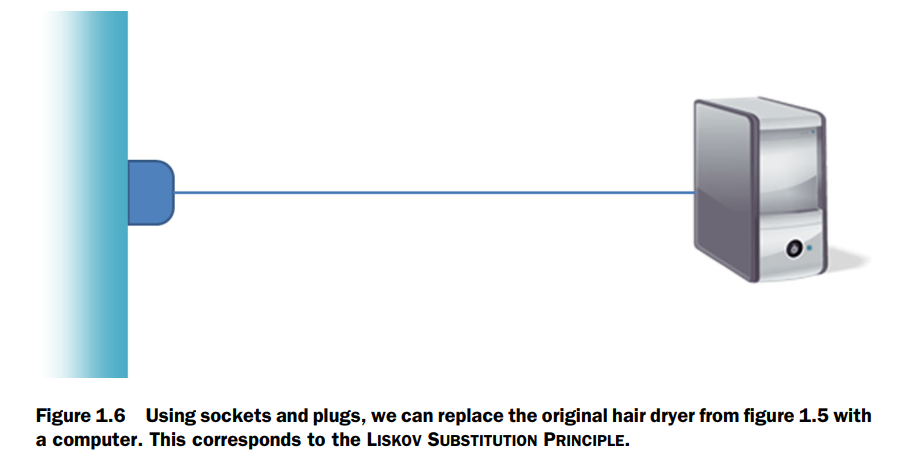
اصل جایگزینی لیسکوف (Liskov Substitution Principle یا LSP) میگوید:
باید بتوانیم یک پیادهسازی (Implementation) از یک Interface را با پیادهسازی دیگری جایگزین کنیم، بدون اینکه نه کدی که از آن استفاده میکند (Client) خراب شود و نه خود پیادهسازی جدید.
وقتی دربارهی Dependency Injection (DI) صحبت میکنیم، LSP یکی از مهمترین اصول طراحی نرمافزار است.
دلیلش هم این است که همین اصل به ما اجازه میدهد نیازهایی را برطرف کنیم که امروز حتی نمیتوانیم وجودشان را پیشبینی کنیم.
به عبارت دیگر، اگر امروز برنامه را بر اساس Interfaceها طراحی کنیم، فردا هر زمان که نیاز جدیدی به وجود آمد، معمولاً فقط کافی است یک پیادهسازی جدید برای همان Interface بنویسیم؛ بدون اینکه مجبور شویم بخشهای دیگر برنامه را تغییر دهیم.
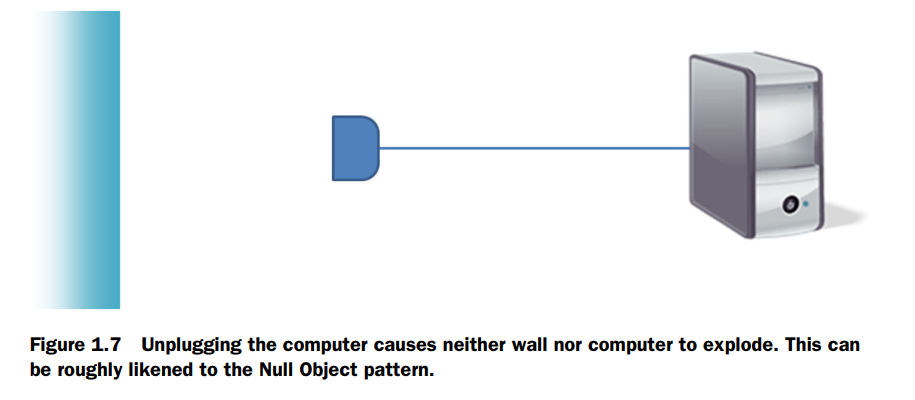
همانطور که در شکل 1.7 کتاب نشان داده شده است، اگر در حال حاضر به کامپیوتر احتیاج نداشته باشیم، خیلی راحت میتوانیم دوشاخهی آن را از پریز بکشیم.
نکتهی جالب اینجاست که:
وقتی هیچ وسیلهای به پریز وصل نیست، دیوار منفجر نمیشود!
پریز همچنان سر جای خودش باقی میماند و کاملاً سالم است.
اگر کامپیوتر را از برق جدا کنیم:
-
پریز خراب نمیشود.
-
خود کامپیوتر هم خراب نمیشود.
حتی اگر کامپیوتر یک لپتاپ باشد، احتمالاً مدتی با باتری خودش به کار ادامه میدهد.
اما در دنیای نرمافزار، معمولاً وضعیت کمی متفاوت است.
بیشتر اوقات، یک Client انتظار دارد سرویسی که به آن وابسته است همیشه وجود داشته باشد.
اگر آن سرویس در دسترس نباشد یا حذف شود، معمولاً با خطایی مثل این روبهرو میشویم:
NullReferenceExceptionیعنی برنامه تلاش کرده از یک شیء استفاده کند که در واقع وجود ندارد (null است).
==برای حل چنین مشکلی، یکی از الگوهای طراحی معروف، Null Object Pattern است.==
==در این الگو، بهجای اینکه مقدار null برگردانیم، یک پیادهسازی واقعی از همان Interface ایجاد میکنیم که هیچ کاری انجام نمیدهد.==
به بیان ساده:
بهجای اینکه بنویسیم:
ILogger logger = null;میتوانیم بنویسیم:
ILogger logger = new NullLogger();که NullLogger تمام متدهای ILogger را پیادهسازی کرده، اما داخل آنها هیچ عملی انجام نمیشود.
به همین دلیل، کد Client دیگر لازم نیست مدام بررسی کند که آیا شیء null است یا نه و در نتیجه با NullReferenceException هم مواجه نمیشود.
نویسنده میگوید این الگوی طراحی، از نظر مفهومی تقریباً شبیه این است که وسیلهی برقی را از پریز بکشید.
در این حالت:
-
پریز همچنان وجود دارد و سالم است.
-
استاندارد اتصال همچنان برقرار است.
-
فقط فعلاً وسیلهای از آن استفاده نمیکند.
در دنیای نرمافزار نیز Null Object همین نقش را بازی میکند؛ یعنی بهجای حذف کامل وابستگی یا برگرداندن null، یک شیء واقعی ولی «بدون رفتار» در اختیار برنامه قرار میدهد تا همهچیز همچنان بدون خطا به کار خود ادامه دهد.
صفحه 11
همانطور که کامپیوتر را میتوان از پریز برق جدا کرد، در دنیای نرمافزار هم به لطف Loose Coupling (وابستگی کم) میتوانیم یک پیادهسازی واقعی را با پیادهسازی دیگری که هیچ کاری انجام نمیدهد (Null Object) جایگزین کنیم، بدون اینکه مشکلی برای بقیهی برنامه به وجود بیاید.
اما این تنها مزیت Loose Coupling نیست.
فرض کنید در منطقهای زندگی میکنید که برق آن مرتب قطع و وصل میشود.
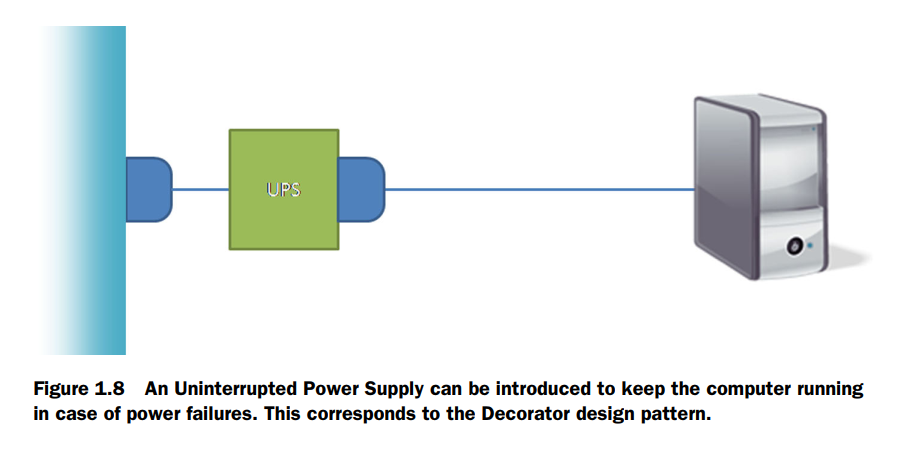
در چنین شرایطی، احتمالاً دوست دارید کامپیوترتان حتی هنگام قطع برق هم خاموش نشود.
برای این کار، همانطور که در شکل 1.8 کتاب نشان داده شده، یک UPS (منبع تغذیه بدون وقفه) بین پریز برق و کامپیوتر قرار میدهید.
یعنی:
-
خوب UPS را به پریز برق وصل میکنید.
-
سپس کامپیوتر را به UPS وصل میکنید.
به این ترتیب، اگر برق شهر قطع شود، UPS برای مدتی برق کامپیوتر را تأمین میکند.
جالب اینجاست که کامپیوتر و UPS هر کدام وظیفهی کاملاً متفاوتی دارند.
-
کامپیوتر وظیفهی اجرای برنامهها را بر عهده دارد.
-
خوب UPS فقط وظیفهی تأمین برق اضطراری را انجام میدهد.
هیچکدام وارد مسئولیت دیگری نمیشوند.
این دقیقاً همان چیزی است که در طراحی نرمافزار به آن میگوییم:
اصل مسئولیت واحد (Single Responsibility Principle یا SRP)
هر جزء فقط باید یک مسئولیت مشخص داشته باشد و نباید کارهای دیگر را هم انجام دهد.
از طرف دیگر، کامپیوتر و UPS معمولاً:
-
توسط دو شرکت مختلف ساخته میشوند،
-
در زمانهای متفاوت خریداری میشوند،
-
و حتی ممکن است در زمانهای مختلف به سیستم اضافه شوند.
همانطور که در شکل 1.6 دیدیم، کامپیوتر بدون UPS هم کاملاً قابل استفاده است.
از طرف دیگر، اگر برق قطع شود، حتی میتوانید سشوار را هم به UPS وصل کنید و از آن استفاده کنید.
یعنی UPS به وسیلهی خاصی وابسته نیست؛ فقط کافی است وسیله بتواند از همان استاندارد اتصال استفاده کند.
Decorator Pattern
==در طراحی نرمافزار، این ایده که یک پیادهسازی را با پیادهسازی دیگری از همان Interface احاطه کنیم و قابلیت جدیدی به آن اضافه کنیم، با نام الگوی Decorator شناخته میشود.==
به عبارت دیگر، بهجای اینکه کلاس اصلی را تغییر دهیم، یک لایهی جدید دور آن قرار میدهیم که قبل یا بعد از اجرای عملیات اصلی، رفتارهای جدیدی اضافه میکند.
درست مثل UPS که بین پریز و کامپیوتر قرار میگیرد.
کامپیوتر همان کامپیوتر قبلی است؛ اما حالا قابلیت جدیدی پیدا کرده است: کار کردن هنگام قطع برق.
در برنامهنویسی هم Decorator دقیقاً همین کار را انجام میدهد.
مزیت مهم Decorator این است که میتوانیم بهتدریج قابلیتهای جدید یا Cross-Cutting Concerns (مسائلی که در بخشهای مختلف برنامه مشترک هستند) را به برنامه اضافه کنیم، بدون اینکه مجبور باشیم مقدار زیادی از کدهای قبلی را بازنویسی یا تغییر دهیم.
نمونههایی از Cross-Cutting Concerns عبارتاند از:
-
Logging
-
Caching
-
Authorization
-
Validation
-
Retry Policy
-
Performance Monitoring
این قابلیتها معمولاً در بخشهای مختلف برنامه استفاده میشوند و Decorator یکی از بهترین روشهای اضافه کردن آنهاست.
Composite Pattern
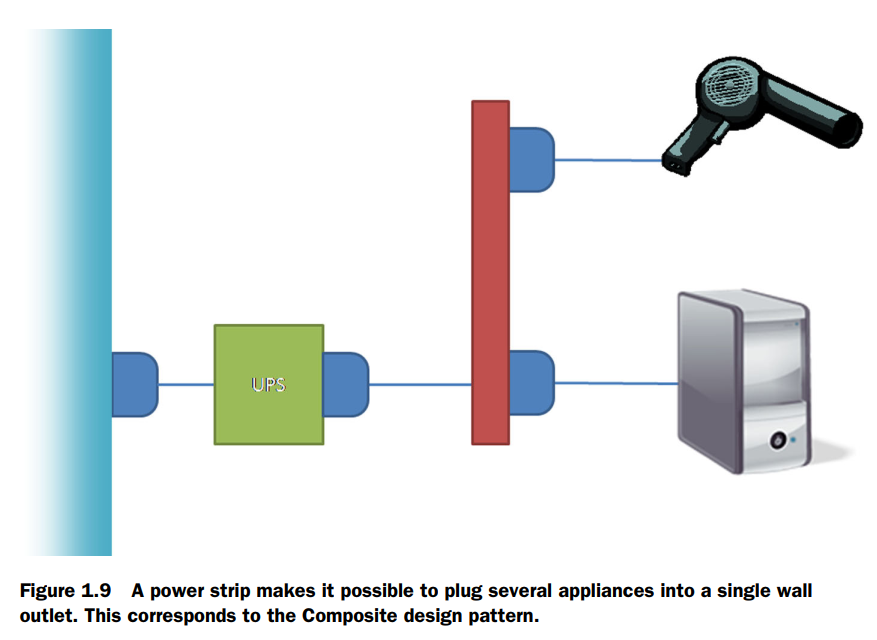
==یک راه دیگر برای اضافه کردن قابلیتهای جدید به برنامه این است که چندین پیادهسازی از یک Interface را با هم ترکیب کنیم.==
==وقتی چند پیادهسازی را در قالب یک شیء واحد کنار هم قرار میدهیم، از الگوی Composite استفاده کردهایم.==
نویسنده برای توضیح این الگو از مثال چندراهی برق (Power Strip) استفاده میکند.
همانطور که در شکل 1.9 نشان داده شده است:
-
چندراهی فقط یک دوشاخه دارد که به یک پریز وصل میشود.
-
اما خودش چندین پریز در اختیار ما قرار میدهد تا بتوانیم وسایل مختلفی را به آن متصل کنیم.
به همین دلیل، میتوانیم:
-
کامپیوتر را روشن نگه داریم،
-
همزمان سشوار را وصل یا جدا کنیم،
-
بدون اینکه روی عملکرد کامپیوتر تأثیری بگذارد.
در دنیای نرمافزار هم Composite Pattern همین ایده را پیاده میکند.
بهجای اینکه فقط یک پیادهسازی از Interface داشته باشیم، چندین پیادهسازی را در کنار هم قرار میدهیم تا همگی با هم کار کنند.
به این ترتیب، اضافه یا حذف کردن یک قابلیت جدید فقط به اضافه یا حذف کردن یکی از این پیادهسازیها محدود میشود و نیازی نیست بخشهای دیگر برنامه تغییر کنند.
نکتهی مهم
در این چند صفحه، نویسنده در واقع میخواهد یک پیام اصلی را منتقل کند:
وقتی اجزای برنامه از طریق Interfaceها به هم متصل باشند (Loose Coupling)، امکانات بسیار قدرتمندی به دست میآوریم؛ از جمله:
-
امکان جایگزین کردن یک پیادهسازی با پیادهسازی دیگر (Liskov Substitution Principle)
-
امکان استفاده از Null Object برای جلوگیری از
NullReferenceException -
امکان افزودن قابلیتهای جدید با Decorator
-
امکان ترکیب چندین پیادهسازی با Composite
-
و در نهایت، Dependency Injection ابزاری است که این نوع طراحی مبتنی بر Interface و Loose Coupling را در عمل امکانپذیر و مدیریتپذیر میکند.
ص12
یک مثال دیگر هم وجود دارد.
گاهی پیش میآید که دوشاخهی یک وسیله با پریز موجود سازگار نیست.
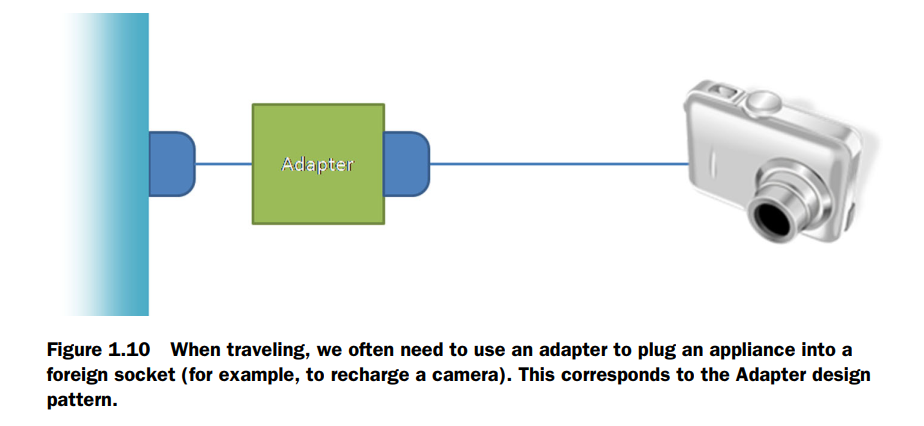
اگر تا به حال به کشور دیگری سفر کرده باشید، احتمالاً متوجه شدهاید که استاندارد پریزهای برق در کشورهای مختلف با هم فرق میکند.
مثلاً اگر دوربین عکاسی خودتان را، مثل شکل 1.10 کتاب، به یک کشور دیگر ببرید، احتمال زیادی وجود دارد که نتوانید شارژر آن را مستقیماً به پریز برق وصل کنید.
در چنین شرایطی به یک تبدیل برق (Adapter) نیاز دارید.
جالب اینجاست که در طراحی نرمافزار هم دقیقاً الگویی با همین نام وجود دارد.
Adapter Pattern
الگوی طراحی Adapter تقریباً دقیقاً همان کاری را انجام میدهد که یک تبدیل برق در دنیای واقعی انجام میدهد.
وظیفهی آن این است که دو Interface که از نظر مفهومی به هم مرتبط هستند اما با یکدیگر سازگار نیستند را به هم متصل کند.
به بیان ساده:
فرض کنید دو کلاس دارید که قرار است با هم کار کنند، اما Interfaceهای آنها با هم هماهنگ نیست.
بهجای اینکه یکی از آنها را تغییر دهید، یک کلاس واسط (Adapter) مینویسید که:
-
درخواستهای Interface اول را دریافت میکند،
-
آنها را به شکلی تبدیل میکند که Interface دوم متوجه شود،
-
و نتیجه را برمیگرداند.
درست مانند تبدیل برق که:
-
یک سمت آن با پریز کشور مقصد سازگار است،
-
سمت دیگر آن با دوشاخهی وسیلهی شما،
-
و باعث میشود بدون تغییر دادن نه پریز و نه شارژر، بتوانید از وسیلهتان استفاده کنید.
نویسنده با این مثال میخواهد نشان دهد که حتی در دنیای وسایل برقی هم مفاهیمی وجود دارند که شباهت زیادی به الگوهای طراحی (Design Patterns) در نرمافزار دارند.
تا اینجا چند نمونه را دیدهایم:
-
پریز برق (Socket) ⟶ معادل Interface
-
جایگزین کردن وسیلهها ⟶ Liskov Substitution Principle
-
جدا کردن وسیله از پریز ⟶ Null Object Pattern
-
قرار دادن UPS بین پریز و کامپیوتر ⟶ Decorator Pattern
-
استفاده از چندراهی برق ⟶ Composite Pattern
-
استفاده از تبدیل برق ⟶ Adapter Pattern
همهی این مثالها یک پیام مشترک دارند:
وقتی اتصال بین اجزا بر اساس یک قرارداد استاندارد (Interface) باشد، میتوانیم بدون تغییر دادن اجزای اصلی، آنها را جایگزین کنیم، توسعه دهیم، ترکیب کنیم یا با سیستمهای دیگر سازگار کنیم.
دقیقاً همین طرز فکر، پایه و اساس Dependency Injection و معماریهای مدرن نرمافزار است.
ص13 این الگو (Adapter) مخصوصاً زمانی خیلی مفید است که یک API یا کتابخانهی شخص ثالث (Third-Party API) در اختیار داشته باشید و بخواهید آن را به شکلی در برنامهی خود استفاده کنید که انگار یکی از پیادهسازیهای Interface مورد استفادهی برنامهی شماست.
به عبارت دیگر، برنامهی شما انتظار دارد با یک Interface مشخص کار کند، اما کتابخانهی خارجی از Interface دیگری استفاده میکند یا اصلاً Interface شما را پیادهسازی نکرده است. در این شرایط، Adapter بین این دو قرار میگیرد و آنها را با هم سازگار میکند، بدون اینکه لازم باشد کد برنامه یا کتابخانهی خارجی را تغییر دهید.
چیزی که دربارهی مدل پریز و دوشاخه واقعاً شگفتانگیز است این است که طی چندین دهه ثابت کرده مدلی ساده، کاربردی و بسیار انعطافپذیر است.
وقتی این زیرساخت یکبار ایجاد شود:
-
هر کسی میتواند از آن استفاده کند.
-
بهراحتی میتوان آن را با نیازهای جدید سازگار کرد.
-
حتی اگر در آینده نیازهایی به وجود بیاید که هنگام طراحی اولیه اصلاً قابل پیشبینی نبودهاند، باز هم این مدل پاسخگوی آنها خواهد بود.
نکتهی جالبتر این است که وقتی این مدل را با دنیای نرمافزار مقایسه میکنیم، میبینیم تمام اجزای آن از قبل در قالب اصول طراحی (Design Principles) و الگوهای طراحی (Design Patterns) وجود دارند.
به همین دلیل است که Loose Coupling (وابستگی کم) میتواند یک پروژهی نرمافزاری را بسیار قابل نگهداریتر (Maintainable) کند.
تا اینجا قسمت نسبتاً سادهی ماجرا بود.
اینکه بگوییم:
«به Interface برنامهنویسی کنید، نه به Implementation.»
اصل سختی نیست و تقریباً همهی برنامهنویسها با آن موافق هستند.
اما سؤال اصلی اینجاست:
اگر قرار نیست مستقیماً از کلاسهای واقعی (Concrete Classes) استفاده کنیم، پس نمونههای (Instance) موردنیازمان از کجا به دست میآیند؟
در واقع، میتوان گفت کل این کتاب قرار است به همین سؤال پاسخ بدهد.
شما نمیتوانید از یک Interface همانطور نمونه بسازید که از یک کلاس معمولی نمونه میسازید.
مثلاً چنین کدی اصلاً کامپایل نمیشود:
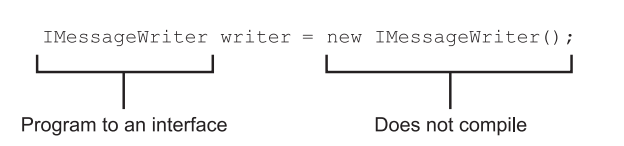
IWriter writer = new IWriter();دلیلش واضح است.
یک Interface هیچ Constructorی ندارد؛ بنابراین امکان ساختن نمونه از آن وجود ندارد.
پس شیء writer باید به روش دیگری ایجاد شود.
و دقیقاً اینجاست که Dependency Injection (DI) وارد عمل میشود و این مشکل را حل میکند.
حالا که هدف اصلی DI را بهصورت کلی شناختید، نویسنده معتقد است آمادهی دیدن اولین مثال هستید.
1.2 سلام DI (Hello DI)
طبق سنت تقریباً تمام کتابهای برنامهنویسی، بیایید یک برنامهی بسیار سادهی Console را بررسی کنیم که فقط عبارت:
Hello DI!
را روی صفحه نمایش چاپ میکند.
در این بخش، نویسنده:
-
کد این برنامه را نشان میدهد.
-
بهصورت خلاصه چند مورد از مهمترین مزایای DI را معرفی میکند.
-
اما هنوز وارد جزئیات نمیشود.
جزئیات کامل در فصلهای بعدی کتاب بررسی خواهند شد.
1.2.1 کد Hello DI
احتمالاً به مثالهای Hello World عادت کردهاید؛ مثالهایی که معمولاً فقط از یک خط کد تشکیل شدهاند.
اما این بار نویسنده برعکس عمل میکند.
او یک برنامهی فوقالعاده ساده را عمداً کمی پیچیدهتر میکند.
چرا؟
کمی بعد دلیلش را خواهید فهمید.
فعلاً فقط میخواهیم ببینیم اگر همین برنامهی ساده را با استفاده از Dependency Injection بنویسیم، چه شکلی خواهد داشت.
کلاسهای همکار (Collaborators)
برای اینکه ساختار کلی برنامه را بهتر درک کنیم، ابتدا متد Main برنامهی Console را بررسی میکنیم.
بعد از آن، نویسنده کلاسهایی را نشان میدهد که با یکدیگر همکاری میکنند (Collaborating Classes) تا این برنامه اجرا شود.
این اولین مثال واقعی کتاب است که نشان میدهد اجزای مختلف یک برنامه چگونه با استفاده از Dependency Injection و وابستگی کم (Loose Coupling) در کنار هم قرار میگیرند.
private static void Main()
 {
 IMessageWriter writer = new ConsoleMessageWriter();
var salutation = new Salutation(writer);  salutation.Exclaim();
   }
صفحه 14
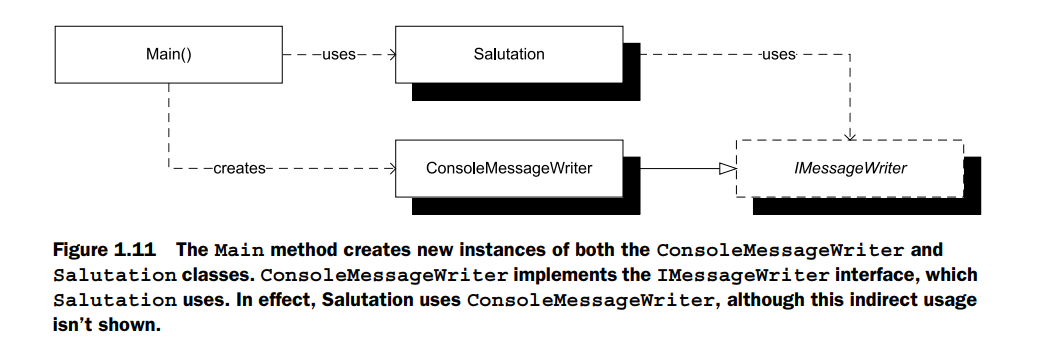
برنامه باید متنی را در کنسول نمایش دهد، بنابراین یک نمونه از کلاس ConsoleMessageWriter ایجاد میکند که دقیقاً مسئول همین کار است.
سپس آن شیء MessageWriter را به کلاس Salutation میدهد تا نمونهی Salutation بداند پیامهایش را کجا باید نمایش دهد.
حالا که همهچیز بهدرستی به هم متصل شده است، میتوان منطق برنامه را اجرا کرد و در نتیجه، پیام روی صفحهی نمایش نوشته میشود.
شکل 1.11 رابطهی بین این کلاسهای همکار (Collaborators) را نشان میدهد.
منطق اصلی برنامه داخل کلاس Salutation قرار گرفته است که در لیست (Listing) بعدی نمایش داده شده است.
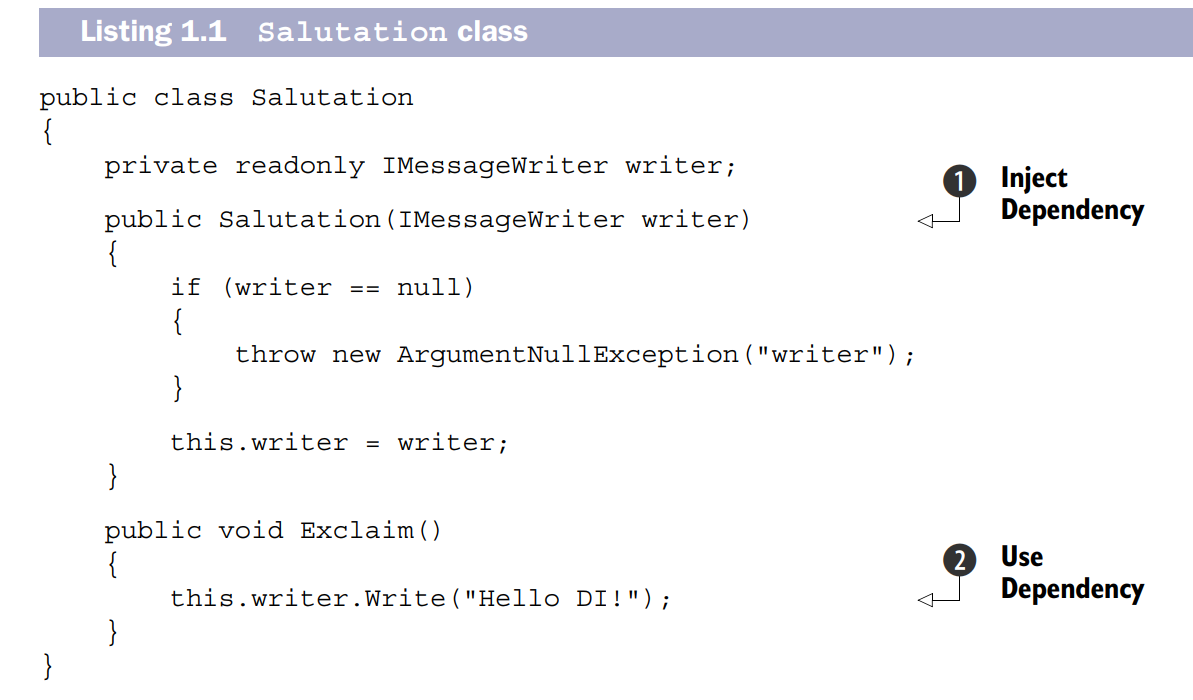
کلاس Salutation به یک Interface سفارشی به نام IMessageWriter وابسته است و یک نمونه از آن را از طریق Constructor خود درخواست میکند. این روش Constructor Injection نام دارد و در فصل ۴ بهطور مفصل توضیح داده میشود. همچنین در آن فصل، یک مثال مشابه نیز بهصورت گامبهگام بررسی شده است.
نمونهی IMessageWriter بعداً در پیادهسازی متد Exclaim استفاده میشود تا پیام موردنظر را در Dependency بنویسد.
اینترفیس IMessageWriter یه اینترفیس سادهست که دقیقاً برای همین سناریو تعریف شده:
ص15
C#
public interface IMessageWriter
{
    void Write(string message);
}میتونست اعضای دیگهای هم داشته باشه، ولی تو این مثال ساده فقط به متد Write نیاز داری. کلاس ConsoleMessageWriter این اینترفیس رو پیادهسازی میکنه و متد Main اون رو به کلاس Salutation پاس میده:
C#
public class ConsoleMessageWriter : IMessageWriter
{
    public void Write(string message)
    {
        Console.WriteLine(message);
    }
}
کلاس ConsoleMessageWriter با دربرگرفتن (Wrap کردن) کلاس Console از کتابخونه پایه داتنت (BCL)، اینترفیس IMessageWriter رو پیادهسازی میکنه. این یه کاربرد خیلی ساده از الگوی طراحی Adapter هست که تو بخش ۱.۱.۲ دربارهاش حرف زدیم.
شاید پیش خودت بگی جایگزین کردن یه خط کد با دو تا کلاس و یه اینترفیس که روی هم میشن ۱۱ خط، چه فایدهای داره؟ و البته حق هم داری. اما این کار کلی مزایا برامون به همراه داره.
۱.۲.۲ مزایای DI
مثال قبلی چطور از همون یه خط کد معمولی که همیشه برای نوشتن Hello World توC استفاده میکنیم بهتره؟ تو این مثال، DI باعث ایجاد یه سربار (Overhead) ۱۱۰۰ درصدی میشه، اما وقتی پیچیدگی کار از یه خط کد به دهها هزار خط میرسه، این سربار کمکم محو میشه و کلاً به چشم نمیاد. فصل ۲ یه مثال پیچیدهتر از کاربرد DI رو نشون میده؛ و با اینکه اون مثال هم در مقایسه با پروژههای واقعی هنوز خیلی سادهست، اما متوجه میشی که DI اونجا خیلی کمتر دستوپاگیره.
اصلاً سرزنشت نمیکنم اگه فکر کنی تو مثال قبلی DI بیش از حد مهندسی شده (Over-engineered) بود، ولی این رو در نظر بگیر: مثال کلاسیک Hello World ذاتاً یه مسئله سادهست که نیازمندیهاش کاملاً مشخص و محدوده. تو دنیای واقعی، توسعه نرمافزار هیچوقت اینطوری نیست. نیازمندیها مدام تغییر میکنن و معمولاً گنگ و نامشخصن. فیچرهایی هم که باید پیادهسازی کنی معمولاً خیلی پیچیدهتر از این حرفان. الگوی DI با ایجاد وابستگیِ کم (Loose Coupling)، به حل اینجور مشکلات کمک میکنه. بهطور خاص، ما به مزایایی میرسیم که تو جدول ۱.۱ لیست شده.
تو جدول ۱.۱، من مزیت Late Binding (اتصال دیرهنگام) رو اولِ همه آوردم، چون طبق تجربهام، این همون چیزیه که تو ذهن اکثر آدما پررنگتره. وقتی معماران نرمافزار و برنامهنویسها نمیتونن مزایای Loose Coupling رو درک کنن، احتمالاً دلیلش اینه که هیچوقت به بقیه مزایاش فکر نکردن.
LATE BINDING (اتصال دیرهنگام)
وقتی مزایای برنامهنویسی مبتنی بر اینترفیس و DI رو توضیح میدم، قابلیت جایگزین کردن یه سرویس با یه سرویس دیگه، برای اکثر آدما بارزترین مزیت به حساب میاد؛ به همین خاطر، اونا معمولاً مزایا و معایب رو فقط با در نظر گرفتن همین یه مورد سبکسنگین میکنن.
ص16 یادت میاد گفتم قبل از اینکه بتونی یاد بگیری، باید یه سری چیزا رو از ذهنت پاک کنی (Unlearn کنی)؟ شاید بگی نیازمندیهای پروژهات رو انقدر خوب میشناسی که مطمئنی هیچوقت مجبور نمیشی مثلاً دیتابیس SQL Server خودت رو با یه چیز دیگه عوض کنی. اما خب، نیازمندیها تغییر میکنن.
جدول ۱.۱ مزایای به دست اومده از وابستگی کم (Loose Coupling). هر مزیت همیشه در دسترسه اما بسته به شرایط، ارزش متفاوتی داره.
| مزیت | توضیحات | کِی ارزشمنده؟ |
|---|---|---|
| اتصال دیرهنگام (Late binding) | میشه سرویسها رو با سرویسهای دیگه جابهجا کرد. | تو نرمافزارهای استاندارد ارزشمنده، ولی شاید تو برنامههای سازمانی (Enterprise) که محیط اجراییشون معمولاً کاملاً مشخصه، کمتر به چشم بیاد. |
| توسعهپذیری (Extensibility) | میشه کد رو تو مسیرهایی که از قبل براش برنامهریزی نشده بود، گسترش داد و دوباره ازش استفاده کرد. | همیشه ارزشمنده. |
| توسعه موازی (Parallel development) | میشه کد رو به صورت موازی (توسط چند نفر یا تیم) توسعه داد. | تو برنامههای بزرگ و پیچیده ارزشمنده؛ تو برنامههای کوچیک و ساده نه خیلی. |
| نگهداریپذیری (Maintainability) | نگهداری کلاسهایی که وظایفشون به روشنی تعریف شده، آسونتره. | همیشه ارزشمنده. |
| آزمونپذیری (TESTABILITY) | میشه برای کلاسها Unit Test نوشت. | فقط در صورتی ارزشمنده که Unit Test بنویسی (که واقعاً، واقعاً باید بنویسی!). |
NoSQL، Windows Azure، و بحثِ ترکیبپذیری (Composability)
سالها پیش، وقتی سعی میکردم برنامهنویسها و معماران نرمافزار رو راجع به مزایای DI متقاعد کنم، معمولاً با یه نگاه مات و مبهوت روبهرو میشدم. «خب، فرض کنیم میتونی کامپوننت دسترسی به دیتای رابطهای (Relational) رو با یه چیز دیگه عوض کنی. که چی؟ مگه اصلاً جایگزینی برای دیتابیسهای رابطهای وجود داره؟»
فایلهای XML هیچوقت تو سناریوهای سازمانی با مقیاسپذیری بالا، جایگزین قانعکنندهای به نظر نمیرسیدن. اما این موضوع تو چند سال اخیر به شدت تغییر کرده.
سرویس Windows Azure تو رویداد PDC سال ۲۰۰۸ معرفی شد و تونست حتی سازمانهای به شدت متعصب و وفادار به مایکروسافت رو هم متقاعد کنه تا تو بحث ذخیرهسازی دادهها، تو مواضع خودشون تجدید نظر کنن. الان دیگه یه جایگزین واقعی برای دیتابیسهای رابطهای وجود داره، و من فقط کافیه بپرسم که آیا افراد میخوان برنامهشون «آماده برای کلاد» (Cloud-ready) باشه یا نه. حالا دیگه دلیلِ جایگزین کردن، خیلی محکمتر شده.
یه جنبش مرتبط دیگه رو هم میشه تو کل مفهوم NoSQL دید که برنامهها رو حول محور دادههای غیرنرمالشده (Denormalized) مدلسازی میکنه — معمولاً دیتابیسهای داکیومنتمحور، ولی مفاهیمی مثل Event Sourcing هم دارن روز به روز مهمتر میشن.
ص17
تو بخش ۱.۲.۱، تو از اتصال دیرهنگام (Late Binding) استفاده نکردی، چون صراحتاً با هاردکد کردنِ ساختِ یه ConsoleMessageWriter جدید، یه نمونه (Instance) از IMessageWriter ساختی.
…اما میتونی با تغییر دادن فقط یه بخش کوچیک از کد، اتصال دیرهنگام (Late Binding) رو به برنامهات اضافه کنی. فقط کافیه این خط کد رو تغییر بدی:
C#
IMessageWriter writer = new ConsoleMessageWriter();برای فعال کردن late binding، میتونی اون خط کد رو با یه چیزی شبیه به این جایگزین کنی:
C#
var typeName = ConfigurationManager.AppSettings["messageWriter"];
var type = Type.GetType(typeName, true);
IMessageWriter writer = (IMessageWriter)Activator.CreateInstance(type);این ها رو خودم نوشتم : اینجا اون قسمتی که نوشته messageWriter اون داره به app setting اشاره میکنه ما اونجا key رو برابر با این مقدار گذاشتیم
value="Ploeh.Samples.HelloDI.CommandLine.ConsoleMessageWriter,HelloDI" />
حالا میرسیم به این بخش Ploeh.Samples.HelloDI.CommandLine.ConsoleMessageWriter داره که این رو به صورت string داره برمیگردونه میریزه توی type name و اون HelloDI هم داره assembly name یا فایل dll یا Exe رو نشون میده
-
بخش اول (قبل از کاما): نام کامل کلاس به همراه تمام فضاهای نام (Namespace). داتنت با این بخش متوجه میشود که دقیقاً باید چه کلاسی را نمونهسازی کند.
-
بخش دوم (بعد از کاما): نام اسمبلی (
HelloDI). داتنت با این بخش متوجه میشود که این کلاس را در کدام فایل باید جستجو کند.
چرا نوشتن HelloDI (اسم اسمبلی) الزامی است؟
وقتی شما از متد Type.GetType() استفاده میکنید، موتور داتنت بهصورت پیشفرض فقط داخل دو جا را میگردد:
-
فایلی که در حال حاضر دارد کدها را اجرا میکند (Executing Assembly).
-
فایلهای هسته خود داتنت (مثل
mscorlib).
اگر کلاس ConsoleMessageWriter داخل یک پروژه یا فایل DLL مجزا به نام HelloDI.dll نوشته شده باشد و شما بعد از کاما اسم آن را نیاورید، داتنت نمیتواند آن را پیدا کند و برنامه کرش میکند (خطای null یا TypeLoadException میدهد).
var type = Type.GetType(typeName, true);
این مرحله، موتور داتنت (CLR) متن رشته رو میگیره و در بین Assemblyهای لود شده میگرده تا اون کلاس رو پیدا کنه.
-
خروجی این خط یک شیء از جنس
Typeاست که تمام اطلاعات مربوط به اون کلاس (متدها، پراپرتیها، سازندهها و…) رو تو خودش داره. -
پارامتر
trueبه این معنیه که اگر داتنت نتونست این کلاس رو پیدا کنه، برنامه یک خطا (Exception) پرتاب کنه تا متوجه بشیم آدرس توی کانفیگ اشتباهه.
public interface IMessageWriter
{
    void Write(string message);
}

public class ConsoleMessageWriter : IMessageWriter
{
    public void Write(string message)
    {
        Console.WriteLine(message);
    }
}
ساختن نمونه (Instance) به صورت پویا
C#
Activator.CreateInstance(type);
کلاس Activator ابزاری برای ساختن اشیاء در زمان اجراست. وقتی متد CreateInstance رو صدا میزنید، داتنت به کمک Reflection، متد سازنده (Constructor) پیشفرضِ اون کلاسی که در مرحله قبل پیدا کرده بود رو اجرا میکنه. خروجی این متد یک شیء از نوع پایه object است.
تبدیل نوع (Casting) به اینترفیس
C#
IMessageWriter writer = (IMessageWriter)...
از اونجایی که Activator یک object ساده برمیگردونه، کامپایلر نمیدونه که آیا این شیء متدهای مورد نیاز شما رو داره یا نه. با عمل Casting (IMessageWriter)، شما به کامپایلر میگید: “من مطمئنم شیئی که ساخته شده، قرارداد IMessageWriter رو پیادهسازی کرده. پس باهاش مثل یک IMessageWriter رفتار کن.”
اینترفیسها (مثل IMessageWriter) فقط یک «قرارداد» یا «لیست اسامی متدها» هستند و هیچ کد اجرایی درون آنها وجود ندارد.
اما راز کار کردن این خط کد در یک نکته مهم نهفته است: کلاسِ Activator اصلاً اینترفیس را نمیسازد!
بیایید ببینیم دقیقاً چه اتفاقی میافتد:
۱. ما داریم کلاس واقعی را میسازیم، نه اینترفیس را
اگر یادتان باشد در فایل کانفیگ نوشته بودیم: value="Ploeh.Samples.HelloDI.CommandLine.ConsoleMessageWriter,HelloDI"
این آدرس، متعلق به یک کلاس واقعی (Concrete Class) است، نه یک اینترفیس. وقتی متغیر type مقداردهی میشود، حامل نقشه ساخت کلاس ConsoleMessageWriter است که تمام کدهای متد Write درون آن نوشته شده است.
پس وقتی میگوییم:
C#
Activator.CreateInstance(type);
داتنت میرود و یک نمونهی کامل، واقعی و قابل اجرا از کلاس ConsoleMessageWriter در حافظه (RAM) میسازد. این شیء ساخته شده، پوسته توخالی نیست؛ بلکه تمام کدهای اجرایی را با خودش دارد.
۲. نقش اینترفیس این وسط چیست؟ (مثال تلویزیون و کنترل)
حالا که شیء واقعی ساخته شده، به خط بعدی میرسیم:
C#
IMessageWriter writer = (IMessageWriter)Activator.CreateInstance(type);
برای درک این خط، مثال تلویزیون و کنترل از راه دور را تصور کنید:
-
کلاس واقعی (
ConsoleMessageWriter): مثل خود تلویزیون است. قطعات، سیمکشیها و کدهای اجرایی دارد و کار اصلی را انجام میدهد (تولید تصویر و صدا). -
اینترفیس (
IMessageWriter): مثل کنترل از راه دور است. فقط تعدادی دکمه (اسم متدها) روی آن است و هیچ سیمی داخلش نیست.
در این خط کد، Activator تلویزیون را در حافظه میسازد. سپس با استفاده از (IMessageWriter)، ما یک کنترل از راه دور برمیداریم و آن را با این تلویزیون جُفت (Bind) میکنیم.
نتیجهگیری
وقتی در خطوط بعدیِ برنامه، شما کدی مثل این مینویسید:
C#
writer.Write("Hello World!");
شما در واقع دارید دکمه روی کنترل از راه دور (اینترفیس) را فشار میدهید. چون این کنترل به آن تلویزیون واقعی در حافظه متصل است، کدی که در نهایت اجرا میشود، کدی است که درون کلاس ConsoleMessageWriter نوشته شده است.
فایده این کار چیست؟ کد شما فقط دکمههای کنترل (اینترفیس) را میشناسد و با آنها کار میکند. برای کد شما اصلاً مهم نیست که آن طرف، تلویزیونِ سامسونگ (ConsoleMessageWriter) قرار دارد یا تلویزیونِ الجی (DatabaseMessageWriter). این دقیقاً همان مفهوم پلیمورفیسم (چندریختی) و دلیل اصلی استفاده از اینترفیسهاست!
با خوندن اسم تایپ از فایل کانفیگ برنامه و ساختن یه نمونه از کلاس Type با استفاده از اون، میتونی از Reflection استفاده کنی تا بدون اینکه نیازی باشه نوع دقیق کلاس (Concrete Type) رو زمان کامپایل بدونی، یه نمونه از IMessageWriter بسازی.
برای اینکه این کار جواب بده، باید اسم تایپ رو تو تنظیمات messageWriter تو فایل کانفیگ برنامه مشخص کنی:
XML
<appSettings>
    <add key="messageWriter" value="Ploeh.Samples.HelloDI.CommandLine.ConsoleMessageWriter,HelloDI" />
</appSettings>
هشدار: این مثال برای رسوندن مطلب، یه سری میانبرها رو طی کرده. در واقع، این کد دچار آنتیپترنِ CONSTRAINED CONSTRUCTION (ساخت محدود) هست که تو فصل ۵ به طور مفصل دربارهاش صحبت میکنیم.
وابستگی کم (Loose Coupling) امکان late binding رو فراهم میکنه، چون فقط یه جای مشخص وجود داره که توش نمونه IMessageWriter رو میسازی. از اونجایی که کلاس Salutation منحصراً با اینترفیس IMessageWriter کار میکنه، اصلاً متوجه این تغییر و تفاوت نمیشه.
تو مثال Hello DI، قابلیت late binding بهت این امکان رو میده که پیام رو تو یه مقصد دیگه به غیر از کنسول بنویسی — مثلاً تو یه دیتابیس یا یه فایل. اضافه کردن همچین فیچرهایی ممکنه، حتی اگه از قبل به طور صریح براشون برنامهریزی نکرده باشی.
توسعهپذیری (EXTENSIBILITY)
یه نرمافزار موفق باید بتونه تغییر کنه. تو نیاز داری فیچرهای جدید اضافه کنی و فیچرهای فعلی رو گسترش بدی. وابستگی کم بهمون این امکان رو میده که برنامه رو خیلی راحت از نو سرهم کنیم (Recompose)؛ دقیقاً مثل همون کاری که با استفاده از دوشاخه و پریز برای وصل کردنِ وسایل برقی انجام میدیم.
فرض کن میخوای مثال Hello DI رو امنتر کنی، طوری که فقط کاربرای احراز هویت شده (Authenticated) بتونن پیام بنویسن. لیستینگ بعدی نشون میده چطور میتونی این فیچر رو بدون دست زدن به هیچکدوم از فیچرهای موجود اضافه کنی: کافیه یه پیادهسازی جدید از اینترفیس IMessageWriter اضافه کنی.
راهنمایی هایی که از هوش مصنوعی گرفتم باید خلاصه شود
https://gemini.google.com/app/540cf95675cd1a16
https://gemini.google.com/app/98970c1145ffae03
و با شکل بنویسمشون
یا توضیحشون بدم :
ص18
لیست 1.2 توسعه برنامه Hello DI با اضافه کردن قابلیت امنیتی
public class SecureMessageWriter : IMessageWriter
{
private readonly IMessageWriter writer;

public SecureMessageWriter(IMessageWriter writer)
{
    if (writer == null)
    {
        throw new ArgumentNullException("writer");
    }
    this.writer = writer;
}
public void Write(string message)
{
    if (Thread.CurrentPrincipal.Identity
        .IsAuthenticated)
    {
        this.writer.Write(message);
    }
}
}
کلاس SecureMessageWriter اینترفیس IMessageWriter را پیادهسازی میکند و در عین حال خودش هم به همین اینترفیس وابسته است؛ یعنی با استفاده از Constructor Injection یک نمونه از IMessageWriter را از طریق سازنده دریافت میکند.
این دقیقاً یک پیادهسازی استاندارد از الگوی طراحی Decorator است که در بخش 1.1.2 به آن اشاره کردم. در فصل 9 خیلی مفصلتر درباره Decorator صحبت خواهیم کرد.
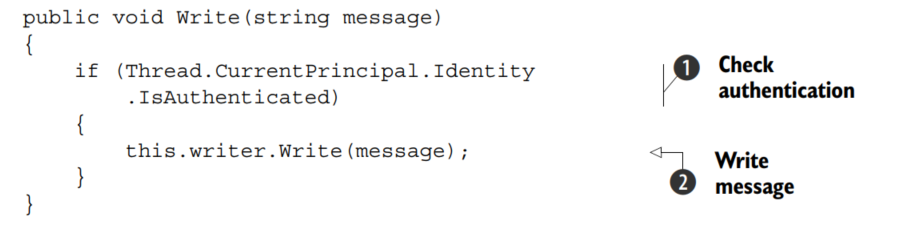
متد Write ابتدا بررسی میکند که آیا کاربر فعلی احراز هویت شده است یا نه بخش 1 . فقط در صورتی که کاربر احراز هویت شده باشد، متد Write شیء تزئینشده (writer) را فراخوانی میکند (بخش 2) تا پیام نوشته شود.
نکته: متد
Writeدر لیست 1.2 از طریق یک Ambient Context به اطلاعات کاربر فعلی دسترسی پیدا میکند. یک روش منعطفتر، اما کمی پیچیدهتر، این بود که اطلاعات کاربر نیز از طریق Constructor Injection به کلاس تزریق شود.
تنها جایی که لازم است کدهای قبلی را تغییر دهید، متد Main است، چون حالا باید کلاسهای موجود را به شکل متفاوتی کنار هم قرار دهید:
IMessageWriter writer =
    new SecureMessageWriter(
        new ConsoleMessageWriter());
توجه کنید که نمونهی قبلی ConsoleMessageWriter را با کلاس جدید SecureMessageWriter تزئین کردهاید.
منظورش از قبلیه اینه :
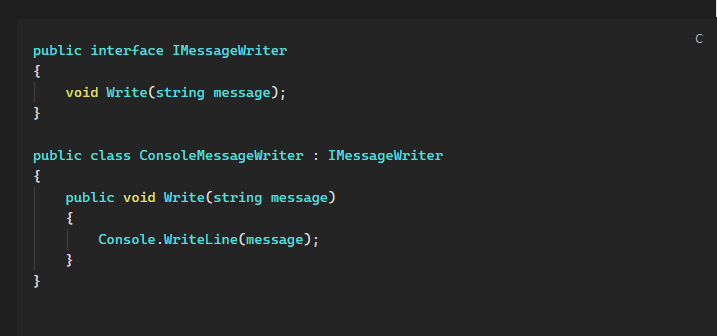
باز هم کلاس Salutation هیچ تغییری نکرده است، چون فقط با اینترفیس IMessageWriter کار میکند.
خوب Loose Coupling این امکان را فراهم میکند که کدی بنویسید که برای توسعه باز باشد، اما برای تغییر بسته باشد. به این اصل، Open/Closed Principle گفته میشود.
تنها جایی که لازم است کد را تغییر دهید، نقطه ورود برنامه (Entry Point) است؛ به این قسمت Composition Root گفته میشود.
کلاس SecureMessageWriter مسئول پیادهسازی قابلیتهای امنیتی برنامه است، در حالی که ConsoleMessageWriter مسئول رابط کاربری است.
این جداسازی باعث میشود بتوانید این دو بخش را مستقل از یکدیگر تغییر دهید و در صورت نیاز، آنها را به هر شکلی که میخواهید با هم ترکیب کنید.
ص19
توسعهی موازی (PARALLEL DEVELOPMENT)
جدا کردن مسئولیتها (Separation of Concerns) این امکان را فراهم میکند که کد را بهصورت موازی و توسط تیمهای مختلف توسعه دهیم. وقتی یک پروژهی توسعهی نرمافزار به اندازهی مشخصی بزرگ میشود، لازم است تیم توسعه را به چند تیم با اندازهی قابلمدیریت تقسیم کنیم. هر تیم مسئولیت بخشی از کل برنامه را بر عهده میگیرد.
برای مشخص کردن مرز مسئولیتها، هر تیم یک یا چند ماژول توسعه میدهد که در نهایت باید در برنامهی نهایی با یکدیگر یکپارچه شوند. مگر اینکه بخشهای تحت مسئولیت هر تیم کاملاً مستقل از هم باشند، احتمالاً بعضی از تیمها به قابلیتهایی که توسط تیمهای دیگر توسعه داده شدهاند وابسته خواهند بود.
در مثال بالا، چون کلاسهای SecureMessageWriter و ConsoleMessageWriter مستقیماً به یکدیگر وابسته نیستند، میتوانستند توسط تیمهای جداگانه و بهصورت موازی توسعه داده شوند. تنها چیزی که لازم بود این دو تیم دربارهی آن به توافق برسند، Interface مشترک IMessageWriter بود.
قابلیت نگهداری (MAINTAINABILITY)
هرچه مسئولیت هر کلاس واضحتر و محدودتر شود، نگهداری کل برنامه نیز آسانتر میشود. این یکی از مزایای شناختهشدهی اصل مسئولیت واحد (SINGLE RESPONSIBILITY PRINCIPLE) است که میگوید هر کلاس باید فقط یک مسئولیت داشته باشد.
اضافه کردن قابلیتهای جدید به یک برنامه نیز سادهتر میشود، چون مشخص است تغییرات باید در کجا اعمال شوند. در بیشتر مواقع، حتی نیازی نداریم کدهای موجود را تغییر دهیم؛ در عوض میتوانیم کلاسهای جدیدی اضافه کنیم و برنامه را دوباره با ترکیب آنها بسازیم. این همان اصل باز/بسته (OPEN/CLOSED PRINCIPLE) است که دوباره در عمل مشاهده میشود.
عیبیابی (Troubleshooting) نیز معمولاً آسانتر و کمدردسرتر میشود، چون محدودهی عواملی که احتمال دارد باعث مشکل شده باشند کوچکتر میشود. وقتی مسئولیتها بهوضوح تعریف شده باشند، معمولاً ایدهی خوبی دارید که برای پیدا کردن علت اصلی مشکل، جستوجو را از کجا شروع کنید.
قابلیت تستپذیری (TESTABILITY)
برای بعضی افراد، TESTABILITY کماهمیتترین نگرانی است؛ برای بعضی دیگر، یک نیاز کاملاً ضروری محسوب میشود. شخصاً من در دستهی دوم قرار میگیرم: در طول دوران کاریام، چند پیشنهاد شغلی را رد کردهام، چون شامل کار کردن با محصولاتی میشدند که TESTABLE نبودند.
تعریف: یک برنامه زمانی TESTABLE در نظر گرفته میشود که بتوان آن را با Unit Test تست کرد.
مزیت TESTABILITY شاید بحثبرانگیزترین مورد در میان مزایایی باشد که تا اینجا فهرست کردهام. بسیاری از برنامهنویسان و معماران نرمافزار Unit Testing انجام نمیدهند، بنابراین در بهترین حالت این مزیت را برای خودشان بیاهمیت میدانند. در مقابل، افرادی مثل من آن را یک ضرورت میدانند. حتی Michael Feathers اصطلاح Legacy Application را برای هر برنامهای تعریف میکند که تحت پوشش Unit Testها نباشد.
تقریباً بهصورت اتفاقی، Loose Coupling امکان Unit Testing را فراهم میکند، چون مصرفکنندگان (Consumers) از اصل جایگزینی لیسکوف (LISKOV SUBSTITUTION PRINCIPLE) پیروی میکنند: برای آنها مهم نیست که Dependencyهایشان از چه نوع Concreteای هستند. این یعنی میتوانیم Test Doubleها را به System Under Test (SUT) تزریق کنیم، همانطور که در Listing 1.3 خواهیم دید.
توانایی جایگزین کردن Dependencyهای موردنظر با جایگزینهایی که مخصوص تست هستند، محصول جانبی Loose Coupling است؛ اما من تصمیم گرفتهام آن را بهعنوان یک مزیت جداگانه فهرست کنم، چون ارزشی که از آن به دست میآید متفاوت است.
ص20
قابلیت تستپذیری (TESTABILITY)
اصطلاح TESTABLE بهشدت مبهم و غیردقیق است، با این حال در جامعهی توسعهی نرمافزار بسیار رایج است؛ بهخصوص در میان افرادی که Unit Testing انجام میدهند.
در اصل، هر برنامهای را میتوان با امتحان کردن آن تست کرد. تستها میتوانند توسط افراد و از طریق رابط کاربری برنامه یا هر رابط دیگری که برنامه در اختیارشان قرار میدهد، انجام شوند. چنین تستهای دستیای زمانبر و پرهزینه هستند، بنابراین تست خودکار (Automated Testing) بسیار ترجیح داده میشود.
انواع مختلفی از تستهای خودکار وجود دارد، مانند Unit Testing، Integration Testing، Performance Testing، Stress Testing و موارد دیگر. از آنجا که Unit Testing به محیط اجرای خاصی نیاز ندارد، معمولاً کارآمدترین و قابلاعتمادترین نوع تست محسوب میشود؛ به همین دلیل، اغلب TESTABILITY در همین زمینه ارزیابی میشود.
خوب Unit Testها بازخورد سریعی دربارهی وضعیت یک برنامه ارائه میدهند، اما نوشتن Unit Test فقط زمانی امکانپذیر است که Unit موردنظر بتواند بهدرستی از Dependencyهای خودش جدا شود. دربارهی اینکه یک Unit دقیقاً تا چه اندازه باید کوچک یا بزرگ باشد، کمی ابهام وجود دارد، اما همه موافقاند که یک Unit قطعاً چیزی نیست که چندین ماژول را دربر بگیرد. توانایی تست کردن ماژولها بهصورت مستقل از یکدیگر، در Unit Testing بسیار مهم است.
فقط زمانی که یک برنامه قابلیت انجام Unit Testing را داشته باشد، آن برنامه TESTABLE در نظر گرفته میشود. مطمئنترین راه برای اطمینان از TESTABILITY این است که برنامه را با استفاده از Test-Driven Development (TDD) توسعه دهیم.
البته باید توجه داشت که Unit Testها بهتنهایی تضمین نمیکنند که یک برنامه بهدرستی کار میکند. همچنان به Full System Testها یا انواع دیگری از تستها که در فاصلهی بین این دو قرار میگیرند نیاز داریم تا بررسی و تأیید کنیم که آیا برنامه همانطور که انتظار میرود کار میکند یا خیر.
بسته به نوع برنامهای که در حال توسعهی آن هستم، ممکن است قابلیت Late Binding برایم مهم باشد یا نباشد، اما TESTABILITY همیشه برایم مهم است.
بعضی از برنامهنویسان به TESTABILITY اهمیت نمیدهند، اما قابلیت Late Binding را برای برنامهای که در حال توسعهی آن هستند، مهم میدانند.
Test Doubles
یک روش رایج این است که برای Dependencyها، پیادهسازیهایی ایجاد کنیم که بهجای پیادهسازیهای واقعی یا موردنظر عمل کنند. به چنین پیادهسازیهایی Test Double گفته میشود و این پیادهسازیها هرگز در برنامهی نهایی استفاده نخواهند شد.
در عوض، زمانی که استفاده از Dependencyهای واقعی امکانپذیر نیست یا مطلوب نیست، Test Doubleها بهعنوان جایگزین موقت (Placeholder) برای آنها عمل میکنند.
در مورد Test Doubleها یک زبان الگوی کامل (Pattern Language) وجود دارد و انواع مختلفی از آنها نیز وجود دارند، مانند Stub، Mock و Fake.
ص21
مثال: Unit Testing منطق «Hello»
در بخش 1.2.1، یک مثال از Hello DI دیدید. با اینکه من ابتدا کد نهایی را به شما نشان دادم، در واقع آن را با استفاده از TDD (Test-Driven Development) توسعه دادم. در Listing 1.3 مهمترین Unit Test را مشاهده میکنید.
نکته: اگر تجربهای در زمینهی Unit Testing یا Dynamic Mockها ندارید، نگران نباشید. این مفاهیم گاهی در طول کتاب مطرح خواهند شد، اما به هیچ وجه پیشنیاز خواندن این کتاب نیستند.
[Fact]
public void ExclaimWillWriteCorrectMessageToMessageWriter()
{
    var writerMock = new Mock<IMessageWriter>();
    var sut = new Salutation(writerMock.Object);
    sut.Exclaim();
    writerMock.Verify(w => w.Write("Hello DI!"));
}
کلاس Salutation به یک نمونه از Interface به نام IMessageWriter نیاز دارد، بنابراین باید یکی ایجاد کنید.
میتوانید از هر پیادهسازیای استفاده کنید، اما در Unit Testها یک Dynamic Mock میتواند بسیار مفید باشد. در اینجا از Moq استفاده شده است، اما میتوانستید از کتابخانههای دیگری استفاده کنید یا حتی خودتان یک پیادهسازی ایجاد کنید.
نکتهی مهم این است که باید یک پیادهسازی مخصوص تست از IMessageWriter در اختیار برنامه قرار دهید تا مطمئن شوید که در هر لحظه فقط یک چیز را تست میکنید. در حال حاضر، شما در حال تست متد Exclaim از کلاس Salutation هستید، بنابراین نمیخواهید هیچ پیادهسازی واقعی از IMessageWriter که در محیط Production استفاده میشود، در تست شما دخالت کند.
برای ایجاد نمونهی کلاس Salutation، نمونهی Mock مربوط به IMessageWriter را به آن ارسال میکنید.
از آنجا که writerMock یک نمونه از Mock<IMessageWriter> است، ویژگی Object یک نمونهی ایجادشده بهصورت پویا از IMessageWriter را در اختیار شما قرار میدهد.
تزریق Dependency موردنیاز از طریق Constructor، CONSTRUCTOR INJECTION نامیده میشود.
بعد از اجرای System Under Test (SUT)، میتوانید از Mock استفاده کنید تا بررسی کنید که متد Write با متن صحیح فراخوانی شده است.
در Moq، این کار را با فراخوانی متد Verify و ارسال یک Expression انجام میدهید که مشخص میکند انتظار دارید چه اتفاقی بیفتد.
اگر متد IMessageWriter.Write با رشتهی "Hello DI!" فراخوانی شده باشد، فراخوانی Verify با موفقیت تمام میشود.
اما اگر متد Write اصلاً فراخوانی نشده باشد، یا با پارامتر متفاوتی فراخوانی شده باشد، متد Verify یک Exception ایجاد میکند و در نتیجه تست شکست میخورد.
خوب Loose Coupling مزایای زیادی دارد: کد سادهتر توسعه داده میشود، نگهداری آن آسانتر است، گسترش آن راحتتر است و همچنین TESTABLEتر میشود.
این کار حتی چندان هم دشوار نیست.
ما بهجای پیادهسازیهای Concrete، بر اساس Interfaceها برنامهنویسی میکنیم.
تنها مانع اصلی این است که بفهمیم چگونه نمونههایی از این Interfaceها را به دست بیاوریم.
خوب DI به این سؤال پاسخ میدهد: با تزریق Dependencyها از خارج.
روش ترجیحی برای انجام این کار، CONSTRUCTOR INJECTION است.
ص 22
چه چیزهایی را باید Inject کنیم و چه چیزهایی را نباید؟
در بخش قبلی، دربارهی عواملی صحبت کردم که باعث میشوند اصلاً به DI فکر کنیم. اگر قانع شده باشید که Loose Coupling ایدهی خوبی است، ممکن است بخواهید همهچیز را بهصورت loosely coupled طراحی کنید.
در مجموع، این کار ایدهی خوبی است. وقتی باید تصمیم بگیرید که ماژولها را چگونه بستهبندی کنید، Loose Coupling راهنمای بسیار مفیدی در اختیارتان قرار میدهد.
اما لازم نیست همهچیز را انتزاعی کنید و همهچیز را قابل جایگزینی (Pluggable) کنید.
در این بخش، ابزارهایی برای تصمیمگیری در اختیارتان قرار میدهم که میتوانند به شما کمک کنند تصمیم بگیرید Dependencyهای خود را چگونه مدل کنید.
کتابخانهی کلاسهای پایهی .NET (BCL) از تعداد زیادی Assembly تشکیل شده است.
هر بار که کدی مینویسید که از یک Type موجود در یکی از Assemblyهای BCL استفاده میکند، یک Dependency به ماژول خود اضافه میکنید.
در بخش قبلی توضیح دادم که Loose Coupling چقدر اهمیت دارد و اینکه برنامهنویسی بر اساس Interface، سنگبنای این مفهوم است.
آیا این یعنی نمیتوانید هیچ Assemblyای از BCL را Reference کنید و مستقیماً از Typeهای آنها در برنامهی خود استفاده کنید؟
مثلاً اگر بخواهید از یک XmlWriter استفاده کنید که در Assemblyای به نام System.Xml تعریف شده است، چه؟
لازم نیست با همهی Dependencyها به یک شکل رفتار کنید.
بسیاری از Typeهای موجود در BCL را میتوان بدون اینکه میزان Coupling برنامه را به خطر بیندازند، استفاده کرد؛ اما همهی آنها اینطور نیستند.
مهم است که بدانید چگونه بین Typeهایی که هیچ خطری ایجاد نمیکنند و Typeهایی که ممکن است میزان Coupling برنامه را افزایش دهند، تفاوت قائل شوید.
تمرکز اصلی خود را روی دستهی دوم قرار دهید.
1.3.1 درزها (Seams)
هر جا تصمیم میگیریم بهجای یک Concrete Type، بر اساس یک Interface برنامهنویسی کنیم، یک SEAM در برنامه ایجاد میکنیم.
خوب SEAM نقطهای است که در آن یک برنامه از اجزای تشکیلدهندهی خودش سرهمبندی میشود؛ درست شبیه لباسی که در محل درزهایش به یکدیگر دوخته شده است.
همچنین SEAM جایی است که میتوانیم برنامه را از هم جدا کنیم و با ماژولهای آن بهصورت مستقل کار کنیم.
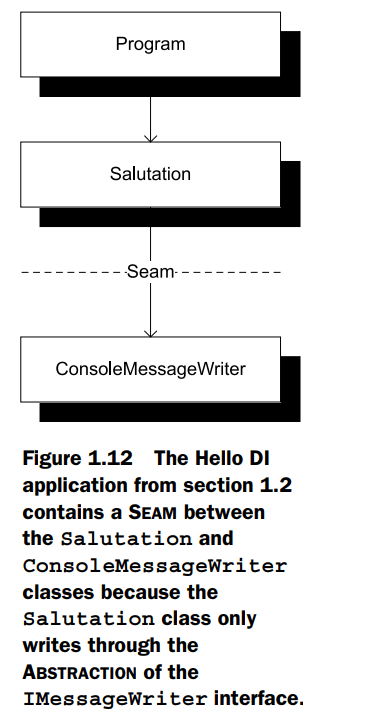
مثال Hello DI که در بخش 1.2 ساختیم، یک SEAM بین Salutation و ConsoleMessageWriter دارد؛ همانطور که در شکل 1.12 نشان داده شده است.
کلاس Salutation مستقیماً به کلاس ConsoleMessageWriter وابسته نیست؛ بلکه برای نوشتن پیامها از Interface به نام IMessageWriter استفاده میکند.
میتوانید برنامه را از همین SEAM از هم جدا کنید و دوباره آن را با یک Message Writer متفاوت سرهمبندی کنید.
هنگام یادگیری DI، دستهبندی Dependencyهای خود به دو گروه STABLE DEPENDENCIES و VOLATILE DEPENDENCIES میتواند مفید باشد؛ اما تصمیمگیری دربارهی اینکه SEAMهای خود را کجا قرار دهید، خیلی زود برایتان به یک مهارت طبیعی و بدیهی تبدیل خواهد شد.
در بخشهای بعدی، این مفاهیم را با جزئیات بیشتری بررسی خواهیم کرد.
ص23
Dependencyهای پایدار (Stable Dependencies)
بسیاری از ماژولهای موجود در BCL و حتی خارج از آن، هیچ تهدیدی برای میزان Modularity یک برنامه ایجاد نمیکنند. این ماژولها قابلیتهای قابلاستفادهی مجددی در اختیار ما قرار میدهند که میتوانیم از آنها استفاده کنیم تا کد خودمان کوتاهتر و سادهتر شود.
ماژولهای BCL همیشه در دسترس برنامهی شما هستند، چون برنامه برای اجرا به .NET Framework نیاز دارد. نگرانی مربوط به Parallel Development نیز دربارهی این ماژولها مطرح نیست، چون آنها از قبل وجود دارند و شما همیشه میتوانید از یک کتابخانهی BCL در برنامهی دیگری نیز استفاده کنید.
بهصورت پیشفرض، میتوانید بیشتر Typeهای تعریفشده در BCL را، البته نه همهی آنها را، امن یا STABLE DEPENDENCIES در نظر بگیرید.
من به آنها Stable میگویم، چون:
-
از قبل وجود دارند،
-
معمولاً با نسخههای قبلی سازگاری معکوس (Backwards Compatible) دارند،
-
و فراخوانی آنها نتایج قابل پیشبینی و قطعی (Deterministic Outcomes) دارد.
بیشتر STABLE DEPENDENCIESها Typeهای BCL هستند، اما Dependencyهای دیگری هم میتوانند Stable باشند.
معیارهای مهم برای STABLE DEPENDENCIES عبارتاند از:
-
کلاس یا ماژول از قبل وجود داشته باشد.
-
انتظار داشته باشید نسخههای جدید شامل تغییرات ناسازگار و مخرب (Breaking Changes) نباشند.
-
خوب Typeهای موردنظر شامل الگوریتمهای قطعی (Deterministic Algorithms) باشند.
-
هرگز انتظار نداشته باشید که مجبور شوید کلاس یا ماژول را با مورد دیگری جایگزین کنید.
جالب اینجاست که خود DI CONTAINERها نیز معمولاً STABLE DEPENDENCIES محسوب میشوند، چون تمام این معیارها را دارند.
وقتی تصمیم میگیرید برنامهی خود را بر اساس یک DI CONTAINER خاص بنا کنید، این خطر وجود دارد که در تمام طول عمر برنامه مجبور باشید با همان انتخاب ادامه دهید.
این هم یک دلیل دیگر است که چرا باید استفاده از DI Container را به COMPOSITION ROOT برنامه محدود کنید.
مثالهای دیگر میتوانند شامل کتابخانههای تخصصیای باشند که الگوریتمهای مرتبط با برنامهی شما را در خودشان کپسوله کردهاند.
مثلاً اگر در حال توسعهی برنامهای هستید که با شیمی سروکار دارد، ممکن است به یک کتابخانهی شخص ثالث (Third-Party Library) Reference دهید که قابلیتهای تخصصی مربوط به شیمی را در اختیار شما قرار میدهد.
بهطور کلی، میتوان Dependencyها را از طریق حذف موارد دیگر، Stable در نظر گرفت:
اگر یک Dependency Volatile نباشد، میتوان آن را Stable در نظر گرفت.
1.3.3 Dependencyهای ناپایدار (VOLATILE DEPENDENCIES)
اضافه کردن SEAM به یک برنامه، کار اضافی ایجاد میکند؛ بنابراین فقط زمانی باید این کار را انجام دهید که واقعاً ضروری باشد.
ممکن است بیش از یک دلیل وجود داشته باشد که لازم باشد یک Dependency را پشت یک SEAM جدا کنیم، اما این دلایل ارتباط نزدیکی با مزایای Loose Coupling دارند که در بخش 1.2.2 دربارهی آنها صحبت کردیم.
این نوع Dependencyها را میتوان از روی تمایلشان به ایجاد اختلال در یک یا چند مورد از این مزایا تشخیص داد.
آنها Stable نیستند، چون پایهی کافی و قابلاعتمادی برای برنامهها فراهم نمیکنند. به همین دلیل، من آنها را VOLATILE DEPENDENCIES مینامم.
یک Dependency زمانی باید Volatile در نظر گرفته شود که هر یک از معیارهای زیر دربارهی آن صدق کند:
- خوب Dependency باعث شود برای برنامه نیاز به راهاندازی و پیکربندی یک Runtime Environment داشته باشیم.
یک Relational Database نمونهی کلاسیک این مورد است:
اگر یک پایگاه دادهی رابطهای را پشت یک SEAM مخفی نکنیم، دیگر هیچوقت نمیتوانیم آن را با یک فناوری دیگر جایگزین کنیم.
همچنین این موضوع باعث میشود راهاندازی و اجرای Automated Unit Testها دشوار شود.
ص24
پایگاههای داده
پایگاههای داده مثال خوبی از Typeهای BCL هستند که VOLATILE DEPENDENCIES محسوب میشوند. با اینکه LINQ to Entities یک فناوری موجود در BCL است، استفاده از آن به وجود یک Relational Database وابسته است.
سایر منابع خارج از پردازش (Out-of-Process Resources) مانند Message Queueها، Web Serviceها و حتی File System نیز در همین دسته قرار میگیرند.
توجه داشته باشید که مسئله بیشتر خود Typeهای Concrete در .NET نیست؛ بلکه چیزی است که این Typeها دربارهی Runtime Environment به ما تحمیل میکنند.
نشانههای این نوع Dependency عبارتاند از:
-
نداشتن Late Binding
-
نداشتن Extensibility
-
و از کار افتادن TESTABILITY
- خوب DEPENDENCY هنوز وجود ندارد، اما همچنان در حال توسعه است.
نشانهی واضح چنین Dependencyهایی، ناتوانی در انجام Parallel Development است.
- خوب DEPENDENCY روی تمام سیستمهای سازمان توسعه نصب نشده است.
این وضعیت ممکن است برای کتابخانههای گرانقیمت شخص ثالث (Third-Party Libraries) یا Dependencyهایی که نمیتوان آنها را روی تمام سیستمعاملها نصب کرد، اتفاق بیفتد.
رایجترین نشانهی این وضعیت، از کار افتادن TESTABILITY است.
- خوب Dependency شامل رفتار غیرقطعی (Nondeterministic Behavior) است.
این موضوع بهخصوص در Unit Testها اهمیت دارد، چون تمام تستها باید Deterministic باشند.
منابع رایج Nondeterminism عبارتاند از اعداد تصادفی و الگوریتمهایی که به تاریخ یا زمان فعلی وابسته هستند.
توجه داشته باشید که منابع رایج Nondeterminism، مانند:
-
System.Random -
System.Security.Cryptography.RandomNumberGenerator -
System.DateTime.Now
در mscorlib تعریف شدهاند. بنابراین نمیتوانید از داشتن Reference به Assemblyای که این Typeها در آن تعریف شدهاند، اجتناب کنید.
با این وجود، باید با آنها مانند VOLATILE DEPENDENCIES رفتار کنید، چون معمولاً باعث از بین رفتن TESTABILITY میشوند.
خوب VOLATILE DEPENDENCIES نقطهی تمرکز اصلی DI هستند.
ما برای VOLATILE DEPENDENCIES، نه STABLE DEPENDENCIES، در برنامهی خود SEAM ایجاد میکنیم.
و همانطور که گفتیم، این کار ما را ملزم میکند که آنها را با استفاده از DI سرهمبندی (Compose) کنیم.
حالا که تفاوت بین STABLE DEPENDENCIES و VOLATILE DEPENDENCIES را درک کردهاید، احتمالاً کمکم میتوانید محدودهی کلی DI را هم ببینید.
خوب Loose Coupling یک اصل طراحی فراگیر است؛ بنابراین DI نیز بهعنوان ابزاری برای ایجاد Loose Coupling، باید در سراسر Code Base شما وجود داشته باشد.
مرز مشخص و دقیقی بین موضوع DI و طراحی خوب نرمافزار وجود ندارد، اما برای اینکه محدودهی ادامهی کتاب را مشخص کنم، بهسرعت توضیح میدهم که این کتاب چه موضوعاتی را پوشش میدهد.
1.4 محدودهی DI
همانطور که در بخش 1.2 دیدیم، یکی از عناصر مهم DI این است که مسئولیتهای مختلف را به کلاسهای جداگانه تقسیم کنیم.
یکی از مسئولیتهایی که از کلاسها میگیریم، وظیفهی ایجاد نمونههای Dependencyها است.
وقتی یک کلاس کنترل Dependencyهای خودش را رها میکند، در واقع چیزی بیشتر از تصمیمگیری دربارهی انتخاب پیادهسازیهای خاص را واگذار میکند.
با این حال، ما بهعنوان برنامهنویس، در عوض مزایایی به دست میآوریم.
نکته: ما بهعنوان برنامهنویس، با خارج کردن کنترل از کلاسهایی که از Dependencyها استفاده میکنند، کنترل بیشتری به دست میآوریم.
این موضوع نمونهای از کاربرد SINGLE RESPONSIBILITY PRINCIPLE است:
این کلاسها باید فقط با حوزهی مسئولیت مشخصشدهی خودشان سروکار داشته باشند و نباید نگران این باشند که Dependencyهایشان چگونه ایجاد میشوند.
ص25
در ابتدا، ممکن است به نظر برسد که واگذار کردن کنترلِ اینکه یک کلاس چه Objectهایی را ایجاد میکند، یک نقطهضعف باشد؛ اما ما بهعنوان برنامهنویس، این کنترل را از دست نمیدهیم؛ فقط آن را به جای دیگری منتقل میکنیم.
با این حال، OBJECT COMPOSITION تنها بُعدی از کنترل نیست که از کلاس میگیریم، چون یک کلاس همچنین توانایی کنترل طول عمر (Lifetime) یک Object را نیز از دست میدهد.
وقتی یک نمونه از DEPENDENCY به یک کلاس Inject میشود، مصرفکننده (Consumer) نمیداند آن نمونه چه زمانی ایجاد شده است یا چه زمانی از Scope خارج خواهد شد.
در بسیاری از مواقع، این موضوع برای Consumer اهمیتی ندارد، اما در بعضی موارد ممکن است مهم باشد.
خوب DI به ما این امکان را میدهد که DEPENDENCIES را به روشی یکپارچه و یکنواخت مدیریت کنیم.
وقتی Consumerها مستقیماً نمونههای DEPENDENCIES را ایجاد و پیکربندی میکنند، هرکدام ممکن است این کار را به روش خاص خود انجام دهند؛ روشی که ممکن است با نحوهی انجام این کار توسط Consumerهای دیگر متفاوت باشد.
در این حالت، هیچ راهی نداریم که DEPENDENCIES را بهصورت مرکزی مدیریت کنیم و همچنین راه سادهای برای رسیدگی به CROSS-CUTTING CONCERNS نداریم.
با DI، این امکان را به دست میآوریم که هر نمونهی DEPENDENCY را قبل از اینکه به Consumer داده شود، Intercept کنیم و روی آن عملی انجام دهیم.
با استفاده از DI، میتوانیم برنامهها را در حالی که Dependencyها را Intercept میکنیم و Lifetime آنها را کنترل میکنیم، Compose کنیم.
OBJECT COMPOSITION، INTERCEPTION و LIFETIME MANAGEMENT سه بُعد اصلی DI هستند.
در ادامه، این سه مورد را بهصورت مختصر بررسی میکنم؛ توضیح دقیقتر آنها در بخش ۳ کتاب ارائه خواهد شد.
1.4.1 ترکیب اشیا (Object Composition)
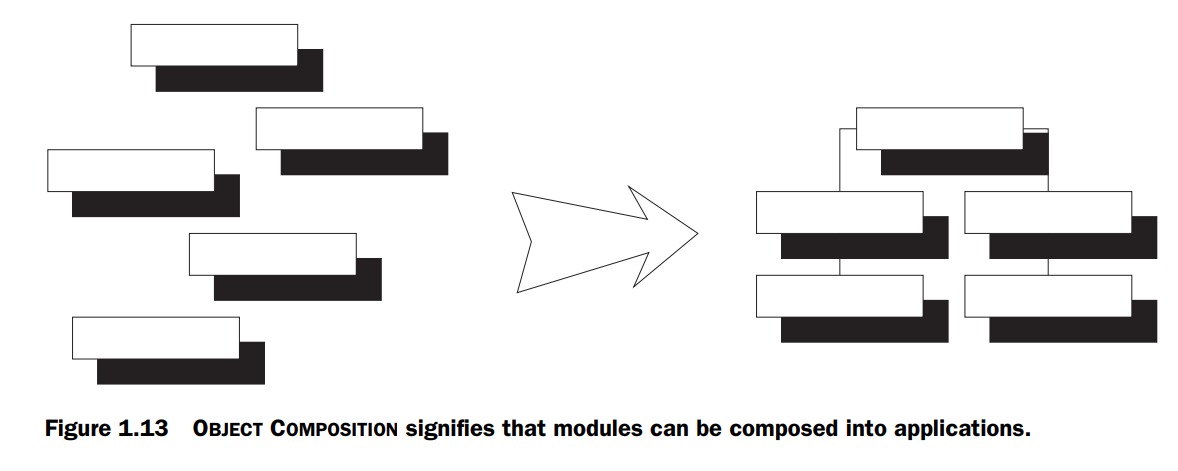
برای اینکه بتوانیم از مزایای Extensibility، Late Binding و Parallel Development بهره ببریم، باید بتوانیم کلاسها را در کنار یکدیگر قرار دهیم و از آنها برنامه بسازیم؛ همانطور که در شکل 1.13 نشان داده شده است.
چنین OBJECT COMPOSITIONای اغلب مهمترین انگیزه برای اضافه کردن DI به یک برنامه است.
در ابتدا، DI عملاً مترادف با OBJECT COMPOSITION بود؛ این تنها جنبهای از DI است که در مقالهی اصلی Martin Fowler دربارهی این موضوع مورد بحث قرار گرفته است.
ص27 روشهای مختلفی برای Compose کردن کلاسها در یک برنامه وجود دارد.
وقتی دربارهی Late Binding صحبت کردم، از یک فایل Configuration و مقداری Dynamic Object Instantiation استفاده کردم تا برنامه را بهصورت دستی و با استفاده از ماژولهای موجود Compose کنم؛ اما میتوانستم از CODE AS CONFIGURATION یا یک DI CONTAINER نیز استفاده کنم.
در فصل ۷ دوباره به این موارد برمیگردیم.
اگرچه معنای اولیهی DI ارتباط بسیار نزدیکی با OBJECT COMPOSITION داشت، اما جنبههای دیگری نیز به مرور مشخص شدند که اهمیت دارند.
1.4.2 طول عمر Object (Object Lifetime)
کلاسی که کنترل DEPENDENCIES خود را واگذار کرده است، چیزی بیشتر از امکان انتخاب پیادهسازیهای خاص برای یک ABSTRACTION را از دست میدهد.
این کلاس همچنین اختیار کنترل زمان ایجاد نمونهها و زمان خارج شدن آنها از Scope را نیز از دست میدهد.
در .NET، Garbage Collector بسیاری از این موارد را برای ما مدیریت میکند.
یک Consumer میتواند DEPENDENCIES خود را دریافت کند و تا هر زمانی که بخواهد از آنها استفاده کند.
وقتی کارش تمام شد، DEPENDENCIES از Scope خارج میشوند.
اگر هیچ کلاس دیگری به آنها Reference نداشته باشد، برای Garbage Collection واجد شرایط میشوند.
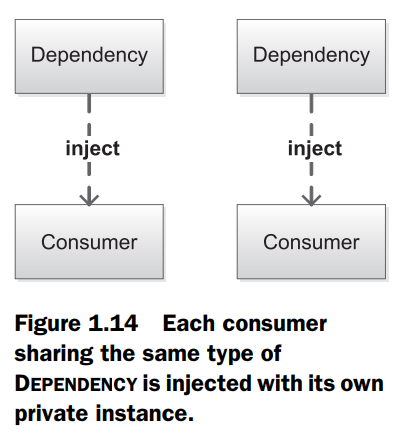
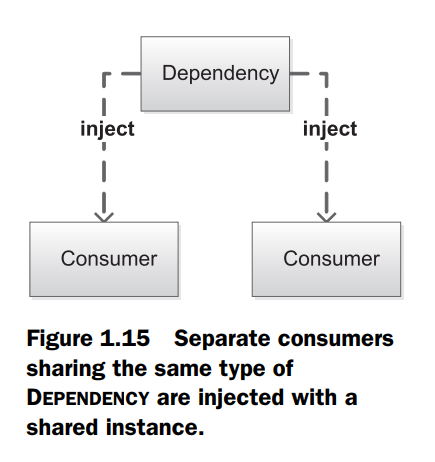
اما اگر دو Consumer یک نوع DEPENDENCY مشترک داشته باشند چه؟
شکل 1.14 نشان میدهد که میتوانیم انتخاب کنیم یک نمونهی جداگانه به هر Consumer Inject کنیم.
در مقابل، شکل 1.15 نشان میدهد که میتوانیم بهجای آن، یک نمونهی واحد را بین چند Consumer به اشتراک بگذاریم.
با این حال، از دیدگاه Consumer هیچ تفاوتی وجود ندارد.
طبق LISKOV SUBSTITUTION PRINCIPLE، Consumer باید با تمام نمونههای یک Interface مشخص به یک شکل رفتار کند.
از آنجا که DEPENDENCIES ممکن است بین چند Consumer به اشتراک گذاشته شوند، یک Consumer بهتنهایی نمیتواند طول عمر آنها را کنترل کند.
تا زمانی که یک Object مدیریتشده (Managed Object) بتواند از Scope خارج شود و توسط Garbage Collector جمعآوری شود، این موضوع مشکل چندانی ایجاد نمیکند؛ اما وقتی DEPENDENCIES، Interface مربوط به IDisposable را پیادهسازی میکنند، شرایط بسیار پیچیدهتر میشود.
بهطور کلی، LIFETIME MANAGEMENT یک بُعد مستقل از DI است و آنقدر اهمیت دارد که کل فصل ۸ را به آن اختصاص دادهام.
واگذار کردن کنترل یک DEPENDENCY به این معناست که کنترل Lifetime آن را نیز واگذار کنیم؛ بنابراین شخص یا بخش دیگری که در سطح بالاتری از Call Stack قرار دارد، باید Lifetime آن Dependency را مدیریت کند.
1.4.3 رهگیری (Interception)
وقتی کنترل DEPENDENCIES را همانطور که در شکل 1.16 نشان داده شده، به یک شخص ثالث (Third Party) واگذار میکنیم، در عین حال این امکان را نیز به دست میآوریم که قبل از تحویل دادن آنها به کلاسهایی که از آن Dependencyها استفاده میکنند، آنها را Modify یا تغییر دهیم.
ص27
در مثال Hello DI، ابتدا یک نمونه از ConsoleMessageWriter را به یک نمونه از Salutation Inject کردم.
سپس با تغییر دادن مثال، یک قابلیت امنیتی به آن اضافه کردم؛ به این صورت که یک SecureMessageWriter جدید ایجاد کردم که فقط زمانی کار را به ConsoleMessageWriter واگذار میکند که کاربر احراز هویت شده باشد.
این کار به ما اجازه میدهد SINGLE RESPONSIBILITY PRINCIPLE را حفظ کنیم.
این کار به این دلیل امکانپذیر است که ما همیشه بر اساس Interfaceها برنامهنویسی میکنیم؛ به خاطر داشته باشید که DEPENDENCIES همیشه باید ABSTRACTIONS باشند.
در مورد Salutation، برای آن اهمیتی ندارد که IMessageWriterای که دریافت کرده است یک ConsoleMessageWriter باشد یا یک SecureMessageWriter.
خوب SecureMessageWriter میتواند یک ConsoleMessageWriter را درون خود Wrap کند؛ همان ConsoleMessageWriterای که همچنان کار واقعی را انجام میدهد.
نکته: INTERCEPTION یکی از کاربردهای الگوی طراحی Decorator است.
اگر با الگوی طراحی Decorator آشنا نیستید، نگران نباشید؛ در فصل ۹ یک مرور مجدد روی آن خواهیم داشت. این فصل بهطور کامل به INTERCEPTION اختصاص دارد.
این قابلیتهای INTERCEPTION ما را در مسیر Aspect-Oriented Programming قرار میدهند؛ موضوعی که ارتباط نزدیکی با DI دارد، اما خارج از محدودهی این کتاب است.
با استفاده از INTERCEPTION میتوانیم CROSS-CUTTING CONCERNSهایی مانند Logging، Auditing، Access Control، Validation و موارد دیگر را به شکلی ساختاریافته اعمال کنیم؛ بهطوری که بتوانیم Separation of Concerns را حفظ کنیم.
1.4.4 DI در سه بُعد
اگرچه DI در ابتدا بهعنوان مجموعهای از الگوها برای حل مشکل OBJECT COMPOSITION شکل گرفت، اما این اصطلاح بعدها گسترش پیدا کرد و OBJECT LIFETIME و INTERCEPTION را نیز دربر گرفت.
امروزه من DI را مفهومی میدانم که هر سه مورد را به شکلی یکپارچه در بر میگیرد.
خوب OBJECT COMPOSITION معمولاً بخش غالب این تصویر است؛ چون بدون یک OBJECT COMPOSITION انعطافپذیر، نه INTERCEPTIONای وجود خواهد داشت و نه نیازی به مدیریت OBJECT LIFETIME خواهیم داشت.
خوب OBJECT COMPOSITION بخش عمدهی این فصل را به خود اختصاص داده است و در ادامهی کتاب نیز همچنان نقش اصلی را خواهد داشت، اما نباید جنبههای دیگر را فراموش کنیم.
خوب OBJECT COMPOSITION پایه و اساس را فراهم میکند و LIFETIME MANAGEMENT به برخی از عوارض جانبی مهم رسیدگی میکند؛ اما عمدتاً در بخش INTERCEPTION است که شروع به بهرهبرداری از مزایای DI میکنیم.
در بخش ۳، یک فصل را به هر یک از این ابعاد اختصاص دادهام، اما در اینجا یک مرور کلی ارائه کردم، چون مهم است بدانید که در عمل، DI چیزی فراتر از OBJECT COMPOSITION است.
ص28
خلاصه (Summary)
خوب Dependency Injection یک وسیله برای رسیدن به هدف است، نه خودِ هدف. DI بهترین روش برای ایجاد Loose Coupling است؛ چیزی که بخش مهمی از کد قابل نگهداری (Maintainable Code) محسوب میشود.
مزایایی که میتوانیم از Loose Coupling به دست بیاوریم، همیشه بلافاصله قابل مشاهده نیستند؛ اما با گذشت زمان و افزایش پیچیدگی Code Base، این مزایا خودشان را نشان میدهند.
یک Code Base که Tightly Coupled باشد، در نهایت به Spaghetti Code تبدیل خواهد شد، در حالی که یک Code Base با طراحی مناسب و Loosely Coupled میتواند همچنان قابل نگهداری باقی بماند.
برای رسیدن به یک Supple Design واقعی، چیزی بیشتر از Loose Coupling لازم است، اما برنامهنویسی بر اساس Interfaceها یک پیشنیاز اساسی است.
خوب DI چیزی بیشتر از مجموعهای از Design Principles و Design Patterns نیست.
خوب DI بیشتر دربارهی یک روش فکر کردن و طراحی کد است تا ابزارها و تکنیکها.
یک نکتهی مهم دربارهی Loose Coupling و DI این است که برای اینکه مؤثر باشند، باید در سراسر Code Base شما وجود داشته باشند.
نکته: DI باید فراگیر (Pervasive) باشد. شما نمیتوانید بهراحتی Loose Coupling را بعداً روی یک Code Base موجود اضافه کنید.
دربارهی DI سوءبرداشتهای زیادی وجود دارد.
بعضی افراد فکر میکنند DI فقط به مشکلات محدودی مانند Late Binding یا Unit Testing میپردازد؛ اگرچه این جنبههای طراحی نرمافزار قطعاً از DI سود میبرند، اما محدودهی DI بسیار گستردهتر است.
هدف کلی، Maintainability است.
در ابتدای این فصل گفتم که برای یادگیری DI، ابتدا باید چیزهایی را که فکر میکنید دربارهی آن میدانید، فراموش کنید (Unlearn).
این موضوع در ادامهی کتاب نیز همچنان درست خواهد بود:
باید ذهن خودتان را آزاد کنید.
در یک پست وبلاگی بسیار خوب، Nicholas Blumhardt مینویسد:
دیکشنری یا آرایهی انجمنی (Associative Array) یکی از اولین ساختارهایی است که در مهندسی نرمافزار یاد میگیریم. بهراحتی میتوان شباهت بین یک دیکشنری و یک IoC Container را دید که با استفاده از Dependency Injection، Objectها را Compose میکند.
ایدهی DI بهعنوان یک سرویس که بر اساس مدل یک دیکشنری طراحی شده است، مستقیماً به SERVICE LOCATOR که یک Anti-Pattern است، منجر میشود.
به همین دلیل است که اینقدر روی نیاز به خالی کردن ذهن از حتی ابتداییترین فرضیات تأکید میکنم.
بالاخره وقتی دربارهی دیکشنریها صحبت میکنیم، دربارهی چیزهایی حرف میزنیم که به «مغز خزندهی برنامهنویسی» (Reptile Brain of Programming) تعلق دارند.
هدف DI این است که کد را قابل نگهداری (Maintainable) کند.
Code Baseهای کوچک، مانند یک مثال کلاسیک Hello World، ذاتاً به دلیل اندازهی کوچکشان قابل نگهداری هستند؛ به همین دلیل است که DI در مثالهای ساده معمولاً شبیه Over-Engineering به نظر میرسد.
هرچه Code Base بزرگتر میشود، مزایای DI نیز بیشتر و واضحتر دیده میشوند.
به همین دلیل، فصل بعدی را به یک مثال بزرگتر و پیچیدهتر اختصاص دادهام تا این مزایا را بهخوبی نشان دهم.