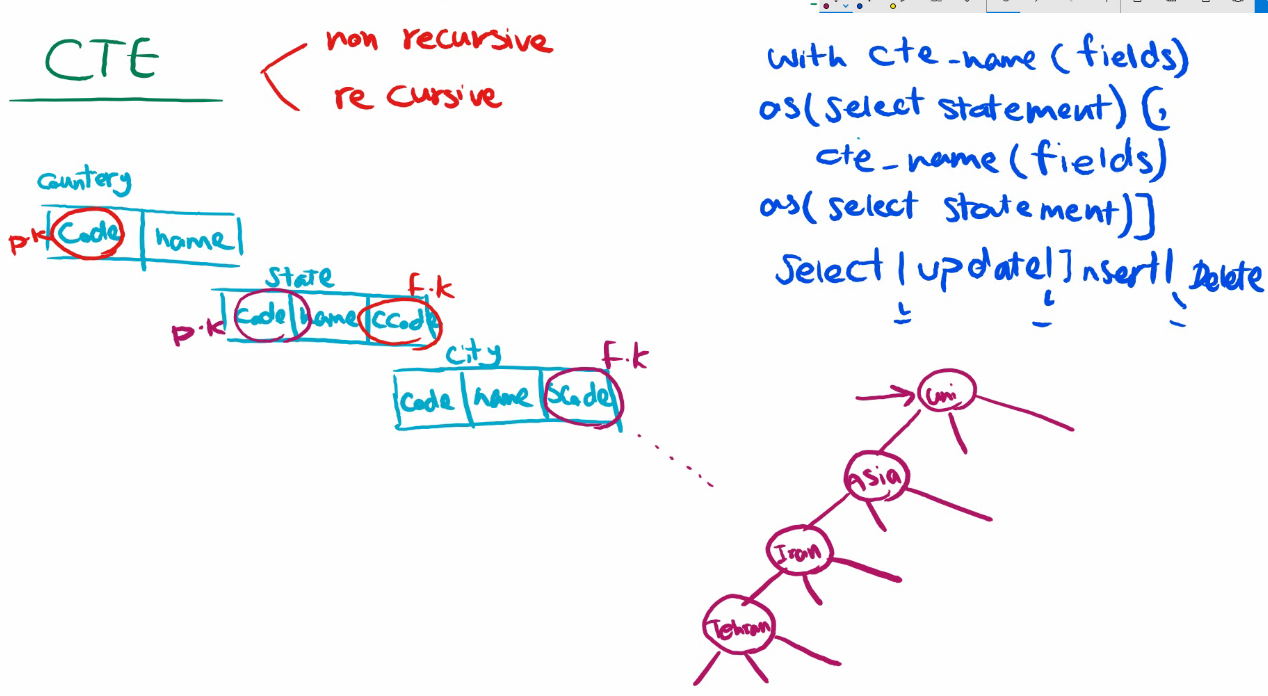
خوب در دیتابیس یه سری از روابط بهتره که به صورت درختی باشند مثلا مثل کشور شهر استان و …
معمولا توی یک جدول همه ی این دیتاها ثبت میشه
اینجا میشه uni میشه root و یه سری لایه میانی داریم و …
از این مدل در دیتابیس چارت سازمانی استفاده میشه
دسته بندی محصولات
با ویرگول میتونیم در صورت نیاز میتونیم cte های دیگه رو تعریف کنیم
از cte های غیر بازگشتی در هر جایی که داشتیم از drive table داشتیم استفاده میکردیم و کوئری نوشتیم و میخواستیم از اون کوئری ها استفاده کنیم و میخوایم که optimize اش کنیم
به جاش میتونستیم بنویسیمشون و بعد اسم گذاریش کنیم و بعد بیایم از این ها استفاده کنیم
امکانات cte recursive
خوب ccode میشه country code حالا قراره این ها رو بهم وصل کنیم یعنی state رو به countey وصل میکنیم و در لایه بعدی scode هم داریم که میشه state code که یعنی میخوایم این ها رو به هم وصل کنیم
و ممکنه جدول های دیگه ای داشته باشیم که بخوایم این ها رو به هم وصل کنیم
خوب حالا اگر بخوایم مثلا منطقه 15 رو ببینیم برای کجاست هر دفعه باید بیایم و کلی join بزنیم ببینیم برای چه شهر در کدوم استانی و … هستش
بعضی از دیتا ها به ذات بهتره که اینطوری نباشند که بخوایم برای بدست آوردنشون چندین تا join بزنیم
بهرته که این ها tree یا hireachical باشند
همچین دیتاهایی معمولا در یک جدول ثبت میشه ، به وساطه رابطه parent child میتونیم بفهمیم که هر کدوم اینها به چی وصله
بالاترین قسمت میشه root که اینجا universe هستش و اون وسطی ها میشن intermadiate و بعدش میشه برگ ها میشن child
11:11
مثلا چارت سازمانی درختیه ، اکتیو دایرکتوری ، دسته بندی محصولات مثلا در دیجیکالا - لوازام خانگی - بعد ریز میشه و بعد دوباره ریز میشه
در بخش سومی که گذاشتیم null برای iran قسمتی هستش که میایم parent code رو میزاریم به این معنی که این جد همه است و ما داریم از کشور شروع میکنیم
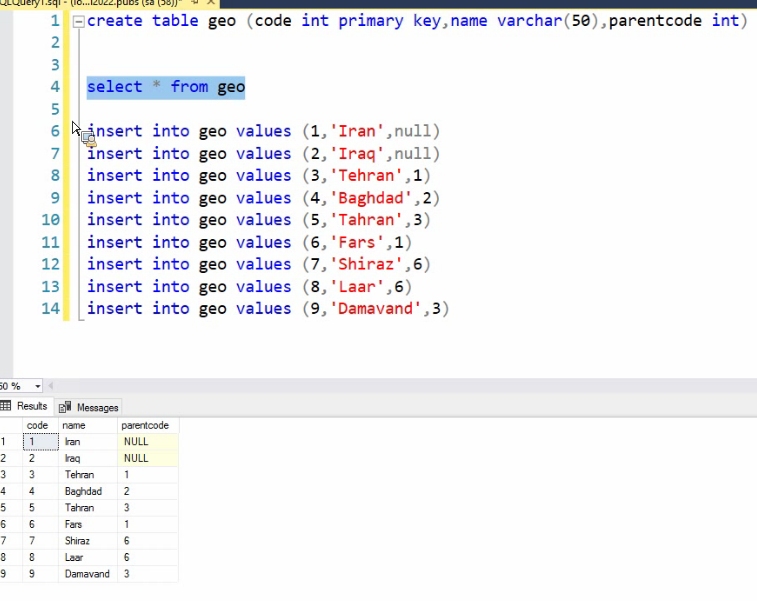
create table geo (code int primary key,name varchar(50),parentcode int)

select * from geo

insert into geo values(1,'Iran',null)
insert into geo values(2,'Iraq',null)
insert into geo values(3,'tehran',1)
insert into geo values(4,'Baghdad',2)
insert into geo values(5,'tehran',3)
insert into geo values(6,'fars',1)
insert into geo values(7,'Shiraz',6)
insert into geo values(8,'lar',6)
insert into geo values(9,'damavand',3)
حالا میخوایم چیزی رو درست کنیم وقتی که مثلا رفتیم روی شیراز بهمون کل مسیر رو نشون بده یعنی ایران فارس شیراز
خوب ما بیاید از CTE بازگشتی استفاده کنیم چرا که باید توی توی دیتامون بریم و itirate کنیم
توی sql server فقط میشه تا یک لایه بالا تر رو itirate کنیم یعنی این که وقتی که شیراز رو میاریم فقط به استانش که یه سطح بالاتره که میشه فارس دسترسی داریم
معمولا به CTE های بازگشتی میگن tree
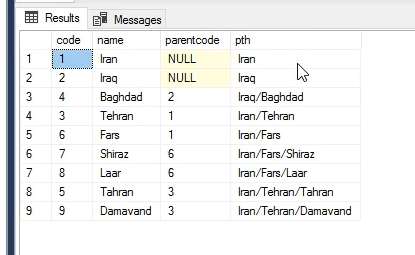
میخوایم برسیم به همچین چیزی :
ما میخوایم پیمایش کنیم یعنی بتونیم بزنیم روی فرزند و پدر و جد و … و پیمایش کنیم
در sql server تا یه لایه بالاتر نمیتونیم پیمایش کنیم
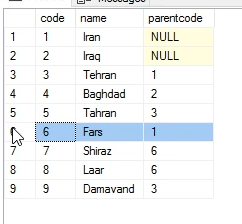
یعنی به طور مثال ما شیراز رو میبینیم که که parent code اش 6 هستش و ما متوجه میشویم که پدرش فارس هستش ولی دیگه نمیتونه یه پیمایش دیگه کنه که بره ببینه parent فارس 1 هستش و بره به ایران
منظور جمله ی بالا اینه
هر جا نوشتن tree ممکنه که cte بازگشتی باشه برای اثباتش باید بگردیم دنبال یه feature توی اون کوئری
باید توی اولین پرانتز بیایم کوئری بنویسیم که تمامی رکوردهایی که root هستش رو پیدا کنه و پدری بالا سرش نیست و جده خودش و برای پیدا کردنش باید بیام چک کنیم که کدوم یکی parent code اش null هستش
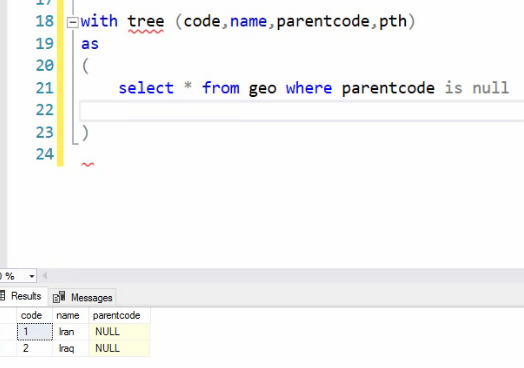
به اون هایی که سره شاخه ها هستند و هیچ فرزندی ندارند میگن leaf و اون هایی که اون وسط هستند میشه intermediate
خوب حالا میخوایم سر شاخه ها رو پیدا کنیم ، اون هایی که سر شاخه هستند parentcode اشون null هستش
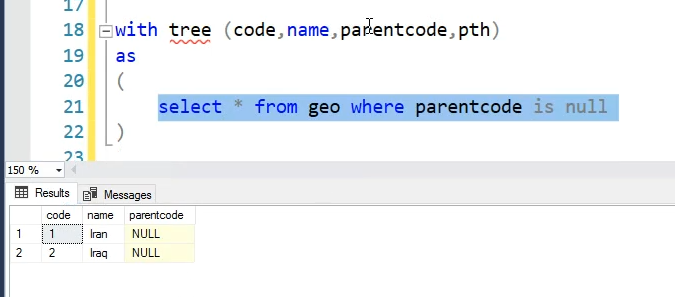
select * from geo where parentcode is null
حالا این کوئری بالایی رو union مکینیم با بقیه رکورد هایی که داریم که میشن بچه یا بچه ی بچه یا … فرقی نمیکنه
اون هایی که پدری بالاسرشون نیست میشن root و اون هایی که دیگه هیچ بچه ای ندارند میشن leaf و اون هایی که وسط اینهان میشن intermadite
این بازگشتی یعنی چی؟
مثلا ما یه functtion ضرب رو درست کردیم و توی همون فاانکشن میایم ازش استفاده میکنیم ، مثلا فاکتوریل همینطوریه
حالا توی این cte ها میایم از خوده Cte داخل خودش استفاده میکنیم تا بازگشتی بشه
خوب حالا برای این کار میایم tree رو با خودش که میشه tree میایم join میزنیم
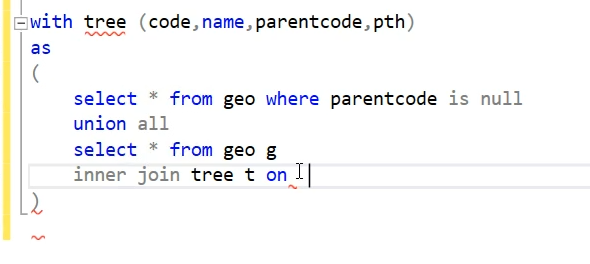
حالا ما یه جدول فرضی داریم به اسم tree که توی runtime داره ساخته میشه و یه جدول فیزیکی واقعی داریم به اسم geo
حالا کدوم فیلد ها رو باید به هم بچسبونیم
خوب tree وقتی که ساخته میشه رکورد به رکورد ساخته میشه
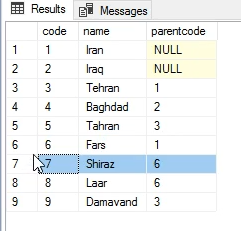
وقتی که داره ساخته میشه رکورد 7 قبلش 6 تا رکورد دیگه وجود دارند در ram
اینطوری میگه که وقتی که این رکورد 7 رو که داری از جدول geo میاری ، شیراز parentcode اش از قبل توی جدوب ساخته شده ، یعنی فارس
وقتی که join میزنیم جدول اول field هاش و بعد جدول دوم فیلدهاش
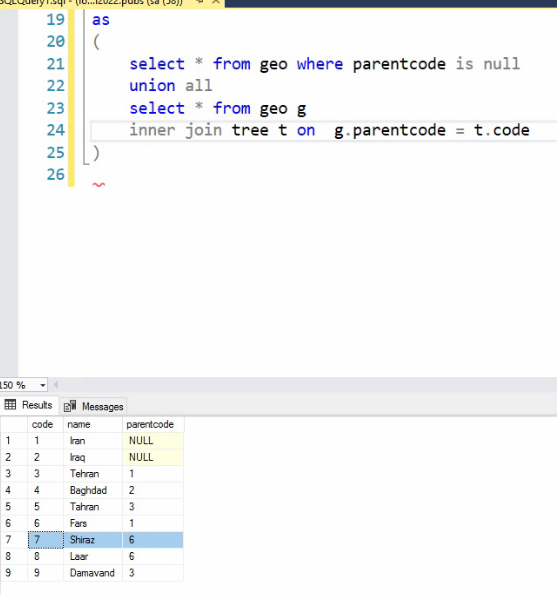
خوب این ها رو وقت یکه باهم join میزنیم
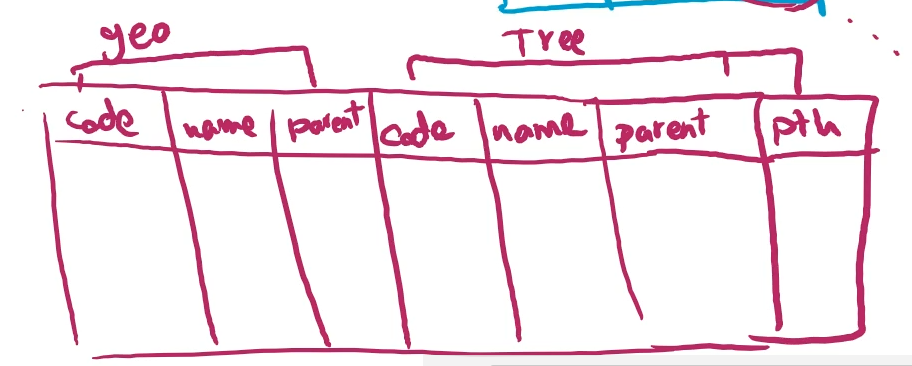
این شکلی میشه
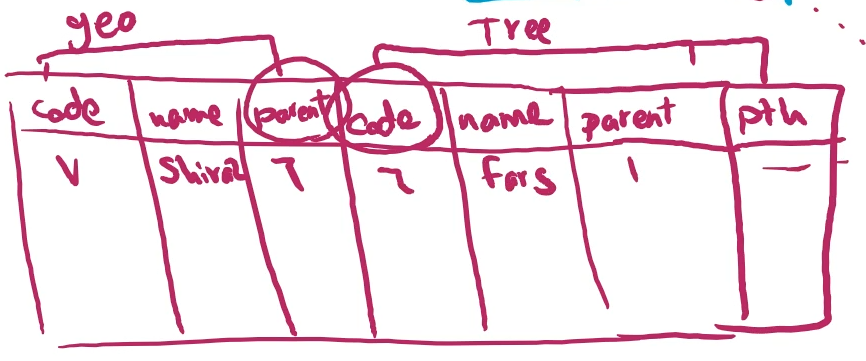
خوب اینجا نمیایم کد به کد بگیریم برای این بتونیم تناظر بهتری ایجاد کنیم که path بهتری درست کنیم از جدول اصلی میگیم که parent code رو بردار بعد بیا با tree که قبلا یه سری رکورد توش هستش چکش کن که این parent code عه به کدوم یکی از این رکورد ها تناظر پیدا میکنه
که اینجا به رکورد شماره 6 که فارس هستش برمیگرده
1.برای درست کردن cte میایم خوده جدول اصلی رو با جدول tree جوین میکنیم
2.از جدول اصلی فیلد parent code اش رو مساوی قرار بدیم با فیلد جدول کدش
with tree (code,name,parentcode,pth)
as
(
select * from geo where parentcode is null
union all
select * from geo g
inner join tree t on g.parentcode = t.code
)
خوب داخل جدول اول فیلد هایی که میخوایم code , name , parentcode ولی توی cte مون 4 تا فیلد نیاز داریم
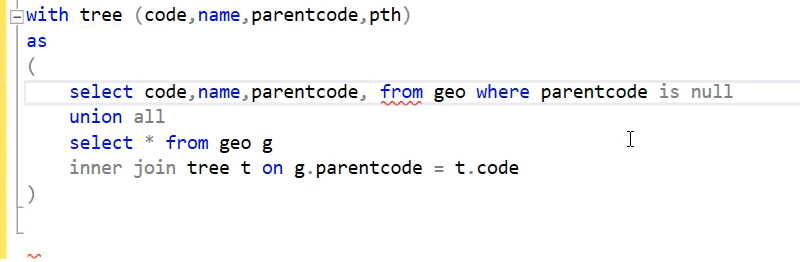
خوب حالا میخوایم path رو بسازیم
خوب path برای root میشه همون name
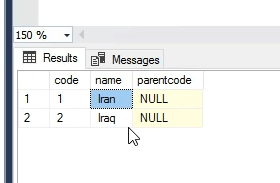
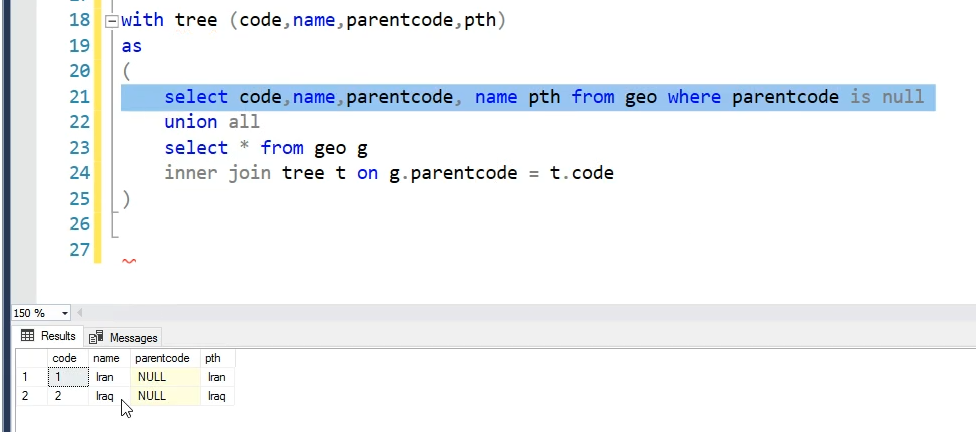
اینجا از name به عنوان path ازش استفاده کردیم
خوب اینجا از هر چیزی 2 تا داریم کدوما رو بیاریم و چطور ؟
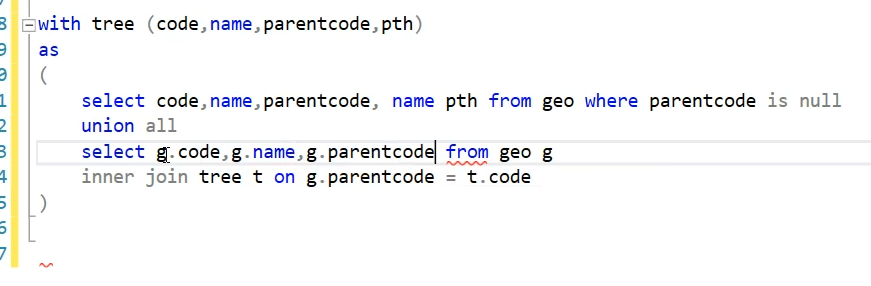
نکته : همیشه code و name و parent code رو از جدول اصلی بیاریم
with tree (code,name,parentcode,pth)
as
(
select code,name,parentcode,name pth from geo where parentcode is null
union all
select g.code,g.name,g.parentcode from geo g
inner join tree t on g.parentcode = t.code
)
خوب حالا میمونه فقط مسیر که توی sql ما فقط یه لول میتونیم بالاتر بریم
خوب ما شیراز رو از جدول geo داریم ولی مسیر دو تا لول بالاترش رو نداریم حالا ما توی Ram و در جدول tree اون 6 تا رکورد بالایی قبل از شیراز path اشون ساخته شده خوب ما میایم از رکورد شیراز رو از جدول geo و بعد رکورد فارس از جدول tree به هم دیگه متناظرش میکنیم
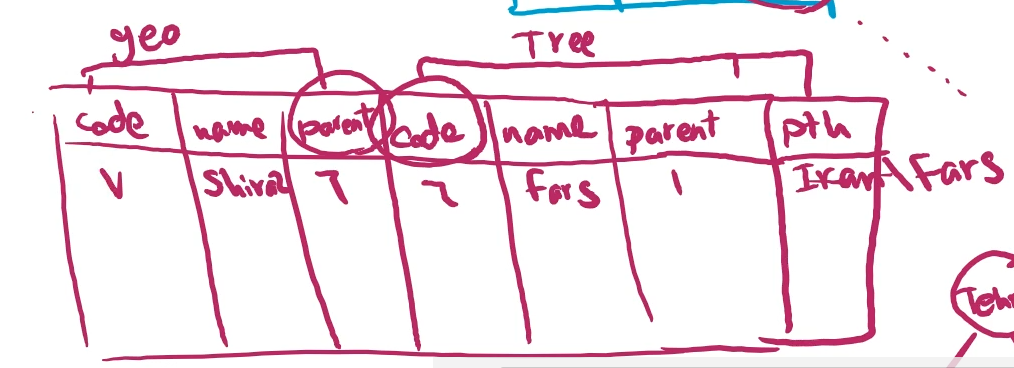
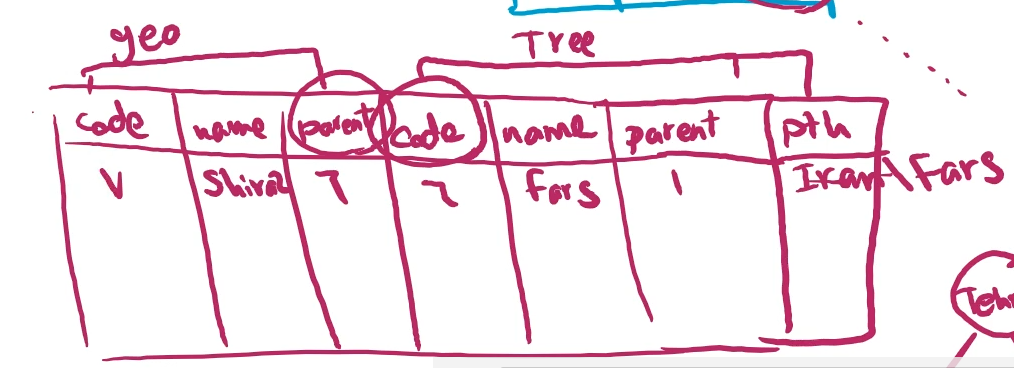
حالا میایم فیلد path عه tree میایم concat میکنیم با جدول geo اینطوری path لول های بالایی دراومده
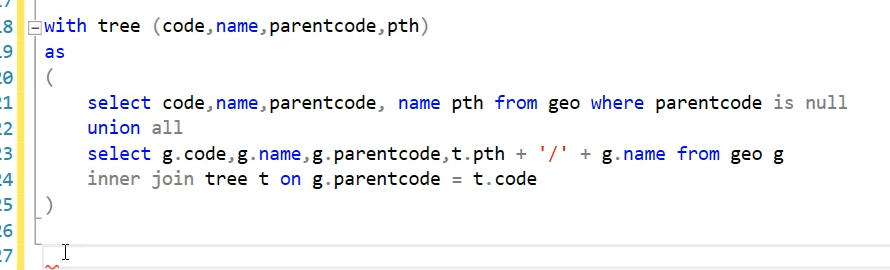
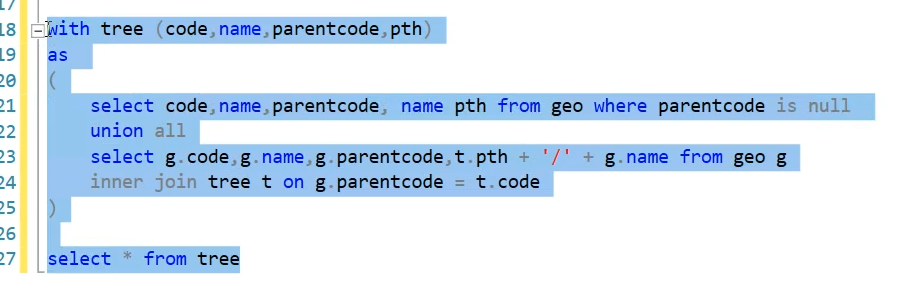
خوب روی tree که cte هستش باید حتما select , insert del بنویسیم
نکته مهم اینه که در بازگشتی ها باید tree رو صدا بزنیم در select اش
with tree (code,name,parentcode,pth)
as
(
select code,name,parentcode,name pth from geo where parentcode is null
union all
select g.code,g.name,g.parentcode,t.pth + '/' + g.name from geo g
inner join tree t on g.parentcode = t.code
)

select * from tree
به خطا میخوریم
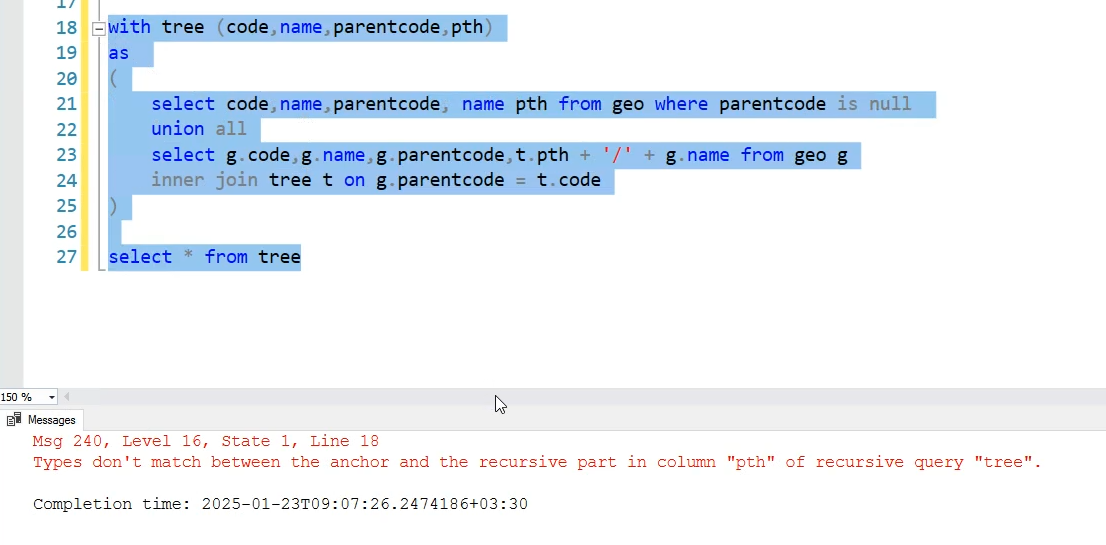
تا دقیقه 38:00
create table geo (code int primary key,name varchar(50),parentcode int)

select * from geo

insert into geo values(1,'Iran',null)
insert into geo values(2,'Iraq',null)
insert into geo values(3,'tehran',1)
insert into geo values(4,'Baghdad',2)
insert into geo values(5,'tehran',3)
insert into geo values(6,'fars',1)
insert into geo values(7,'Shiraz',6)
insert into geo values(8,'lar',6)
insert into geo values(9,'damavand',3)


with tree (code,name,parentcode,pth)
as
(
select code,name,parentcode,name pth from geo where parentcode is null
union all
select g.code,g.name,g.parentcode,t.pth + '/' + g.name from geo g
inner join tree t on g.parentcode = t.code
)

select * from tree
خوب union , union all , interect , except باید دیتا تایپ های select اول و دوم باید به هم بخورند و دیتا تایپ selct اول همیشه اون دیتا تایپی هست که result set در آخر به خودش میگیره
خوب به ازای column path
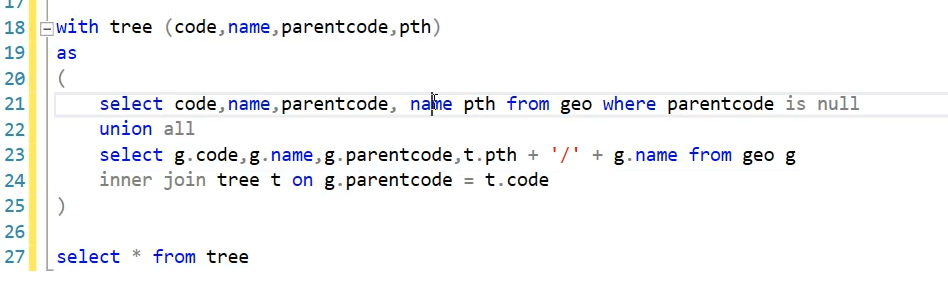
دیتا تایپ select اول مون
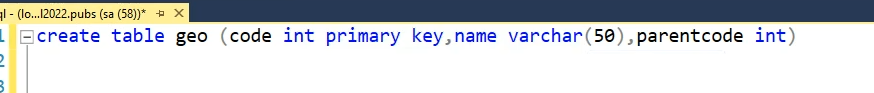
خوب گفتیم name رو داشته باشیم ، این name از جنس var char 50 هستش
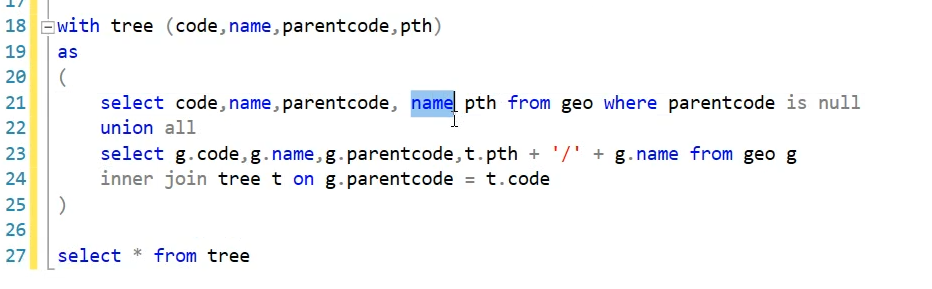
پس select اول ما که name هستش از جنس var char 50 هستش
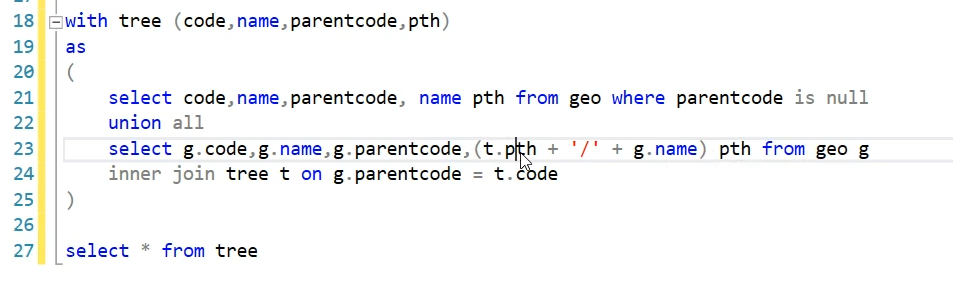
خوب توی پرانتز میخوایم pth رو بسازیم
خوب اونجایی که موس هستش اون یه var char 50 تایی هستش میاد concat اش میکنه با / و بعد میاد concat اش میکنه با یه var char 50 که name هستش ، خوب در کل میشه 50 + 50 + 1 میشه 101
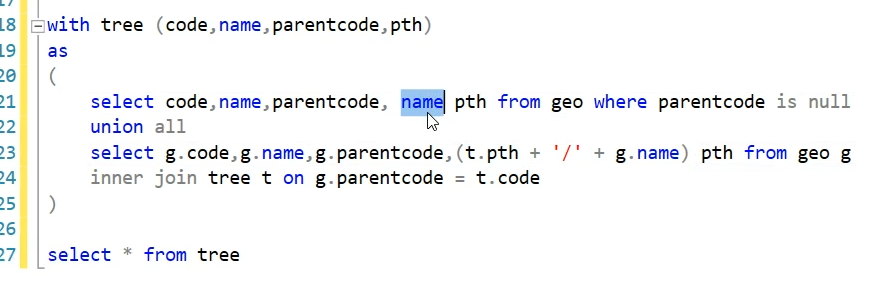
خوب اینجا 101 رو ما نمیتونیم بریزیم توی name که فقط 50 تاست
در sql server ما یه funtion ای داریم که میتونیم size data type ها رو کم و زیاد کنه یا دیتا تایپ هایی که قابل تبدیل به هم هستن رو convert کنه
مثلا دیتای عدد صحیح رو میتونیم بریزیم توی دیتا تایپ های اعداد اعشاری ولی برعکس اش نمیشه
عدد رو میشه برزیم توی sting ولی برعکس اش نمیشه
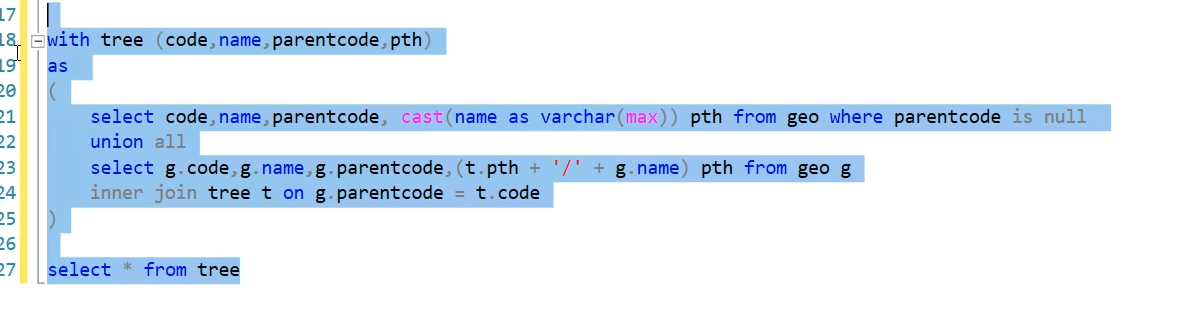
بهش میگن cast
with tree (code,name,parentcode,pth)
as
(
select code,name,parentcode,cast( name as varchar(max)) pth from geo where parentcode is null
union all
select g.code,g.name,g.parentcode,(t.pth + '/' + g.name) pth from geo g
inner join tree t on g.parentcode = t.code
)

select * from tree
خوب اینجا اون هایی که parent code اشون null هستش میشن
خیلی از وقت ما یه جدول میسازیم یا داریم یه سری کارها میکنیم ولی همچنان زیرشون رو خط قرمز میکشه و ارور ازشون میگیره برای این که intelisense رو refresh کنیم میایم و control + shift + r رو میزنیم
تایم 1:20:00
میرسیم به pivot
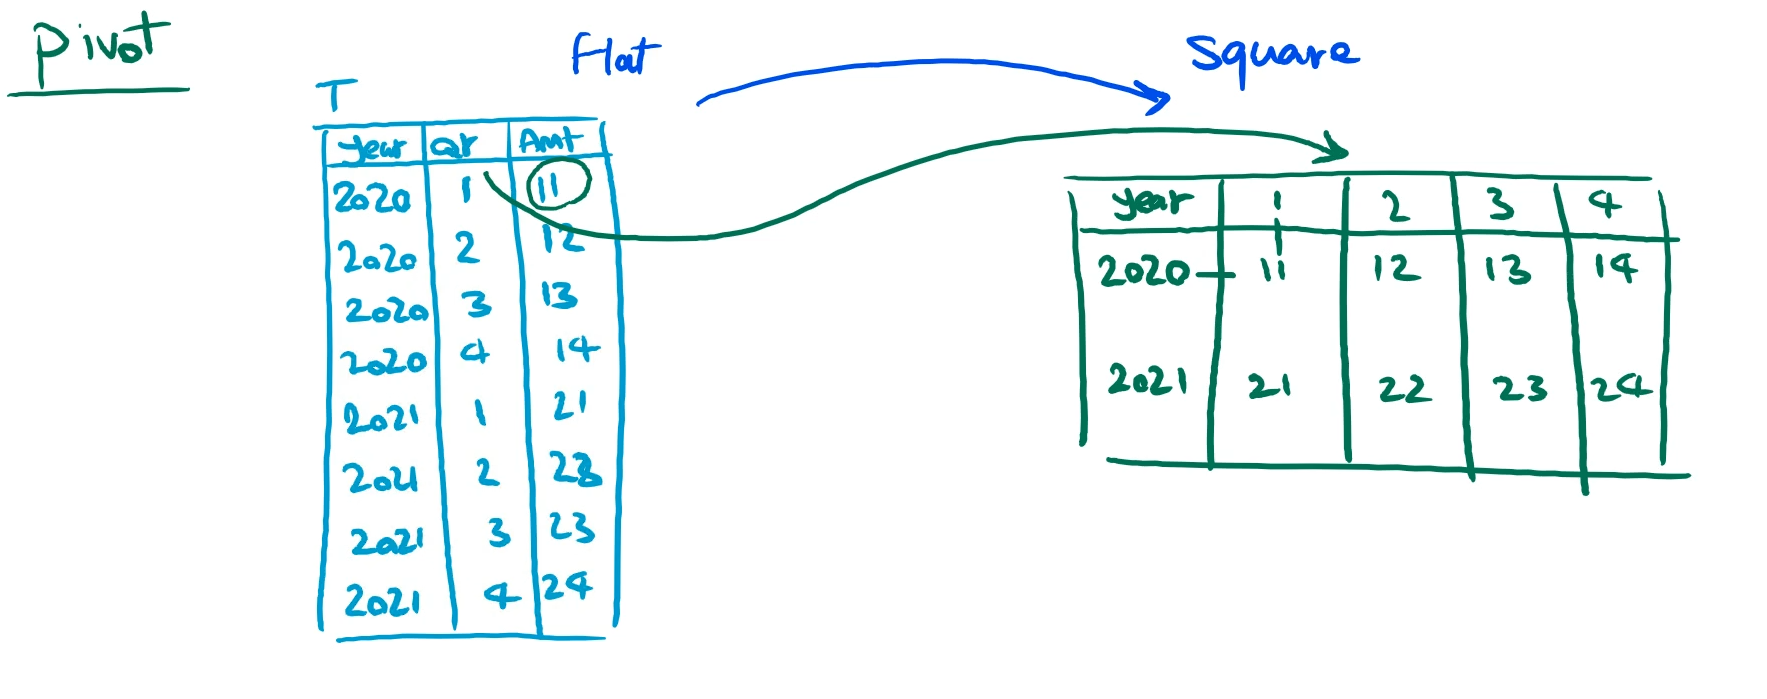
اینجا ما اومدیم دیتامون رو دوبعدی کردیم یعنی اولش به صورت پراکدنده دیتا ها بودن و بعد اومدیم به صورت دوبعدی درستشون کردیم
از سطر و ستون استفاده کردیم
ما بر اساس column های اطلاعاتی مون میتونیم این تقسیم بندی رو انجام بدیم و باید اون ها تکرار پذیر باشند به طور مثال اینجا quarter تکرار پذیره چون همیش 1 2 3 4 هستش مثلا در جای دیگه کد شعب کد نماینگی ها و …
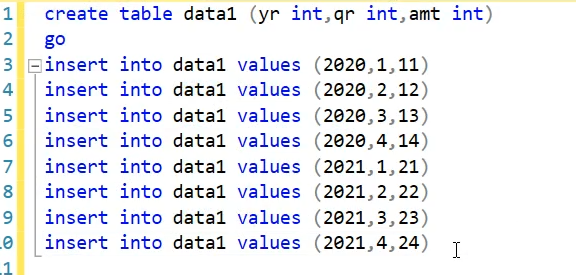
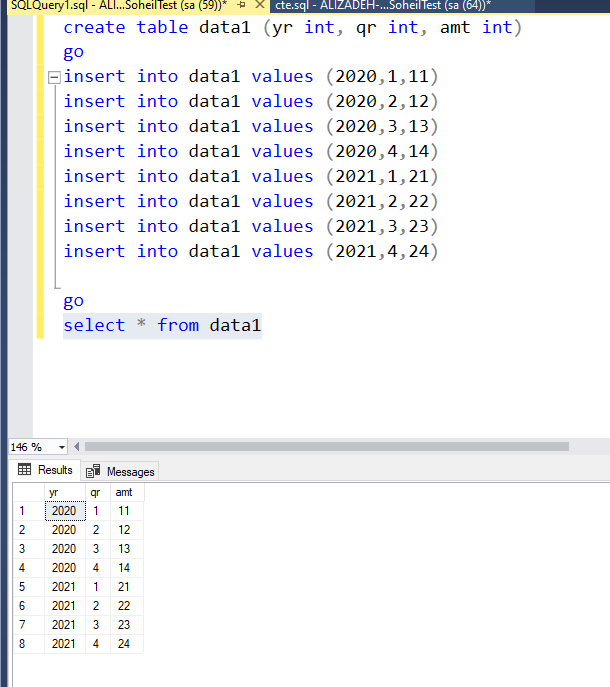
create table data1 (yr int, qr int, amt int)
go
insert into data1 values (2020,1,11)
insert into data1 values (2020,2,12)
insert into data1 values (2020,3,13)
insert into data1 values (2020,4,14)
insert into data1 values (2021,1,21)
insert into data1 values (2021,2,22)
insert into data1 values (2021,3,23)
insert into data1 values (2021,4,24)

go
select * from data1
خوب اینجا select ای باید بزنیم یکیش year هستش و یکی دیگه مقادیر داخل qr
دیتا هایی که میخوایم داخلش رو بخونیم رو باید توی براکت بنویسیم
در فرایند pivot فقط میتونیم 3 تا فیلد رو تاثیر بدیم
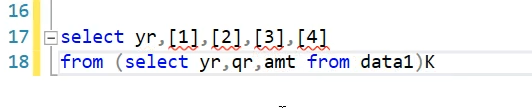
اینجا فقط سه تا میتونیم یعنی این که از yr , qr , amt میتونیم استفاده کنیم که حالا اینحا میتونن اطلاعاتشون از جاهای دیگه بیان
اون جایی که k داره میشه drive table
همیشه drive table و pivot رو باید بهشون اسم بدیم
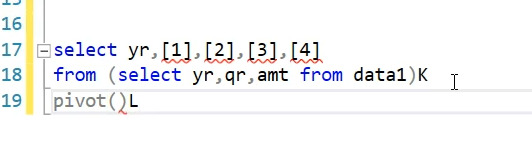
1:32:00
select yr,[1],[2],[3],[4]
from (select yr,qr,amt from data1)K
pivot()L
در داخل پرانتز جلوی pivot باید از aggrigate function ها استفاده کنیم ، هر کدومشون بسته به نیازمون که ایینجا sum هستش
حالا بعدش باید بیایم اون فیلدی که در تقاطع هستش رو بزاریم توی اون sum و بعدش که syntax اش هست for و بعدش اسم فیلدی که بر اساسش ستونی تقسیم بندی رو انجام دادیم
select yr,[1],[2],[3],[4]
from (select yr,qr,amt from data1)K
pivot(sum(amt) for qr in([1],[2],[3],[4]))L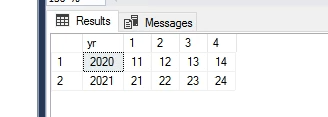
خوب چرا aggrigate گذاشتیم توی دیتا flat ممکنه یه سری دیتا خراب داشته باشیم مثل این دیتا
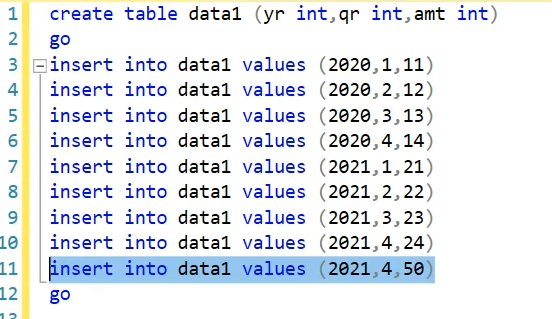
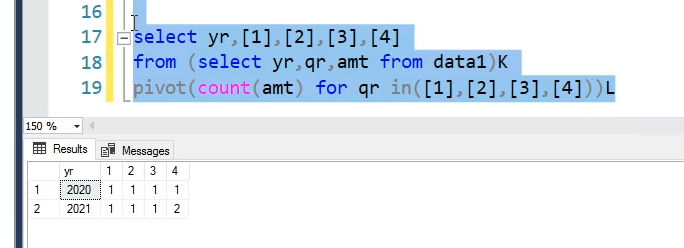
اینجا ما به ازای ماه 4 ام دو تا رکورد داریم که این درست نیست و pivot باید بتونه این ها رو با هم merge کنه از aggriagte ها مختلف هم میتونیم استفاده کنیم
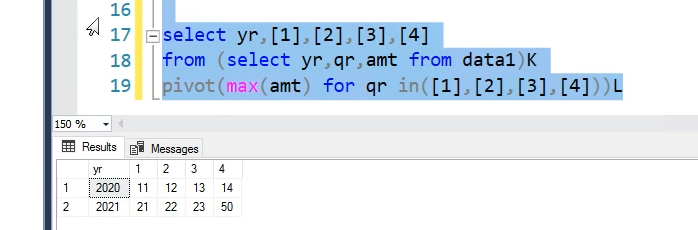
تمرین
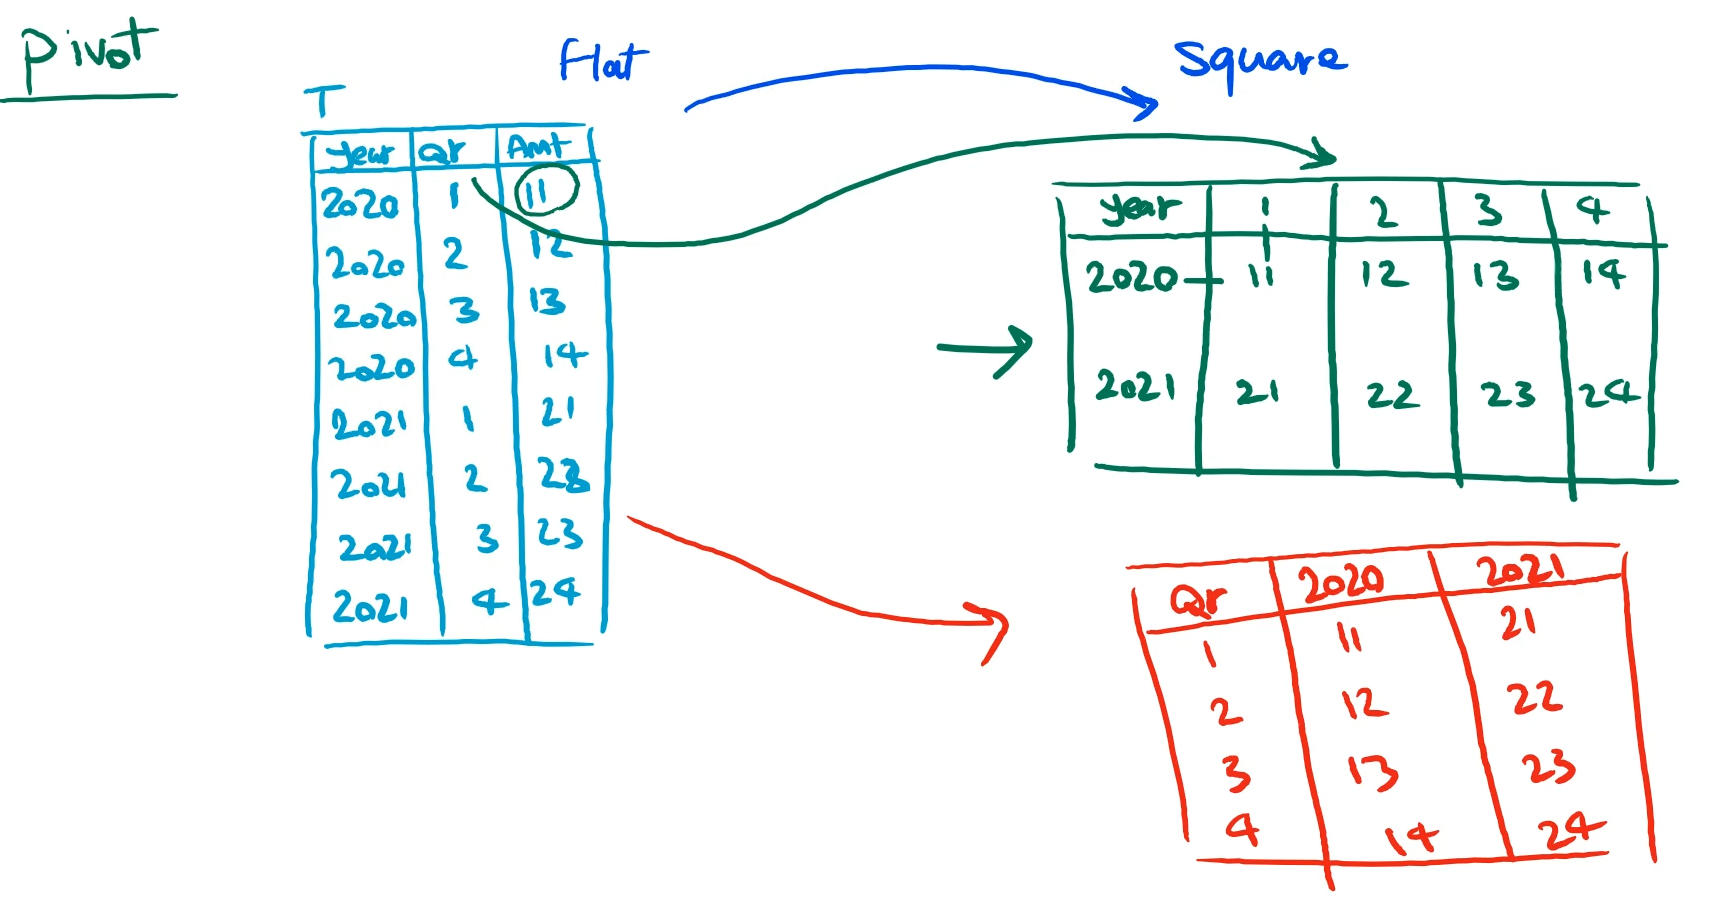
محدودیت در فیلد ها 3 تا ، میتونیم اینا رو از جدول ها و join های مختلف برداریم
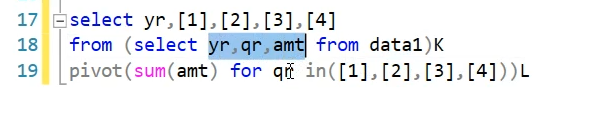
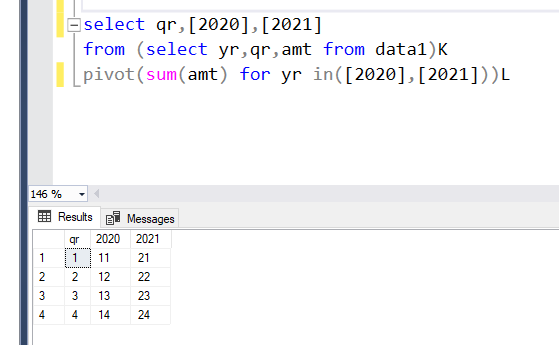
select qr,[2020],[2021]
from (select yr,qr,amt from data1)K
pivot(sum(amt) for yr in([2020],[2021]))L
شروع قسمت دوم
خوب در بعضی از موارد ما دیتا ها رو داریم مثلا توی اکسل که به صورت pivot شده است حالا ما میخوایم بیایم اون دیتا ها رو برزیم توی دیتابیس برای همین باید بیایم دوباره دیتا ها رو فلت کنیم
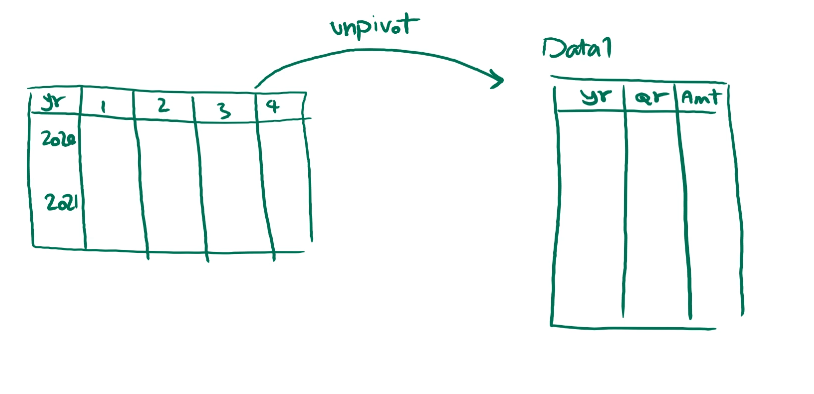
اول میایم اون دیتا رو import میکنیم توی جدول دیتابیس و بعد جدول رو unpivot میکنیم
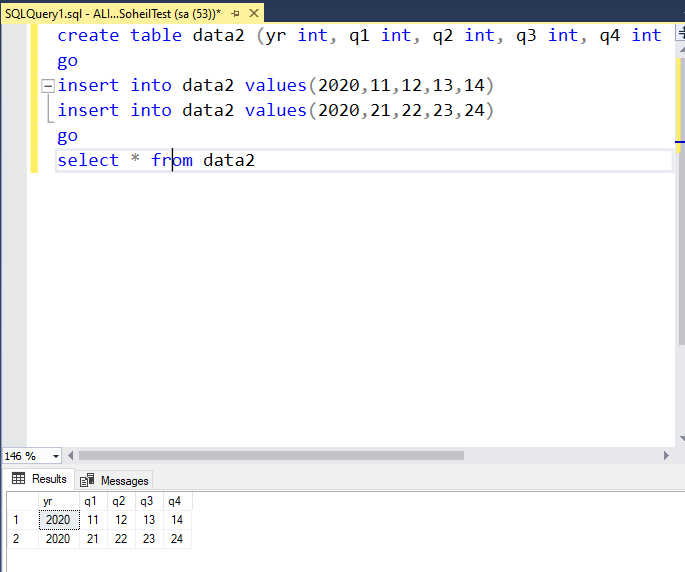
خوب اینجا go به این منظوره که اگر ما به ارور خوردیم توی خط بالایی - اون رو رد میکنه و لاین های بعدی رو اجرا میکنه
4:56
create table data2 (yr int, q1 int, q2 int, q3 int, q4 int )
go
insert into data2 values(2020,11,12,13,14)
insert into data2 values(2020,21,22,23,24)
go
select * from data2
خوب وقتی که میخوایم unpivot کنیم باید بیایم فیلد هایی که نداریم رو پیدا کنیم اینجا الان ما year رو داریم ولی amt , qr رو نداریم - دیتاش رو داریم در جدول میبینم ولی خوده فیلد رو نه
هر جا که میخوایم unpivot کنیم به ازای اون دو تا فیلد دیگه که بر اساسش اومدیم ستونی تقسیم بندی رو انجام دادیم
برای اون فیلد ها میایم یه اسم به دلخواه درنظر میگیریم
بغد از این که unpivot نوشتیم باید توش اول بنویسیم که توی cell های اون جدول از چی استفاده کردیم که ما از amount استفاده کردیم
,و بعدش از چیزی که اومدیم و ستونی تقسیم بندی رو انجام دادیم
select yr,quarte,amount
from data2
unpivot(amount for quarte in ([q1], [q2],[q3],[q4] ))L 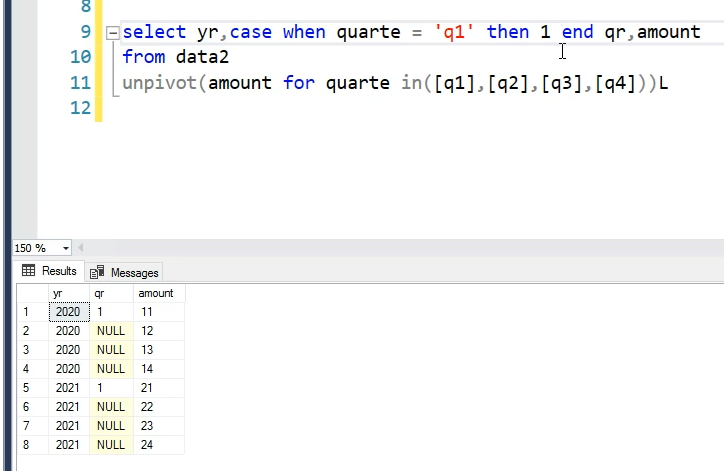
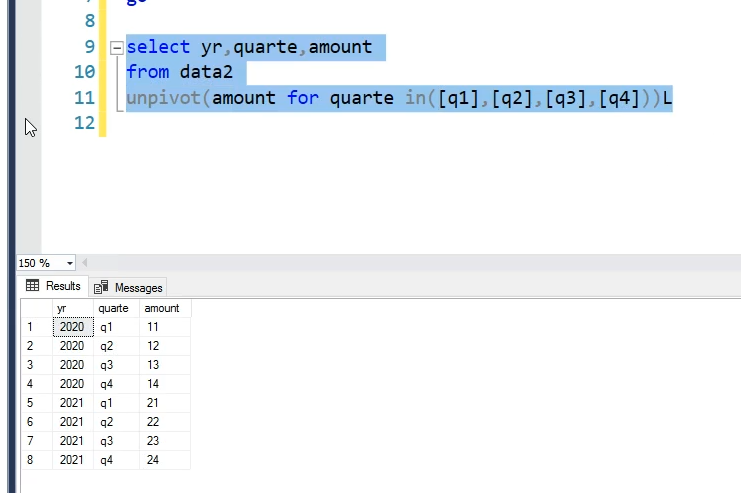
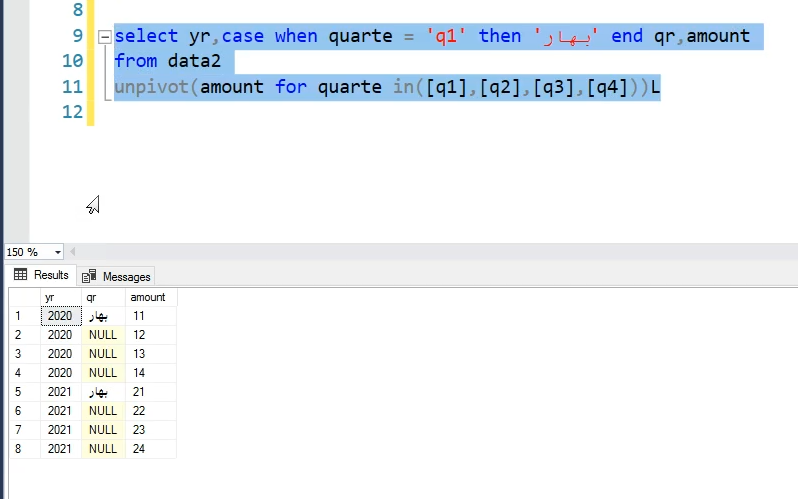
خوب case when برا اساس یه شرطی ماهیت دیتا رو عوض میکرد
10:27
راه حل ها سوال قبلی:
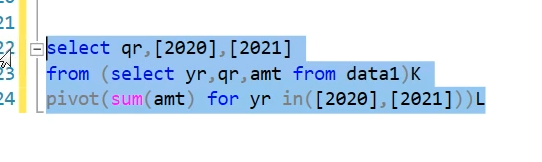
select qr,[2020],[2021]
from (select yr,qr,amt from data1)K
pivot(sum(amt) for yr in([2020],[2021]))L
میرسیم به insert update dalete مختص فقط برای دیتاهای داخل جدوال هستش خوب later , create , drop مختص برای تمامی آبجکت ها در sql هستش
خوب drop ساختار و کل جدول رو حذف میکنه
ولی اگر بنویسیم delete فقط دیتاهاش پاک میشن
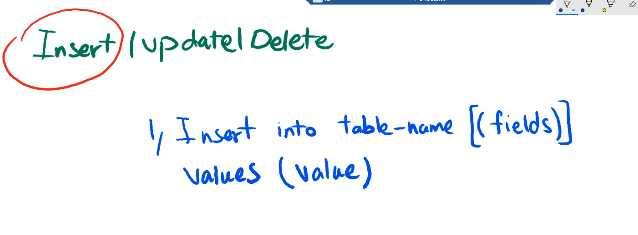
خوب اینجا ما sigle insert داریم - اون قسمت توی پرانتز اختیاری هستش ولی ما همیشه بنویسیم بهتره توی اینجا میایم اسم فیلد هایی که میخوایم رو مینویسیم و توی Value هم مقادیری که میخوایم وارد جدول کنیم
مورد بعدی
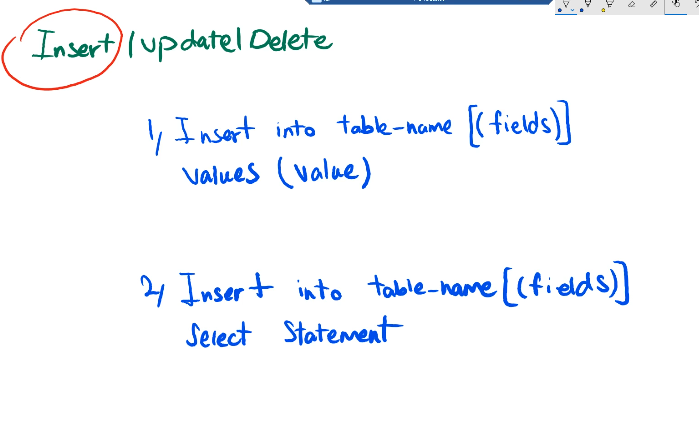
خوب توی حالت bulky insert ما میایم data رو اول میخونیم از یه جدولی و بعد میایم وارد یه جدول دیگه میکنیم
23:52
create table data3(code int primary key,name varchar(50))
go
select * from data3
go
insert into data3(code,name) values (1,'soheil')

insert into data3 values(2,'sepehr')
26:11
خوب بهتره که اسم فیلد ها رو بنویسیم ، الزامیه یعنی code , name رو بنویسیم به تعداد فیلد هایی که مینویسیم باید براش value بنویسمی
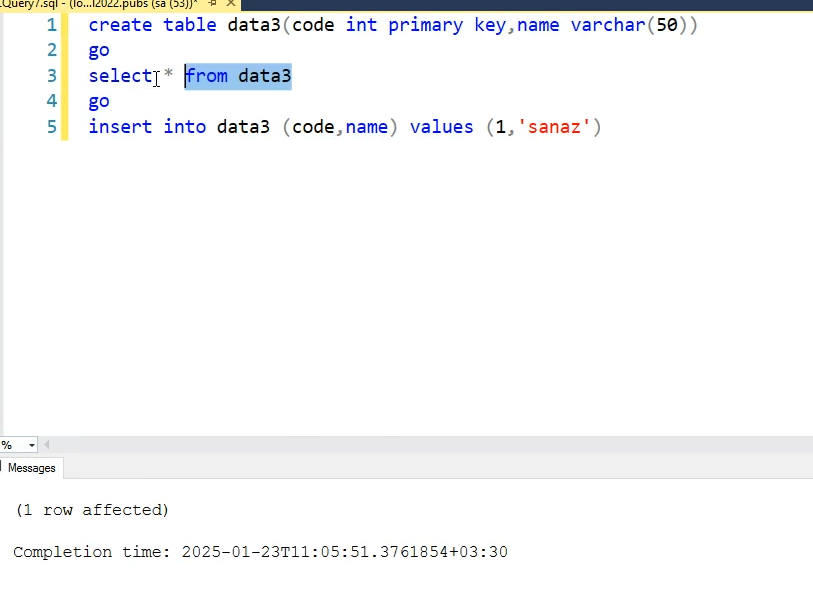
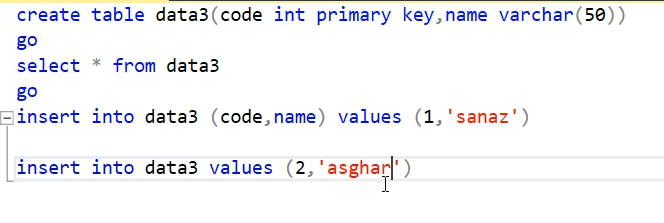
خوب اینجا ترتیب هم مهمه
خوب اگر به این شکل پایین بنویسیم
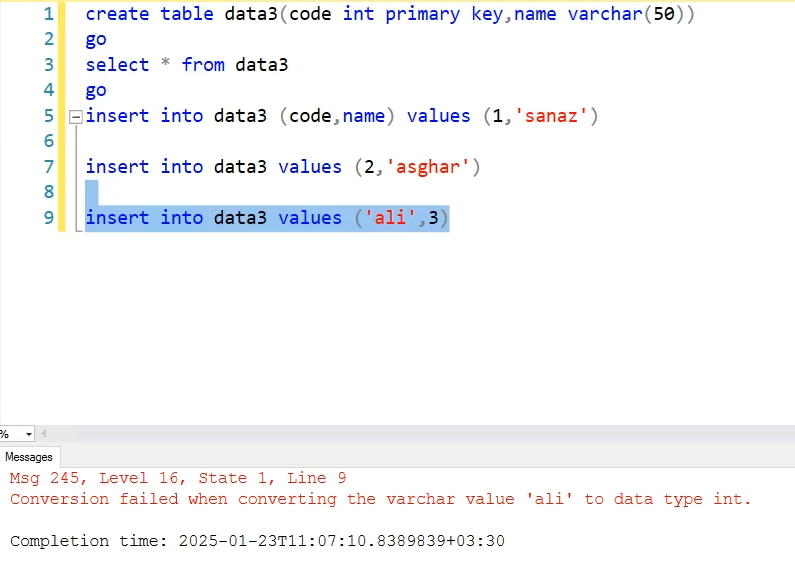 اینجا insert نمیشه چون ترتیب دیتا ها با ترتیب فیلد ها نمیخونه
حالا ممکنه هر دوتاشون first name , last name هستش ممکنه جابه جا وارد بشه که درست نیست - پس در نتیجه بهتره که همیشه اسم فیلد ها رو بنویسیم
یه قابلیت دیگه ای که بهمون میده اینه که میتونیم ترتیب اسم فیلد ها رو جا به جا کنیم
خوب حالا در نظر بگیرید که ما یه جدول داشته باشیم که 40 تا فیلد داشته باشه حالا اگر بخوایم یه چیزی رو وارد ستون 20 ام کنیم باید ببریم و دقیقا توی فیلد 20 ام وارد کنیم
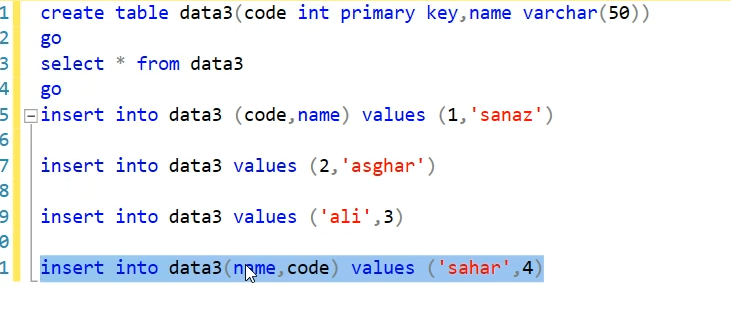
مثلا فکرکنید که این فیلد email هستش
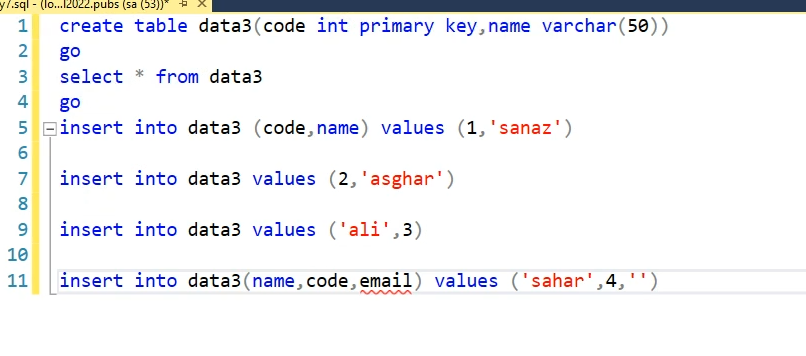
اینطوری دیگه نمیخواد بریم بشمریم که مثلا email فیلد چندمه
30:00
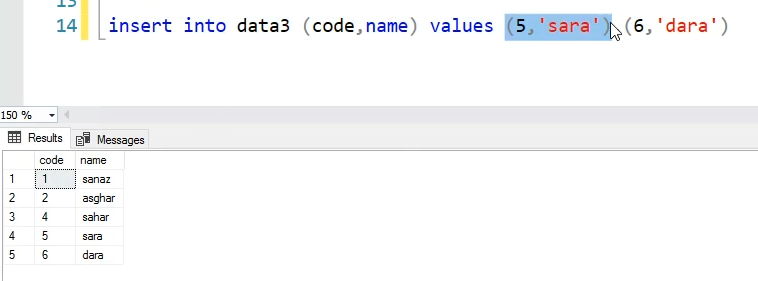
خوب اینطوری 2 تا خط کد رو تبدیل به یه خط کردیم ولی مشکلش اینه که اگر دیتای اولی مشکل داشته باشه و به خطا بخوره دیگه بعدی ها عمل نمیکنه
ولی اگر برای هر دیتا insert into جدا بنویسیم دیگه فارق از این که بالایی به ارور بخوره پاییننیه اجرا میشه
31:40
create table data3(code int primary key,name varchar(50))
go
select * from data3
go
insert into data3(code,name) values (1,'soheil')

insert into data3 values(2,'sepehr')

insert into data3 (code,name) values (5,'hasan'),(6,'ali')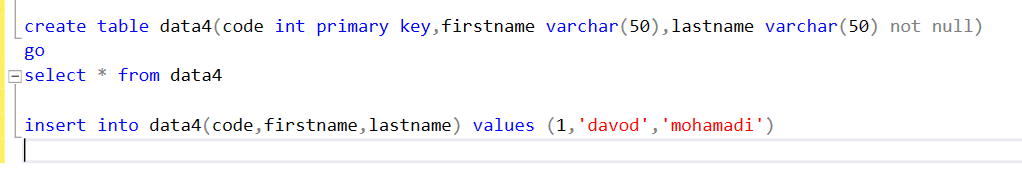
create table data4(code int primary key,firstname varchar(50),lastname varchar(50) not null)
go
select * from data4

insert into data4(code,firstname,lastname) values (1,'davod','mohamadi')
حالا اگر ما به ازای Firstname هیچ چیزی نداشته باشیم

insert into data4(code,lastname) values (2,'molavi')
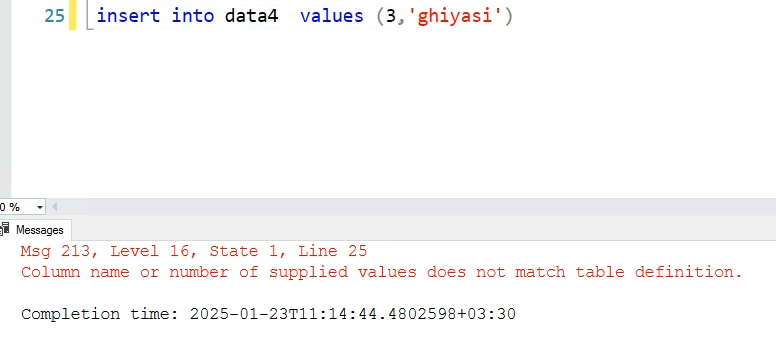
اینجا به ارور میخوره چون که نمیدونه قیاسی رو باید توی کدوم فیلد بزاره
خوب اینجا میایم
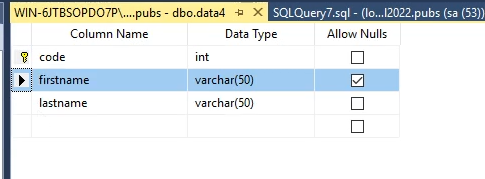 تعیین میکنیم که یه مثدار پیش فرض برای FIRST NAME تعیین کنیم
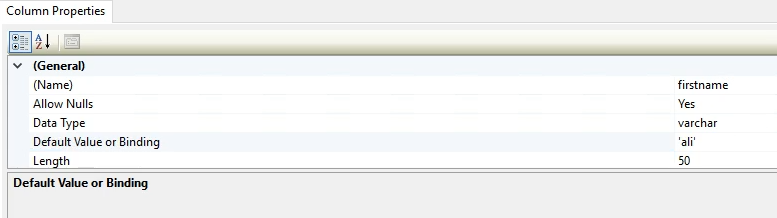
اونجا deafult value رو ست میکنیم
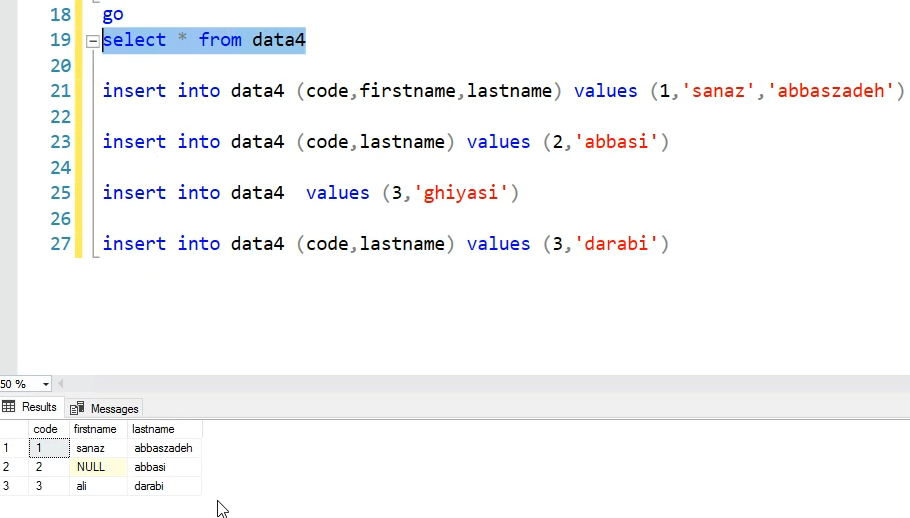
اینطوری میشه
وقتی که null باشه Sql میره از روی پیش فرض ها میخونه و قرار میده
خوب این اینجا به کار میاد که Entry date رو با get date میتونیم بزاریم
وقتی که مقدار null بهش پاس بدیم میره و از روی اون مقدار پیش فرض میخونه
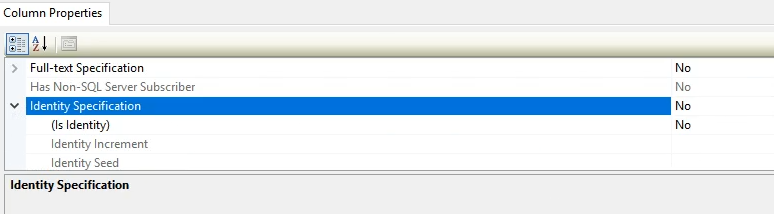
اگر فیلد از جنس عدد رو بیایم و is identity اش رو رو true میکردیم ، بعدش میومد به صورت incrimental این فیلد رو بالاتر میبرد
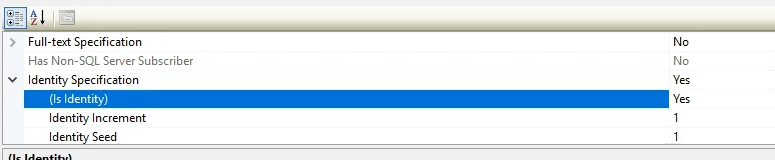
اینجا از 1 شروع میکنه و یکی یکی میبره بالا
خوب identity رو هم نمیخواد و نمیشه که بهش مقدار بدیم
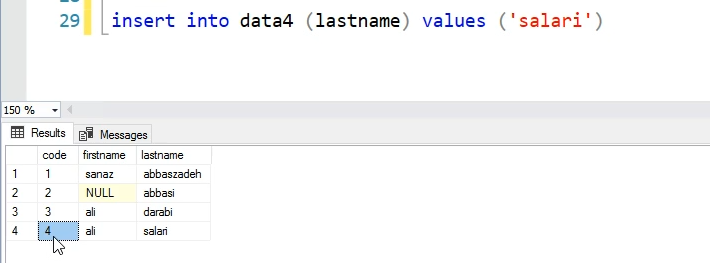
خوب انیجا 4 رو خودش درست کرد و مقدار ali رو خودش به صورت پیش فرض برداشت
خوب حالا میرسیم به bulky
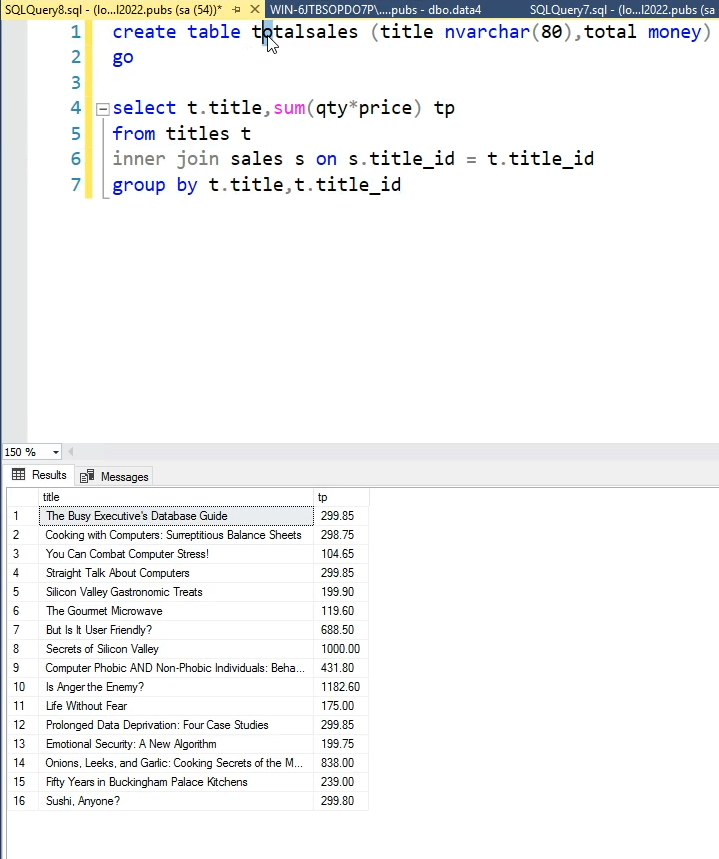
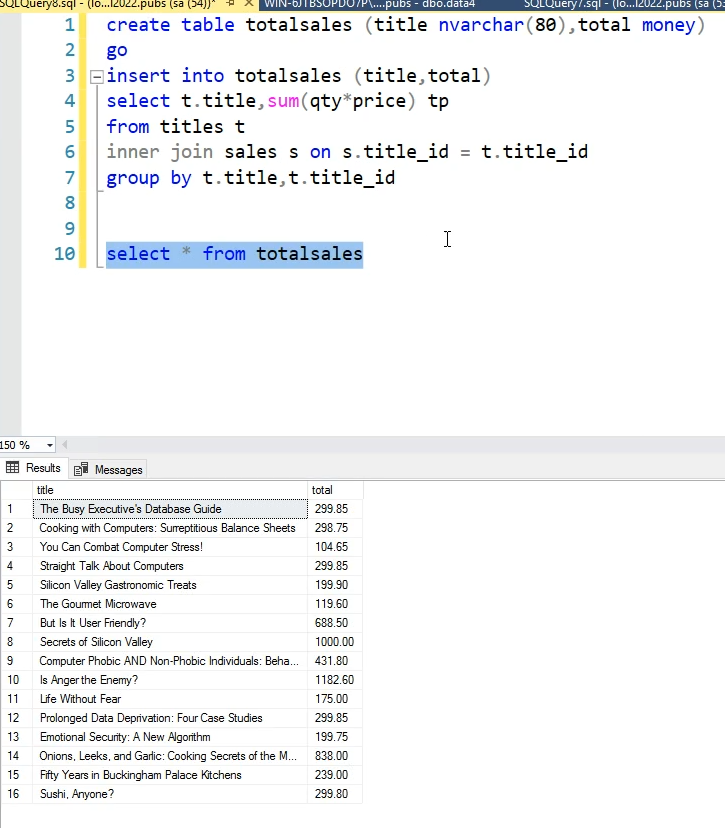
کوئری بنویسیند که نام کتاب و مبلغ فروش کتاب ها رو بهمون بده
حال با توجه به کوئری ساخته شده جدول total sales را پر کنید
توی database pub بنویسیمش
خوب redgate میاد به ssms یه چیزی مثل resharper بهمون میده و shortkey بهمون میده
تناظر بین join ها بهمون نشون میده
باید ببینم که کدوم ورژن redgate با اون ورژن ssms میخونه
بعدش
خوب حالا مخوایم از یه جدول بیایم و بک اپ بگیریم
میخوایم قبل از این که update انجام بدیم میخوایم ببینیم که چه شکلی بوده که بتونیم مقایسه کنیم ، و اگر بیایم بک اپ کلی بگیریم - خیلی حجمش زیاد میشه
57:16
از یه کوئری که نوشتیم میتونیم جدول بسازیم و ازش بک اب بگیریم و ازش استفاده کنیم
خوب اول select میکنیم میریزیم توی یه جدول دیگه
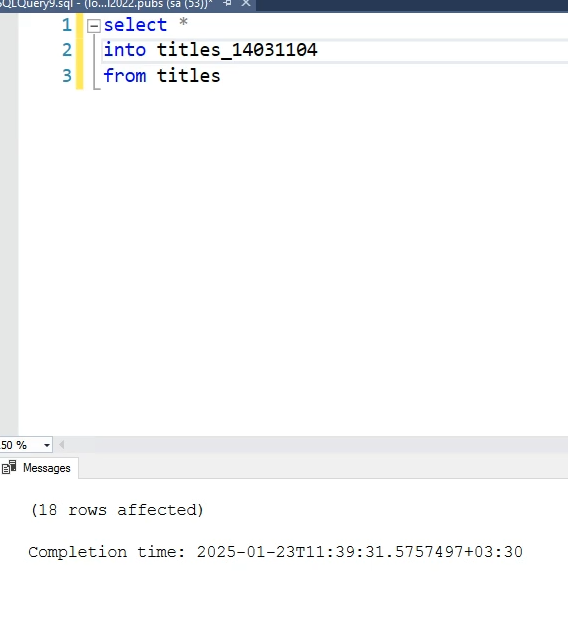
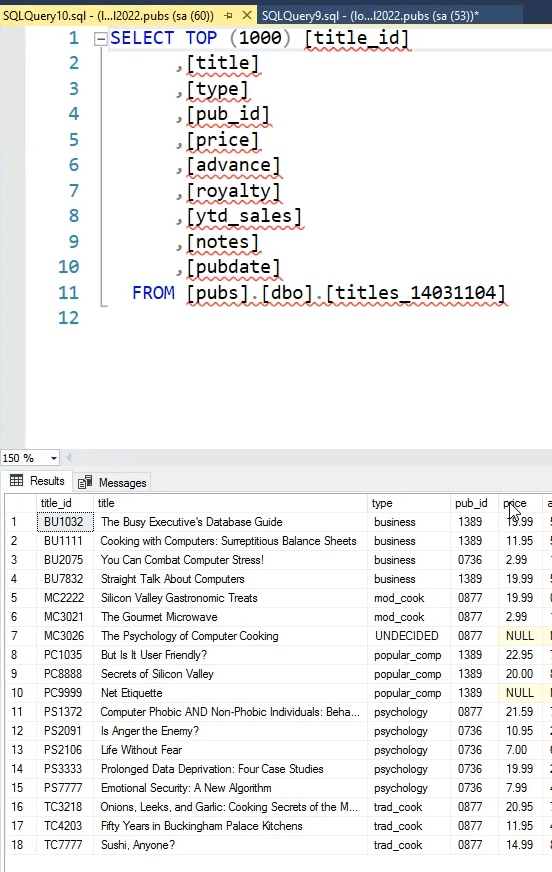
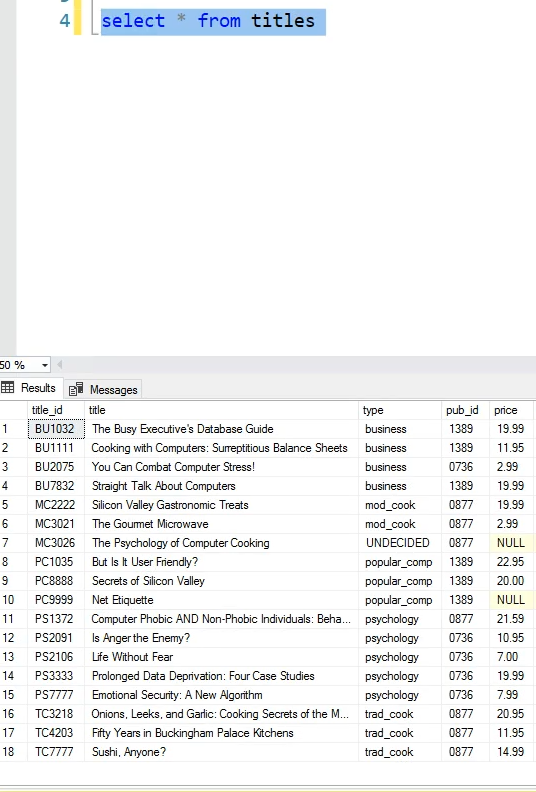
الان این شکلی میشه که اومدیم از جدول titles اومدیم به تاریخ 1403.11.04 بک اپ گرفتیم اینجا دیگه PK , FK دیگه معنی نداره
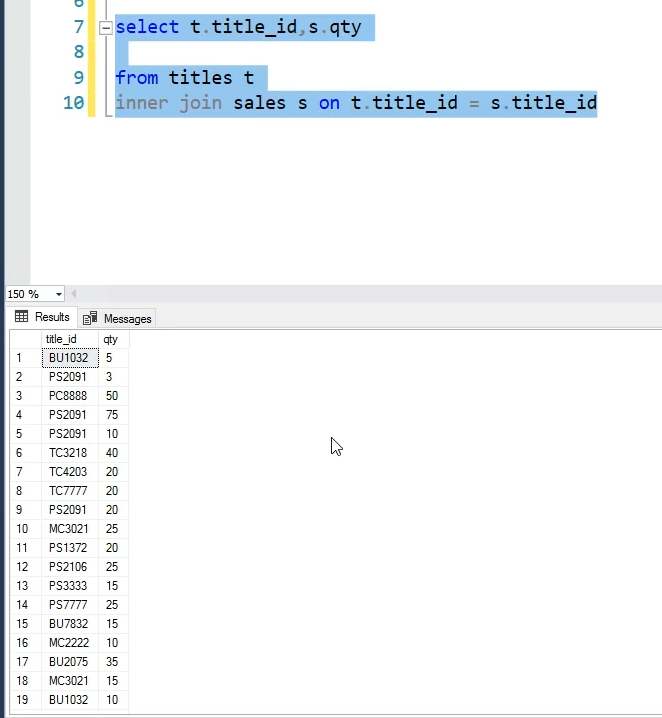
خوب توی عکس بالا اومدیم select زدیم و یه دیتایی رو بدست اوردیم و این دیتا هارو میتونیم ببریمش توی یه جدول دیگه بزاریم
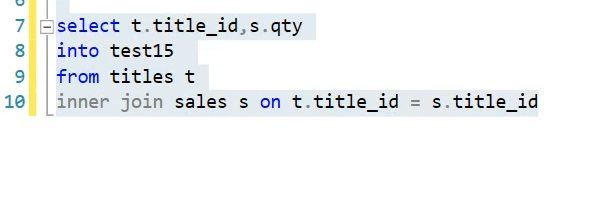
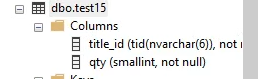
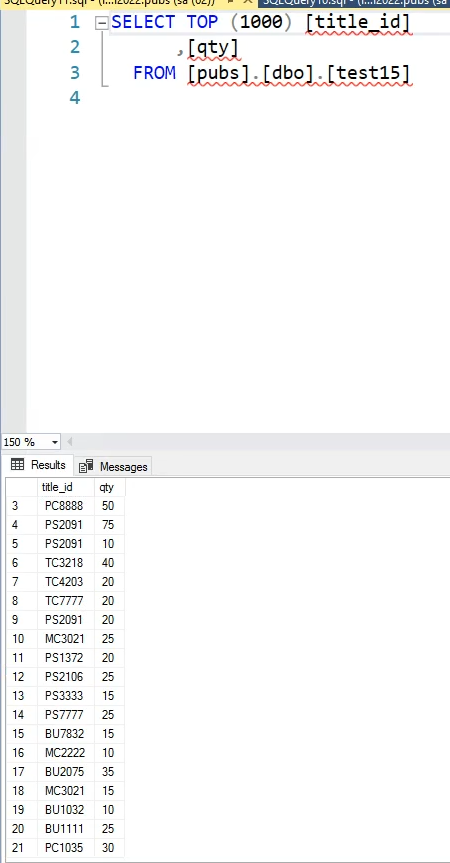
خوب جدول کپی میاد ، اسم فیلد ها رو از همین select عه برمیداره و دیتا تایپ ها رو هم از جدول ها میگیره
چون این select هستش و دگه FK , PK نداریم
یعنی index , constrain ها رو نمیاره
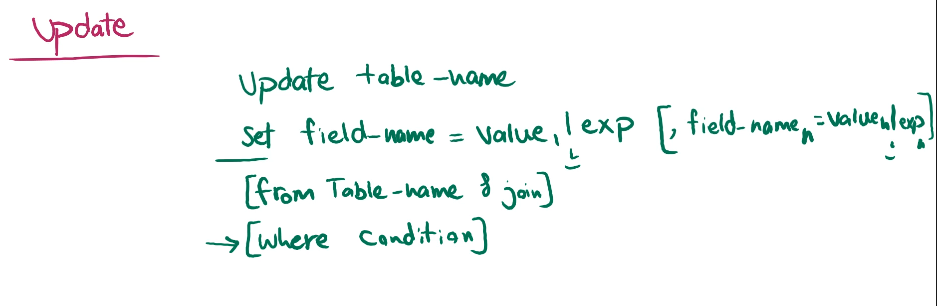
خوب اول update و بعد اسم جدول و بعد set و بعد اسم فیلدی که میخوایم تغییر بدیم و بعد برابر یه مقداری میزاریمش که میشه Value
میتونیم یه expression هم بهش بدیم مثلا price رو ضربدر 1.1 کن و غیره
و به صورت optional میتوینم چند تا فیلد رو با هم آپدیت کنیم
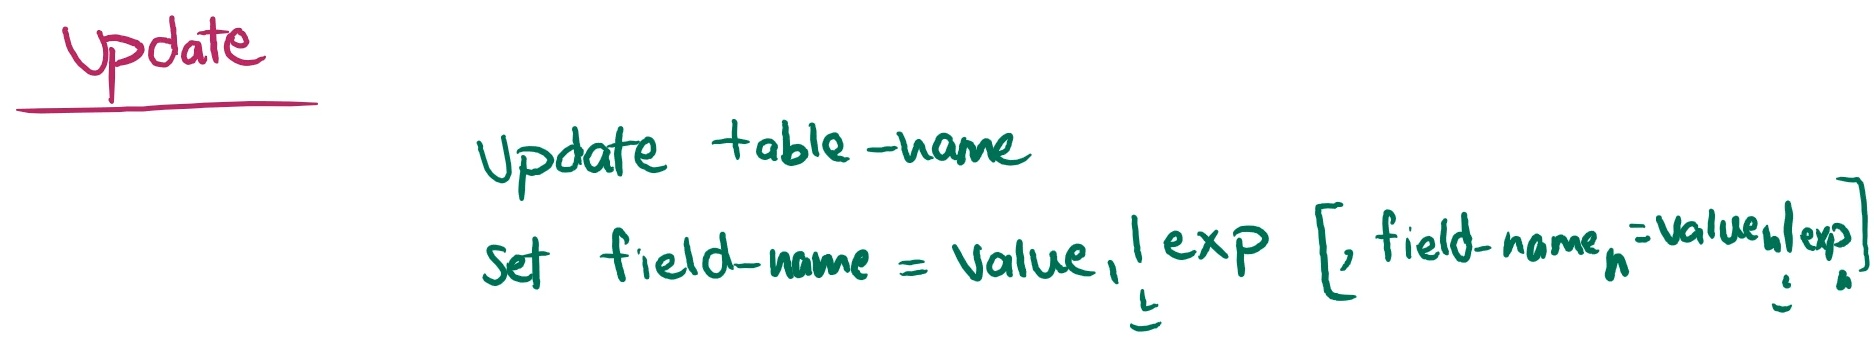
مثلا هم نام کتاب و هم قیمتش رو بیایم آپدیت کنیم
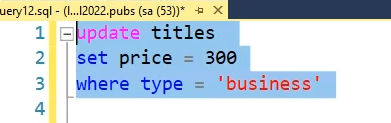
خوب در حالت عادی update میره روی همه اجرا میشه برای همین باید condition داشته باشیم
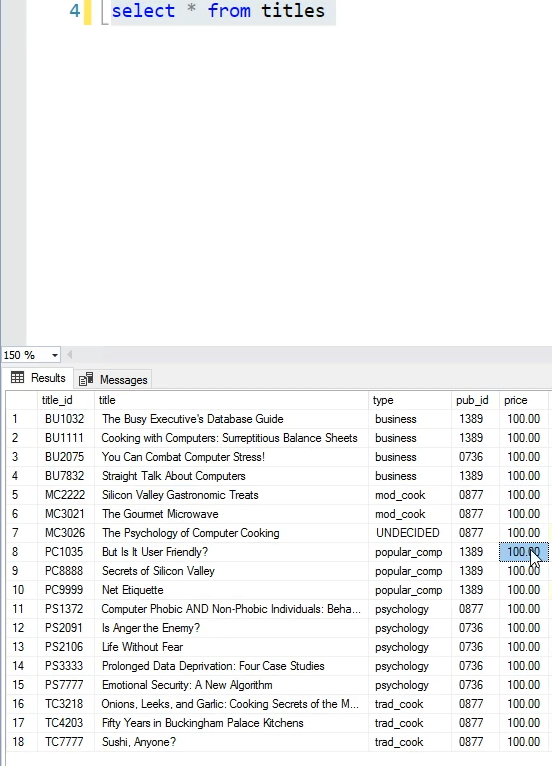
اگر این رو اجرا کنیم ، اینطوری میشه :
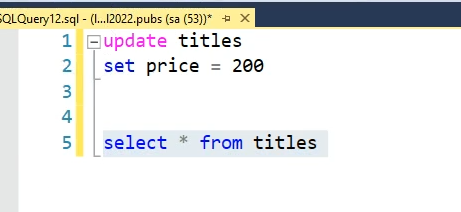
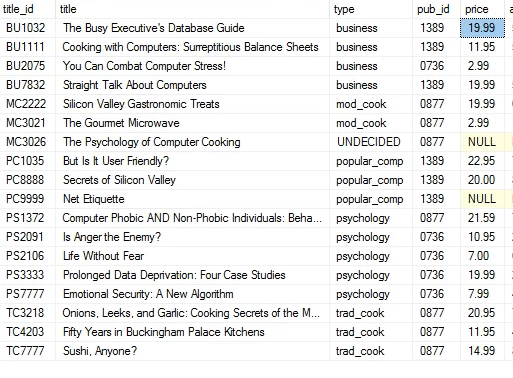
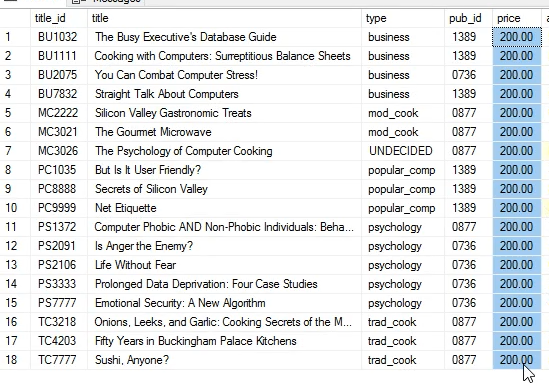
اینطوری دیتا ها همه میشه 200
حالا با شرط
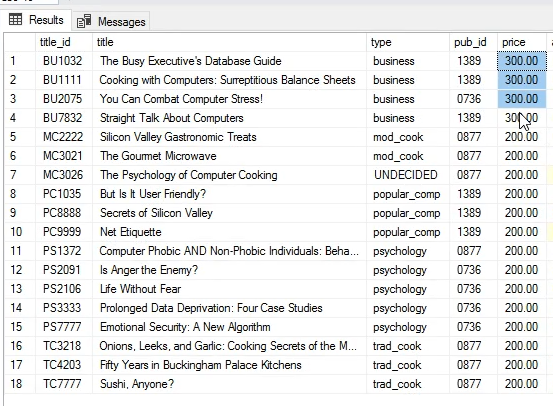
1:09:50
اینجا چون transation نزدیم نمیتونیم دیتاهایی رو که تغییر دادیم رو برگردونیم
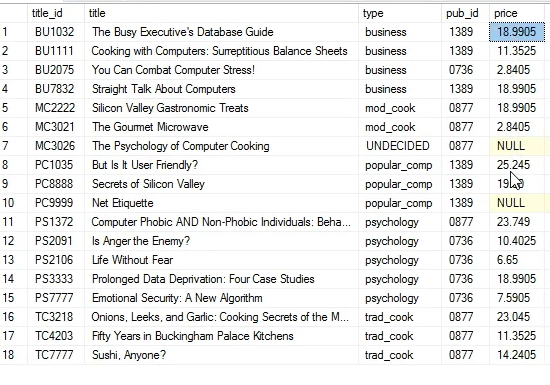
آپدیتی بنویسیم که بر اساس این قانون - اگر قیمت کتاب بیش از 20 دلار باشد 10 درصد افزایش قیمت در غیر این صورت 5 درصد کاهش قیمت - قیمت کتاب را به روز آورید
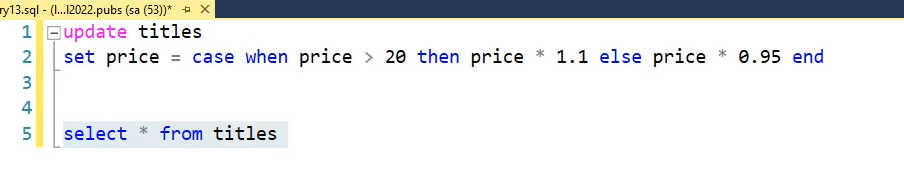
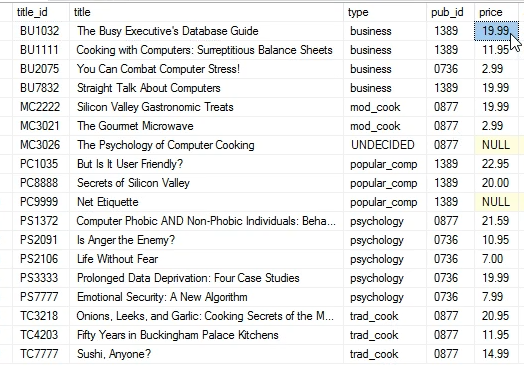
بعد از اجرا :
حالا کوئری بنویسید که قیمت کتاب رو بر اساس این قانون که اگر ناشر کتاب کالیفرنیای باشد 10 درصد افزایش قیمت در غیر این صورت 5 درصد کاهش قیمت
الان ما update مون رو داریم روی جدول titles میزنیم ولی نیاز داریم به جدول publishers و برای همین ما نیاز داریم که join بزنیم
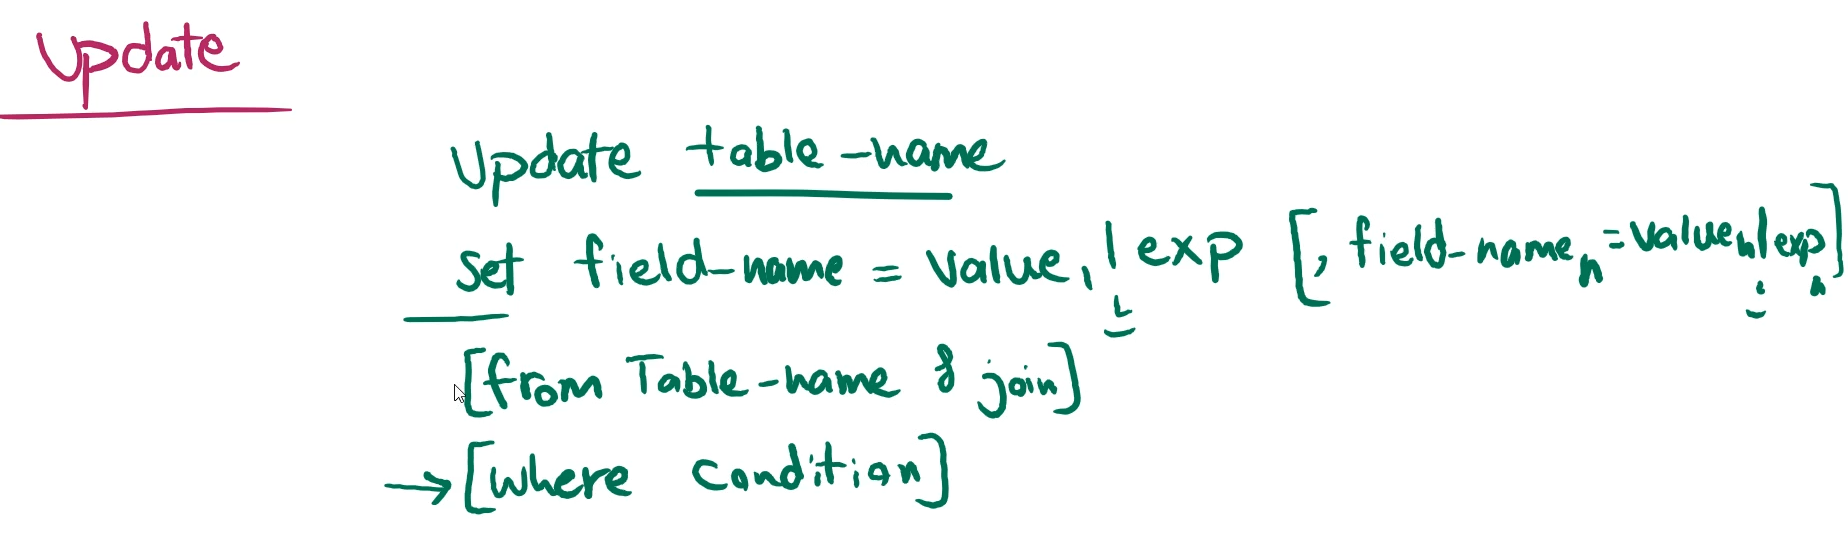
الان میخوایم به فیلد state در جدول publishers برسیم
نکته خیلی مهم: همیشه وقتی که احتیاج داشتیم به colum های اطلاعاتی دیگه در جداول دیگه - همیشه from رو بزاریم روی جدولی که داریم روش آپدیت میزنیم و join رو بزنیم روی اون یکی جداول
این سوال بیش از دو راه حل داره و با sub query هم میشه حلش کرد
1:24:53
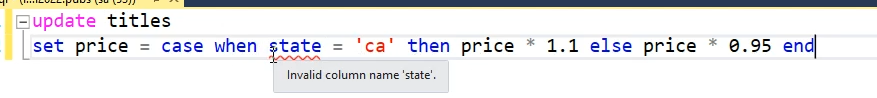
خوب state برای جدول titles نیست و برای همین بهمون ارور میده
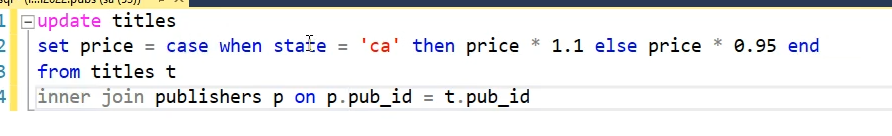
حالا اگر نخوایم join بزنیم این کار رو میکنیم :
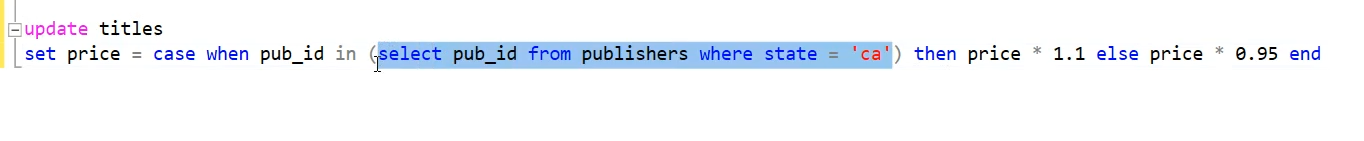
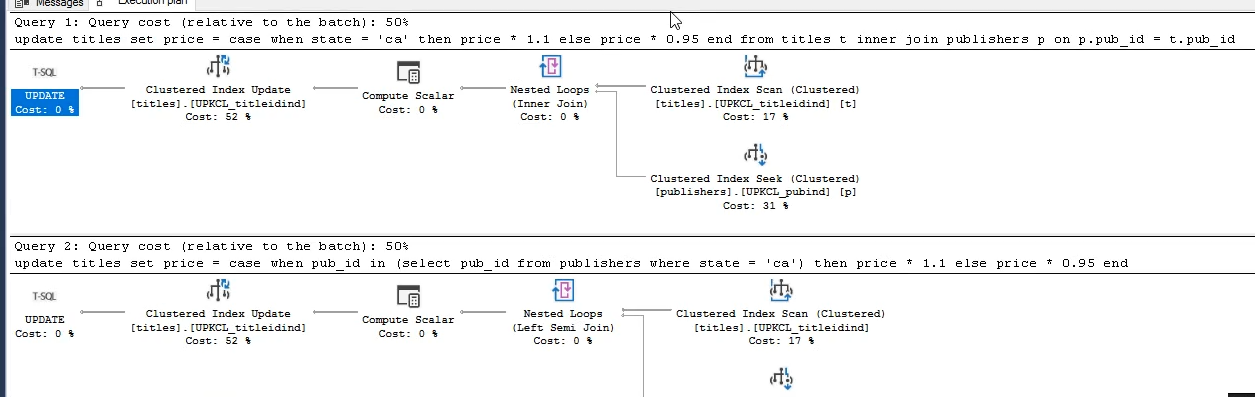
خوب مدل دومی بهتره - چون که فقط میاد اون هایی که توی state عه ca هستش رو میاد join میزنه ولی اون یکی میاد کلش رو join میزنه
قیمت کتاب بر این اساس - اگر مبلغ فروش کتاب بیش از 500 دلار بود 10 درصد افزایش قیمت در غیر این صورت 5 درصد کاهش قیمت
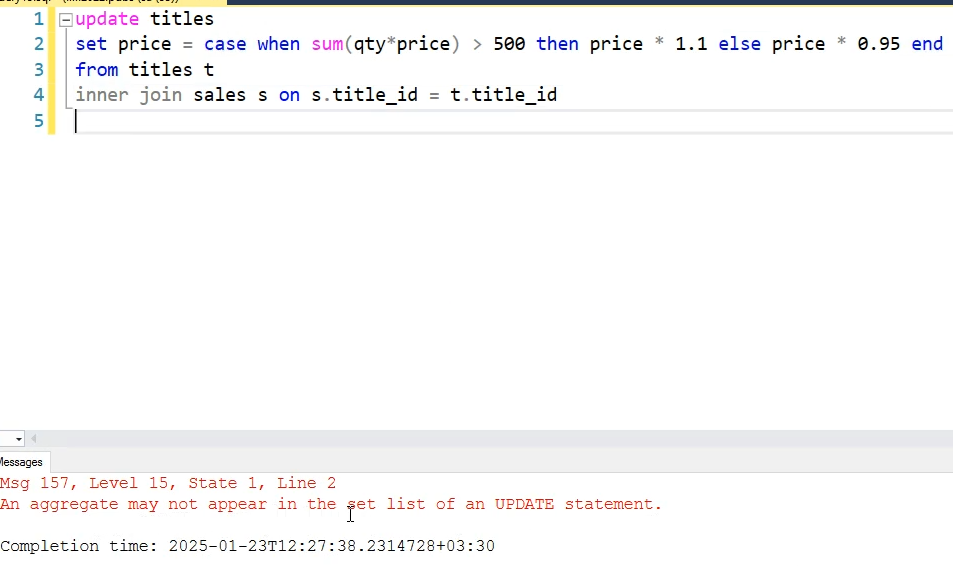
این مورد بالا اشتباه است
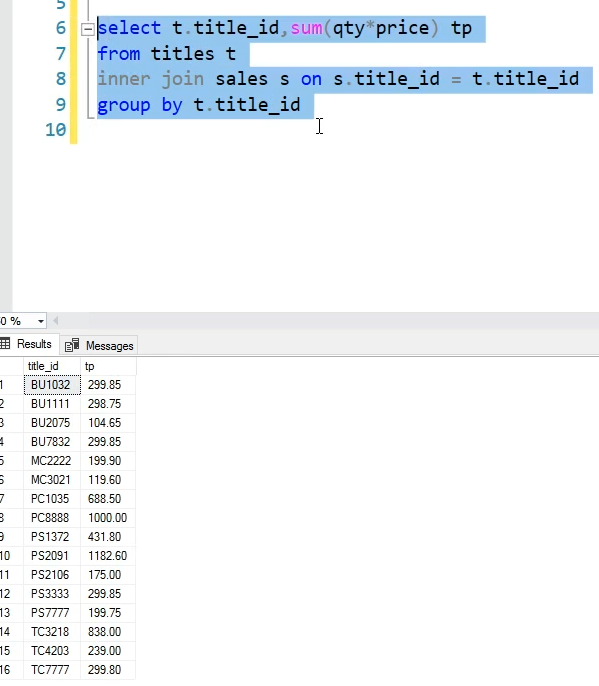
-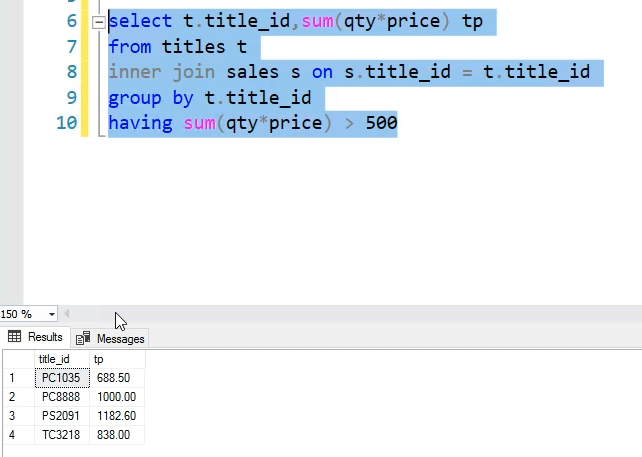
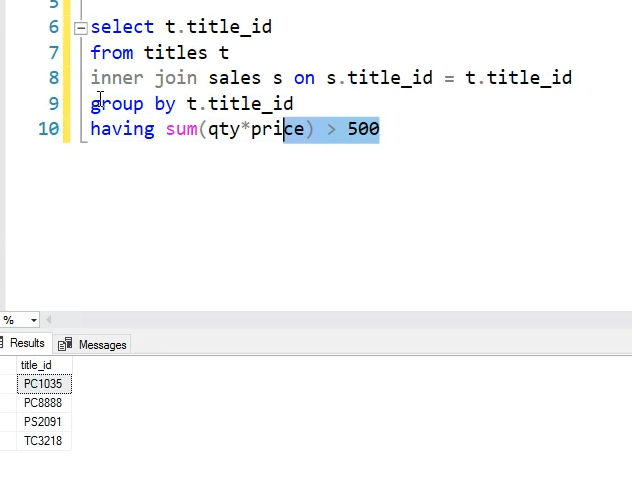
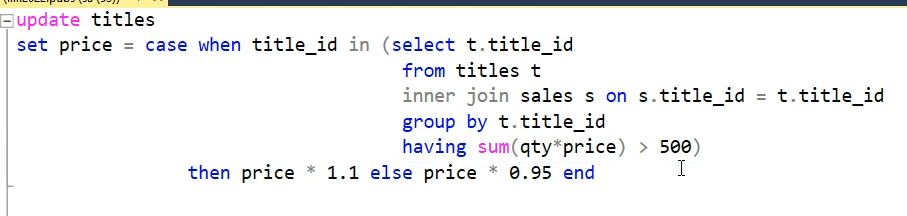
راه اول بالاییه
راه دوم :
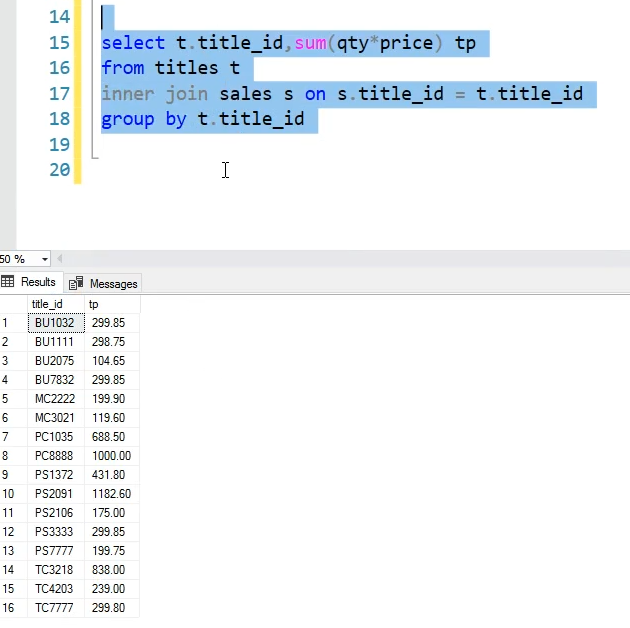
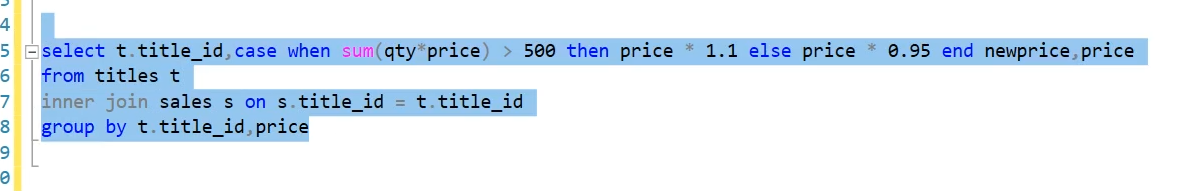
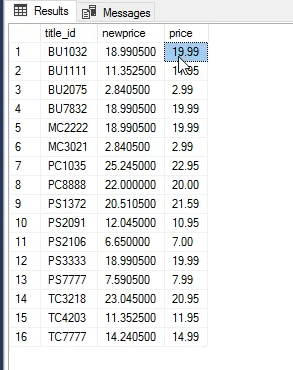
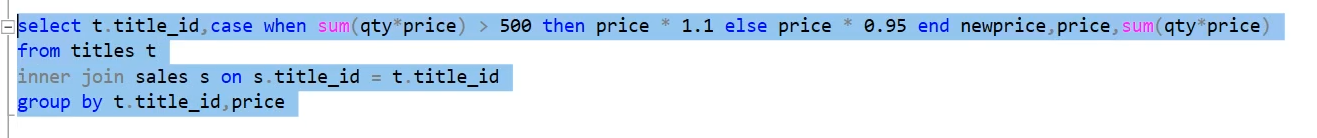
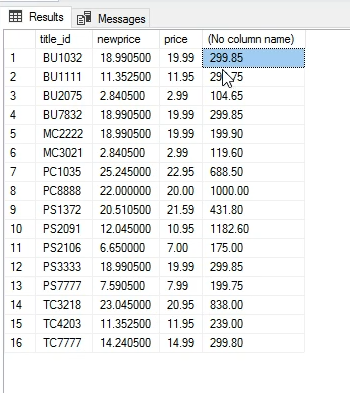
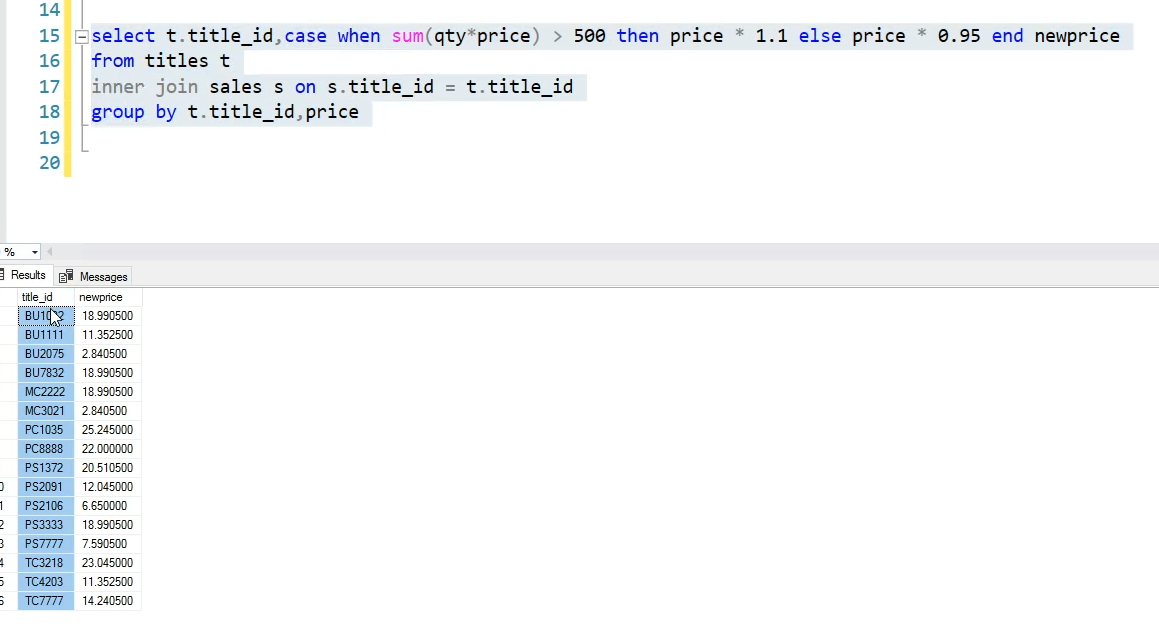
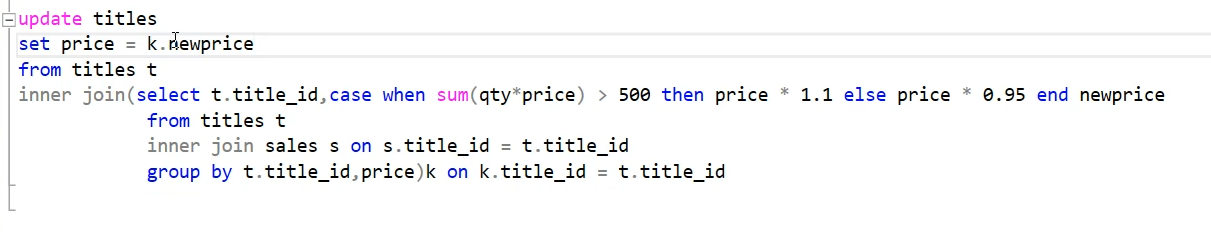
از این راه حل میتونیم تست کنیم و ببینیم چون select داریم ولی در راه اول اینطور نیست
توی راه اول ما new price رو تا موقعی که update نشه نمیبینیم و این خوب نیست
وقتی میخوایم آپدیت بنویسیم - اول میایم select مینویسیم و بعد میایم تبدیل اش میکنیم به drived table و بعد join
در مثال قبلی
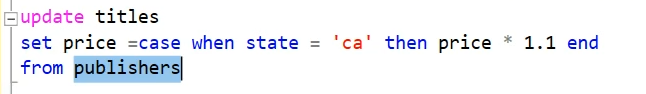
اینجا رابطه ای بین جدول titles و publisher وجود ندارد و اینجا ممکن است update اشتباه انجام شود
برای همین میایم from رو میزاریم که بگیم از کجا شروع میشه و بعد join اش کنیم
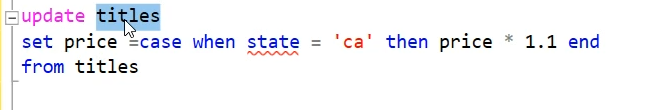
همیشه from رو بزاریم روی title و بعد بیایم join اش کنیم
1:57:0
آخرین کوئری : آپدتی بنویسیم که قیمت کتاب رو بر اساس این قانون به روز رسانی کند
قانون : اگر ناشر کالیفورنیای باشد 10 درصد افزایش قیمت در غیر این صورت اگر کتاب بیش از یک نویسنده داشته باشد 5 درصد افزایش قیمت
در غیر این صورت اگر مبلغ فروش کتاب بیش از 500 دلار باشد 2 درصد افزایش قیمت
و در غیر همه این صورت ها 1 درصد افزایش قیمت داشته باشد
این بالایی تمرینه
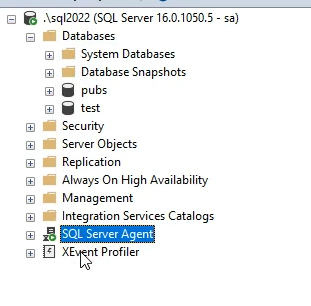
اگر غیر فعال بود
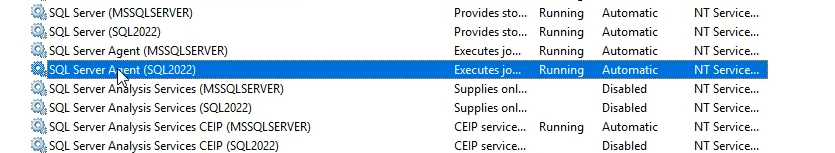
میریم فعالش میکنیم
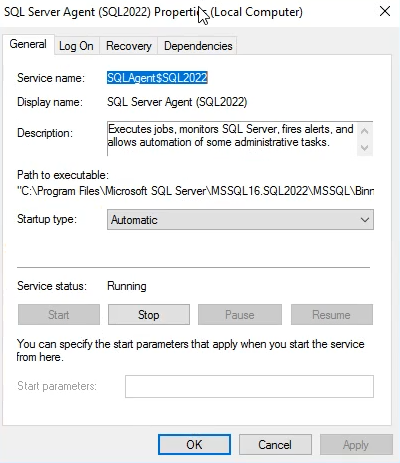
اگر manual بود وقتی که shut down میشه خاموش میشه و دستی خودمون بعد از روشن کردن باید فعالش کنیم
یه کارش ساختن job هستش
مثلا ساختن بک اپ یا شب به شب - rebuild index رو انجام بدیم در هر شب یا شب به شب - اول بک اپ و بعد rebuild index و … خوب job میتونه زمان بندی داشته باشه - میتونه هم نداشته باشه وقتی که زمان بندی نداشته باشه میتونیم خودمون یه سری کارها رو انجام بدیم بعد بزنیم اون job ها انجام بشه
مثلا جزیمه تاخیر در ماه 1 بار انجام میشود حالا ممکنه 5 ام ماه باشه و ممکنه 1 ام باشه ممکنه 10 ام باشه - اینجا زمان بندی خاص نداره ولی یه سری استپ ها رو داریم - که میایم براش یه سری تسک ها رو تعریف میکنیم و بعد یه job براش تعریف میکنیم و هر وقت خواست میزنیم اجرا میشه
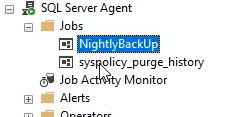
مزینم روی new job
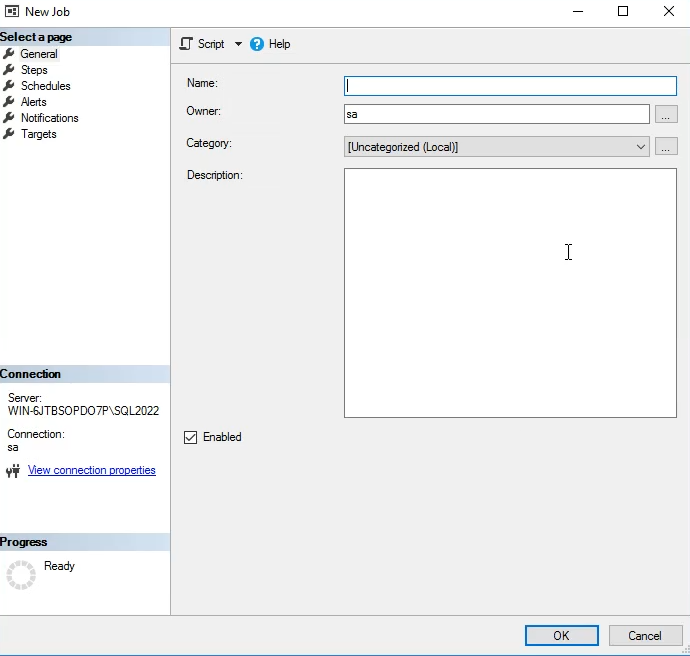
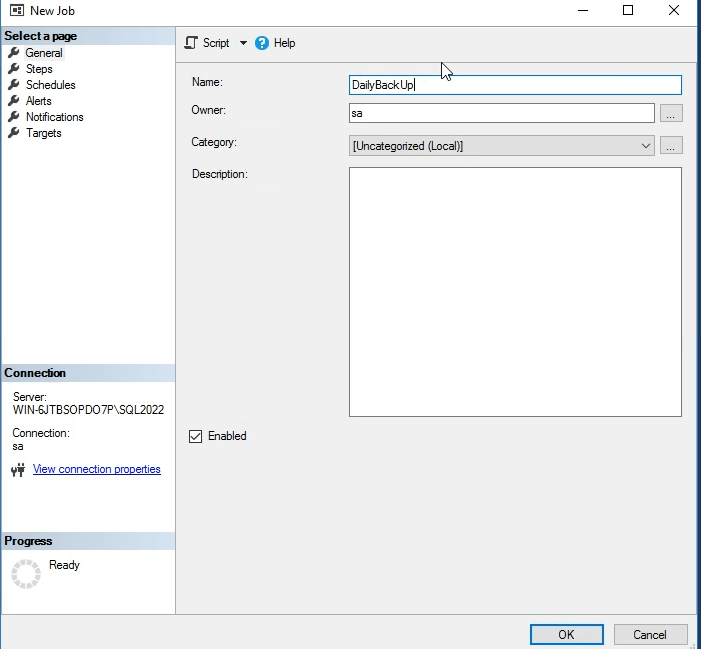
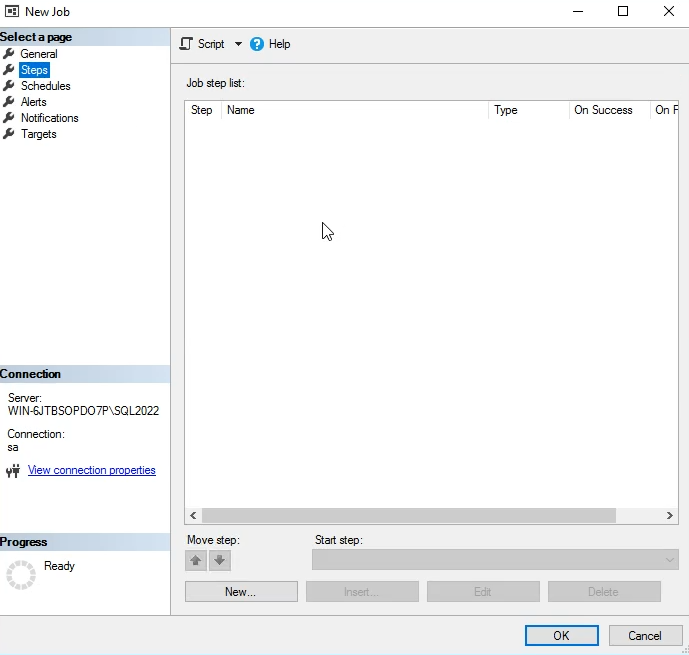
خوب NEW میزنیم :
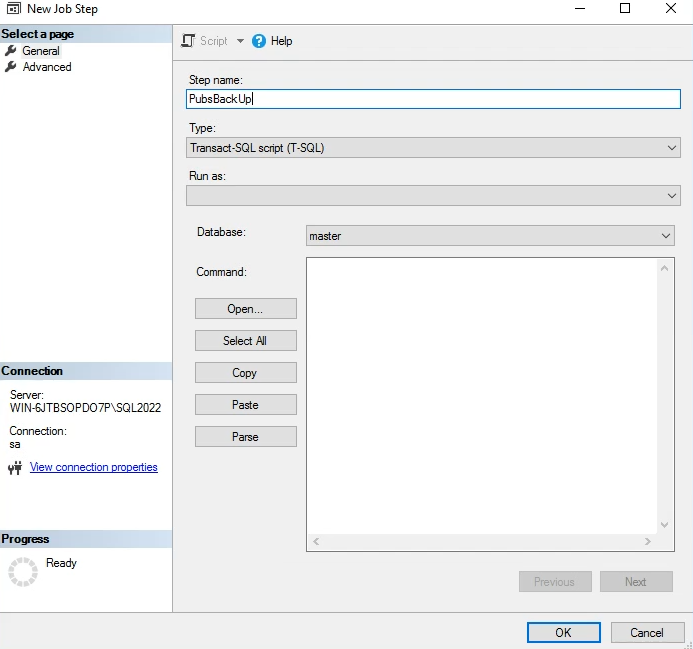
خوب حالا اینجا باید اسکیپت بینویسیم برای بک آپ
برای این کار متونیم این کار رو بکنیم :
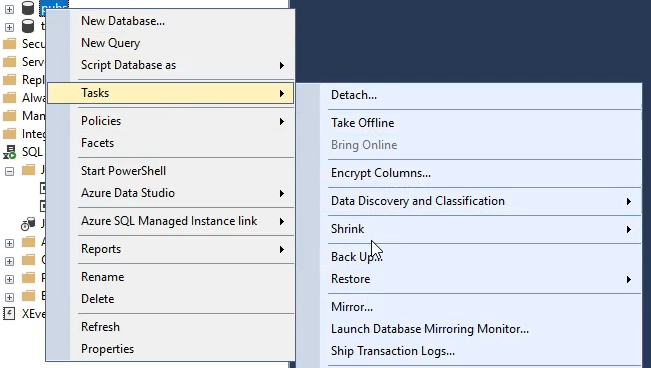
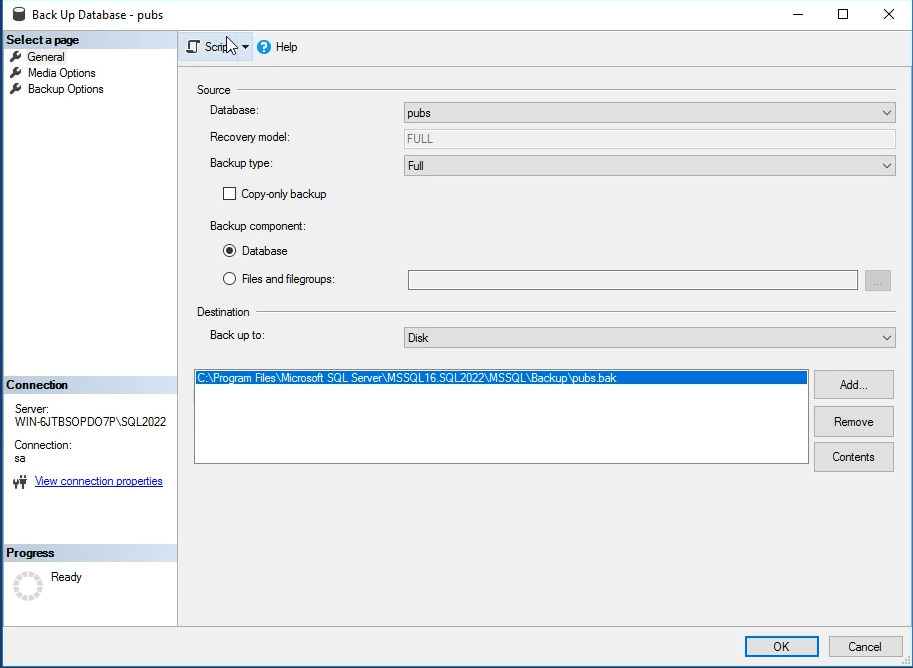
بهمون اسکریپت میده :
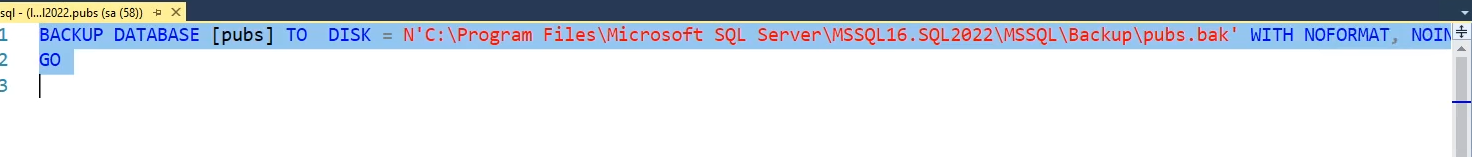
بعد همون اسکریپته رو میبریم توی اونجا میزنیم :پ
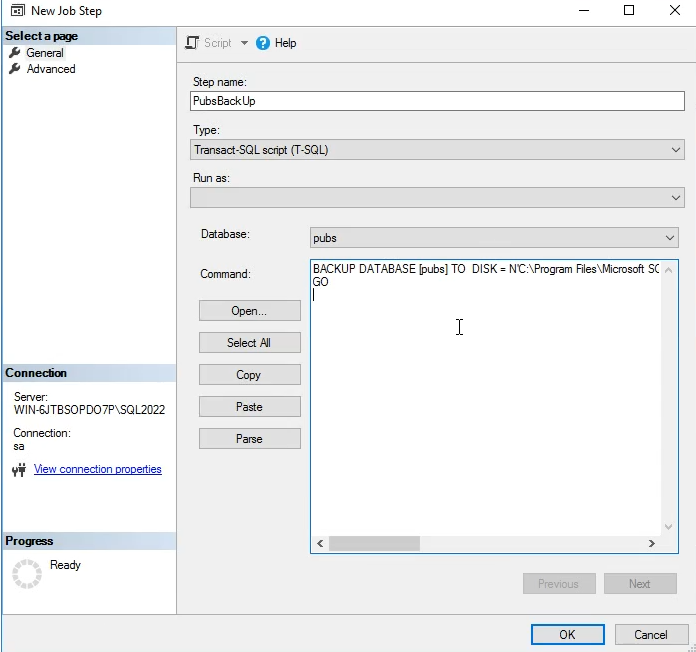
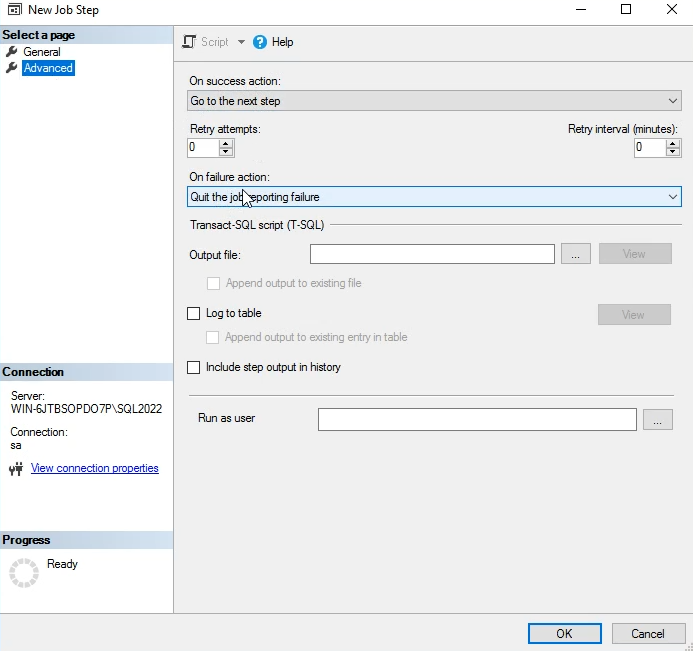
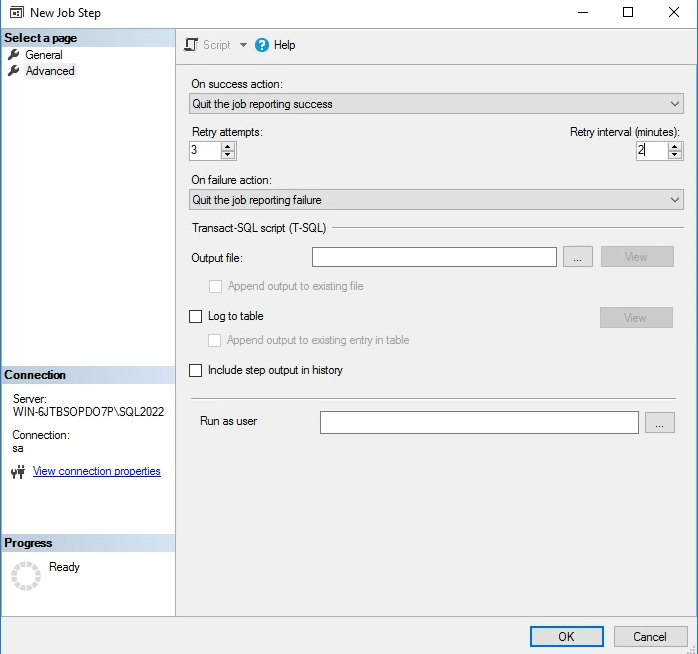
توی خط اول باید تعیین کنیم وقتی که اون job درست انجام شده چه اتفاقی بیوفته
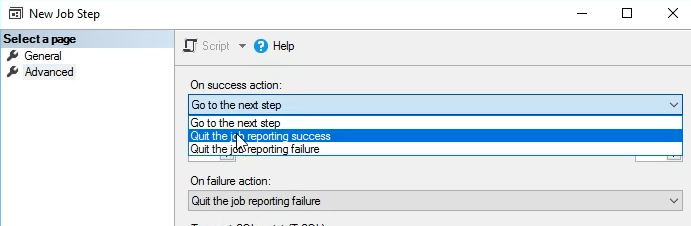
اینجا داریم میگیم اگر یه مرحله بود job عه و درست انجام شد ، قضیه تموم بشه و گزارش موفقیت رو بده
خوب حالا اینجا داریم تعیین میکنیم اگر اون job درست انجام نشد چه اتفاقی بیوفته
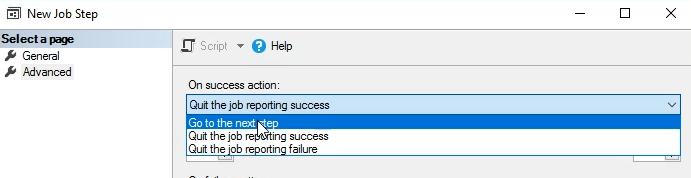
خوب اینجا go to next step رو داریم وقتی که چند تا تسک داریم
حالا یه جا ممکنه اول دیتا بیس pubs رو بک اپ بگیریم و بعد دیتابیس master رو
حالا یه جا ممکنه که تسک ها واقعا مرحله به مرحله بوده - مثلا اول rebuild index انجام بشه و بعد بک اپ گرفته شود حالا اینجا اگر تسک اول fail بشه دیگه نباید تسک بعدی انجام شود توی بالایی ولی اوکیه که بره استپ بعدی
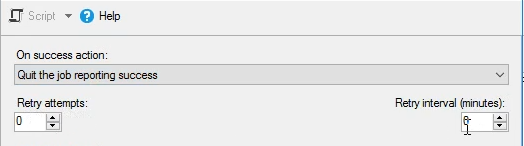
خوب اینجا داریم تعیین میکنیم که چند با و در چه بازه زمانی retry attemp انجام شود مثلا ممکنه که توی اون تایم سرور شلوغ بوده و امکان کار نیست
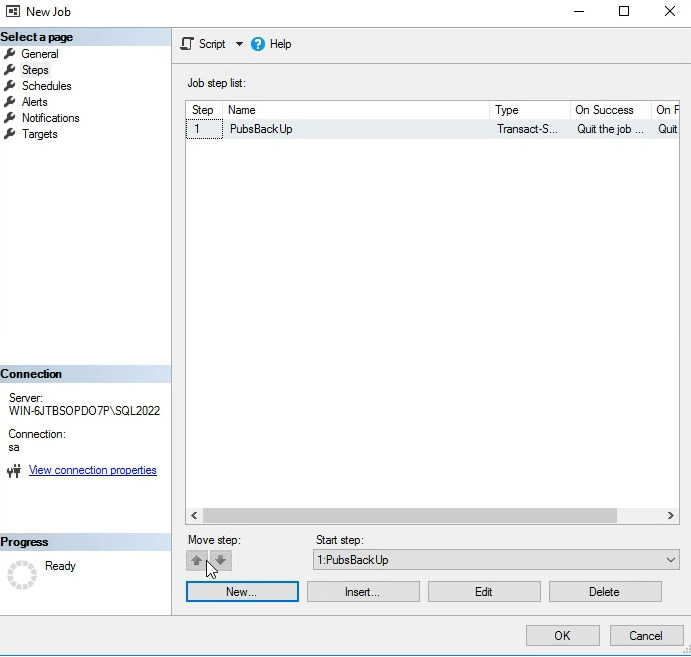
ترتیب رو هم اینطوری تغییرش میدیم
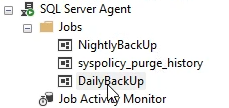 اینجا هنوز زمانبندی بهش ندادیم
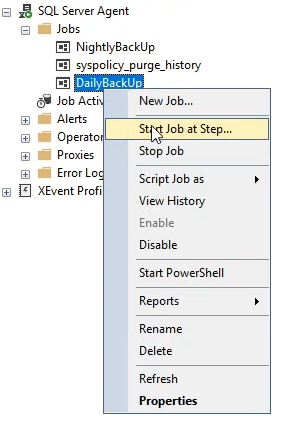
اینجوری دستی انجامش میدیم
این اینطوری که مثلا یوزهایی که اشتباه میزنن اکانتشون تا 5 دقیقه قفل میشه حالا میتوینم 1 دقیقه یه بار براش یه tas ای رو تعریف کنیم که اینکار رو انجام بده مثل backgrund service که توی c# داریم
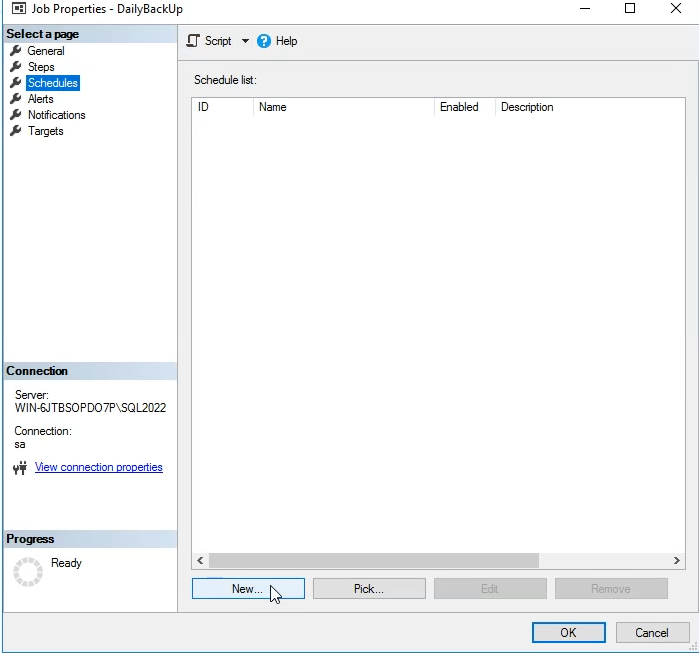
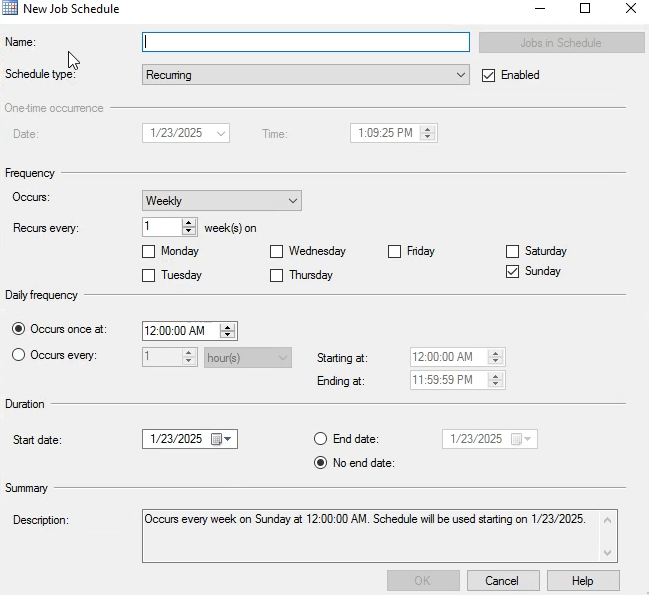
اون recursve اینجا یعنی 1 هفته درمیون
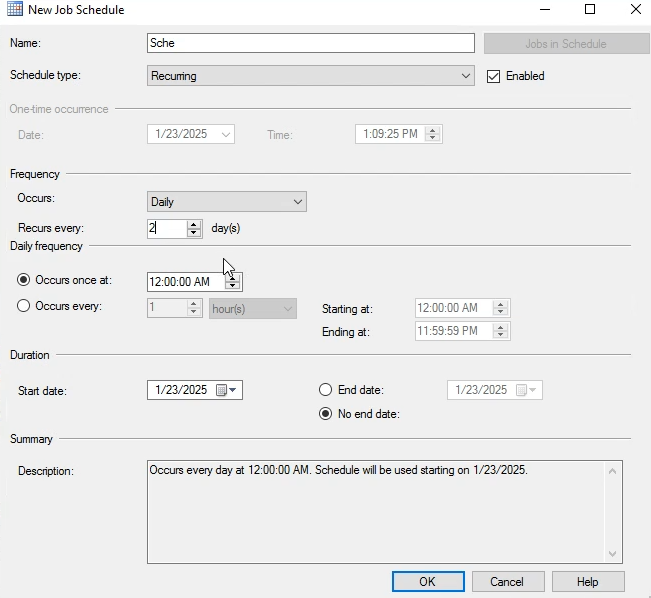
اینجا یعنی هر دو روز یه بار
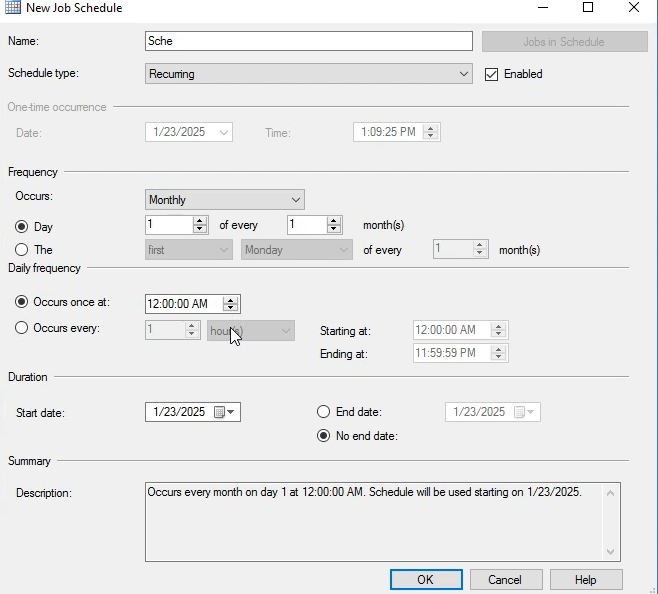
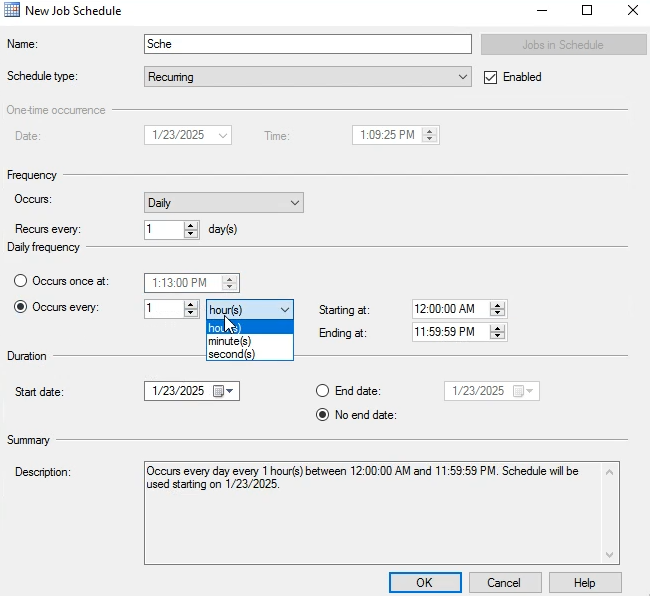
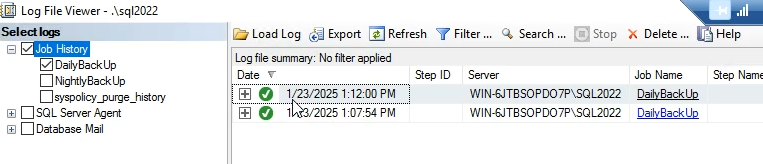
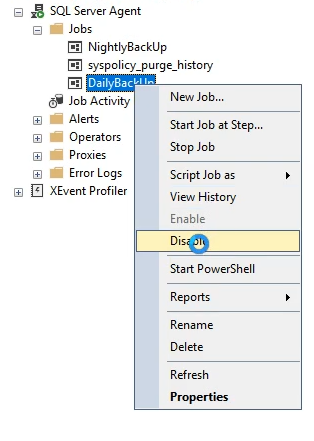
20:00
خوب مثال که اشتباهه
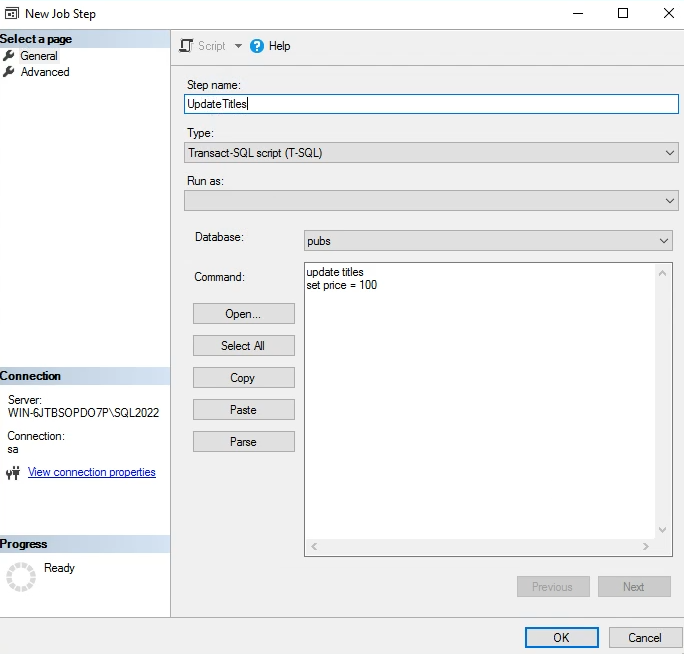
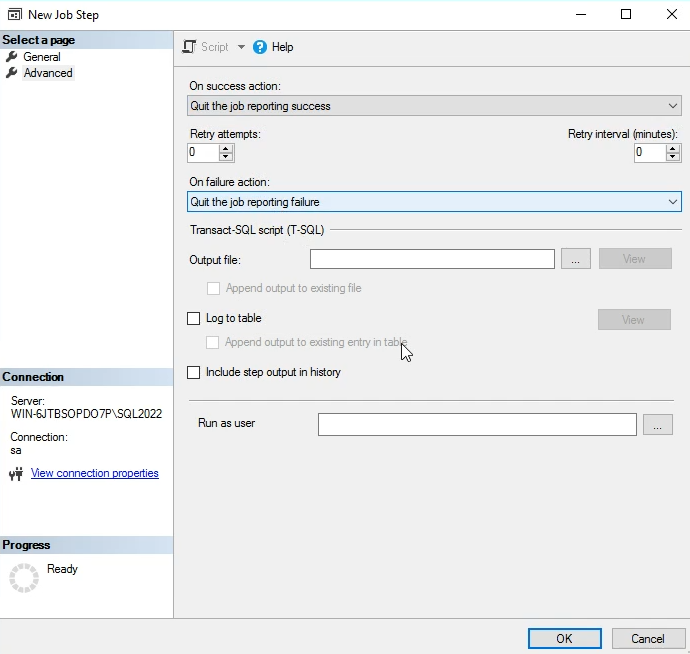
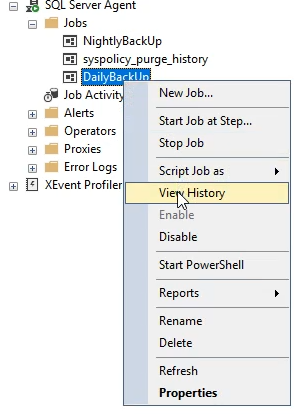
خوب حالا میریم توی hob که مرتبط با back up بود یه تغییری میدیم :
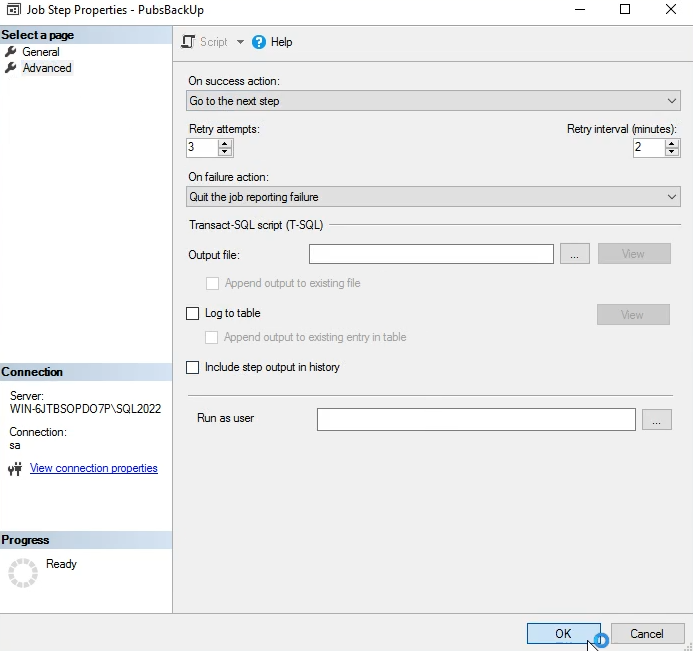
میزنیم go to next step
اتمام جلسه 9