میرسیم به دستور delete خوب create ساختن , alter تغییر دادن , drop از بین بردن
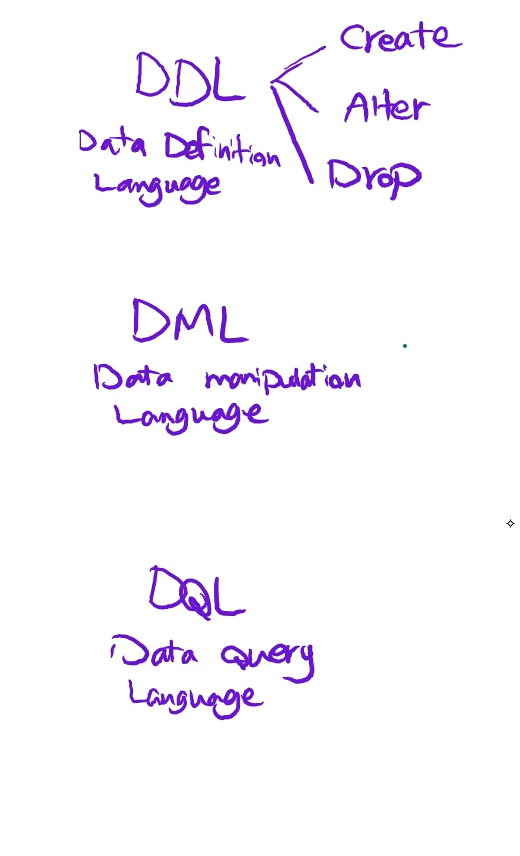
این ها فقط داخل table ها انجام میشود
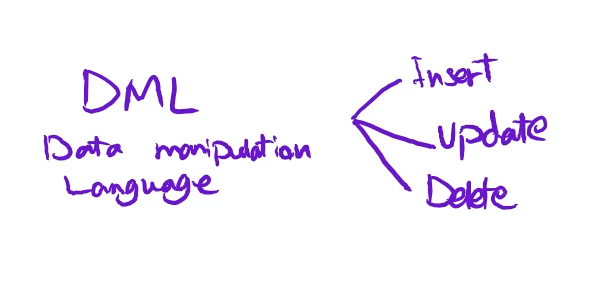
برای ادمین هستش این پایینه
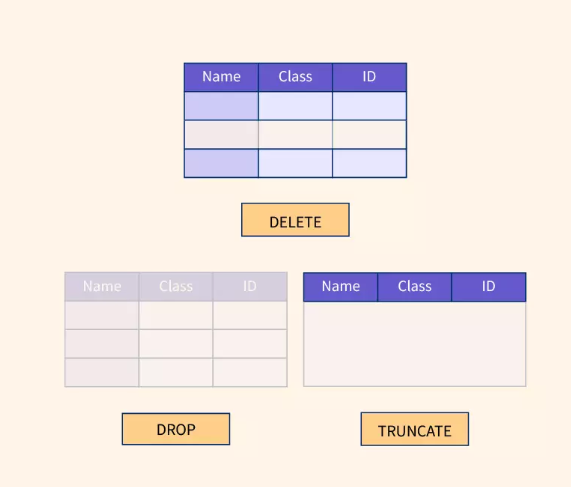
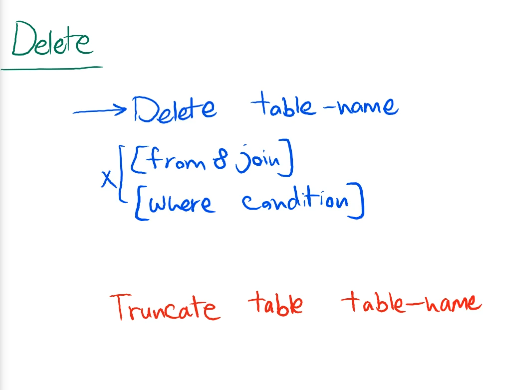
اگر delete رو بدون اون دو تای پایینی اجرا کنیم کل جدول پاک میشه
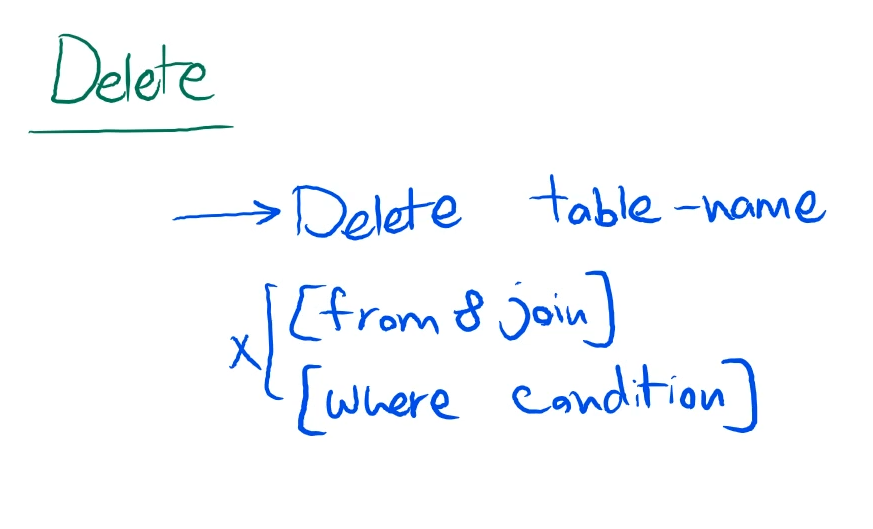
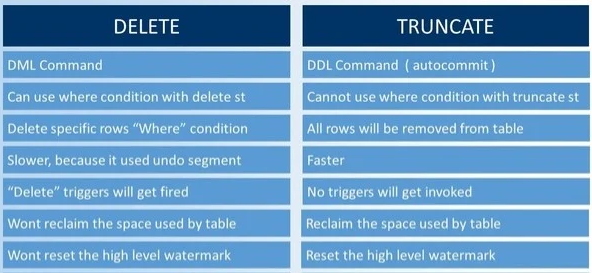
خوب دستور delete کند هستش برای همین میایم از truncate استفاده میکنیم که این میشه شبیه همون delete که where condition نداره
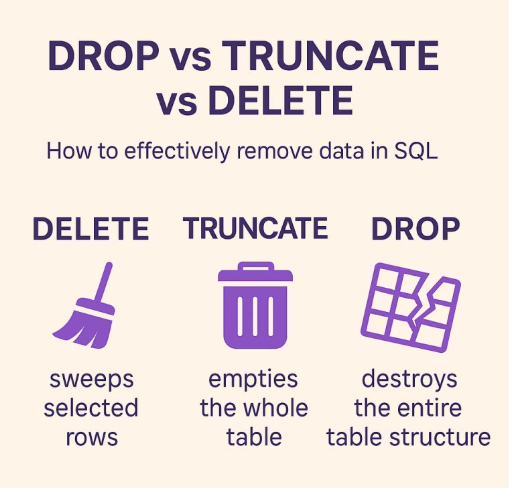
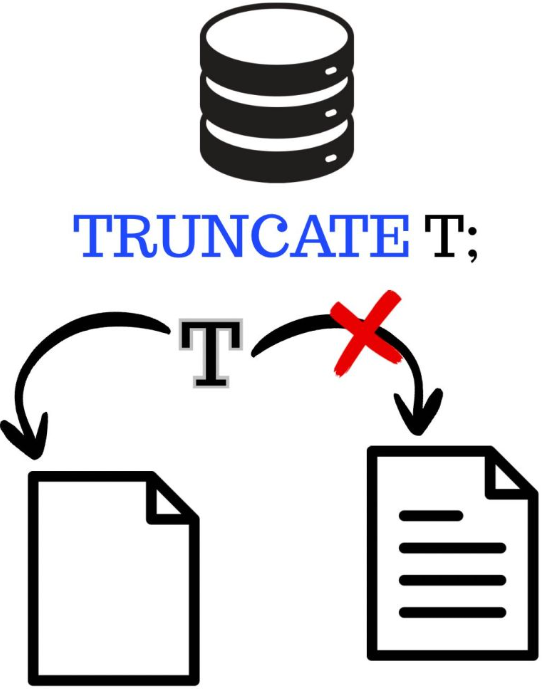
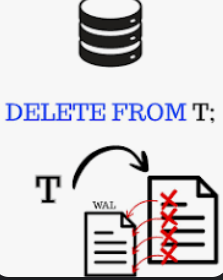
https://intellipaat.com/blog/tutorial/sql-tutorial/sql-truncate-vs-delete/
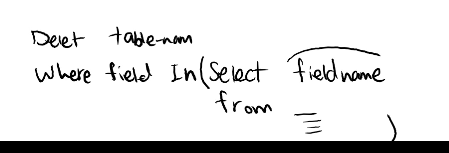
شبیه sub query مدل 3
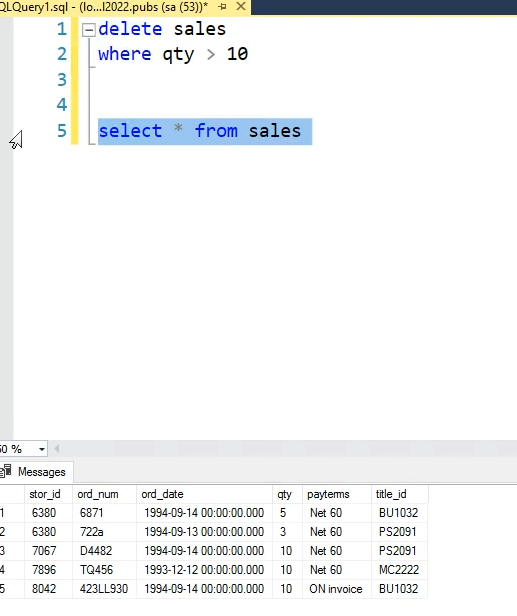
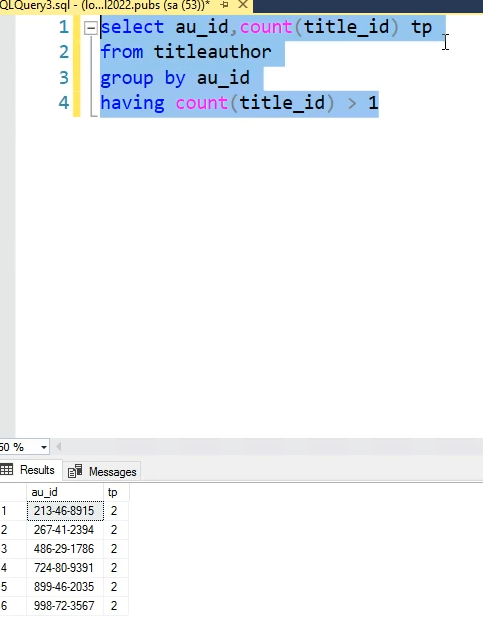
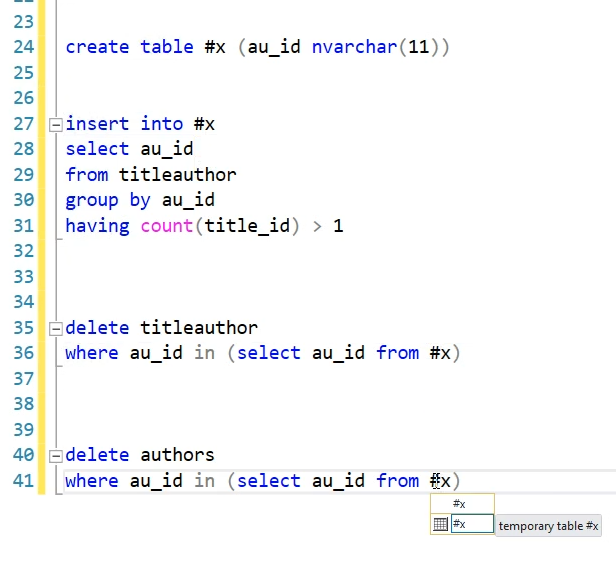
تمام نویسندگانی که بیش از یک کتاب دارند را پیدا کرده و حذف نمایید :
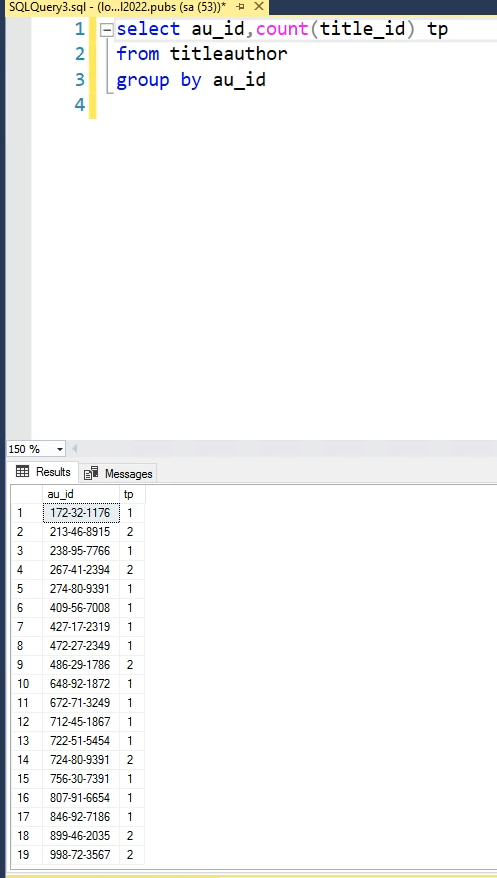
بر اساس au id ها باید group by کنیم و بعد براساس titile id هاش باید count کنیم بf
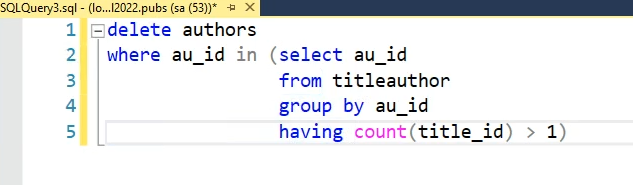
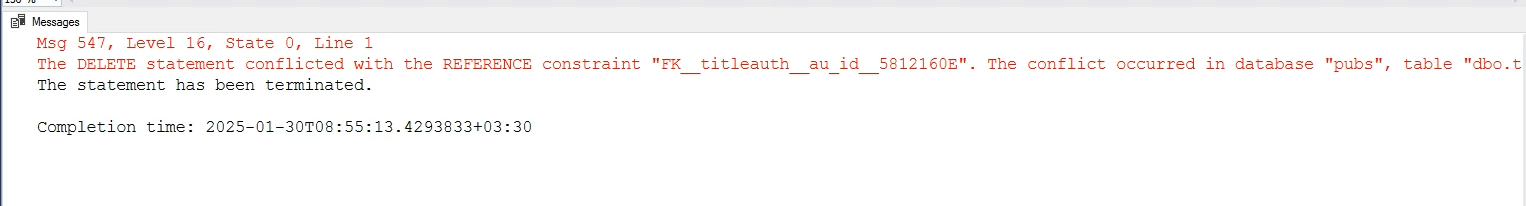
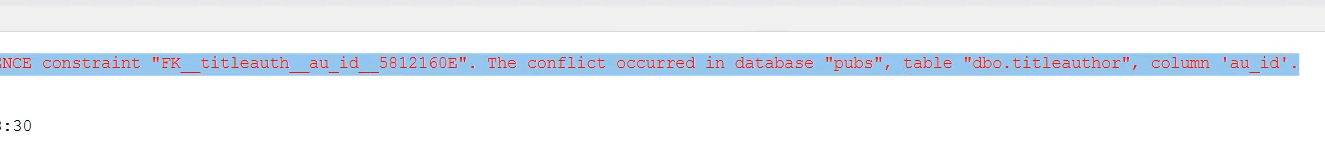 میگه نمیتونه پاکش کنه چون که حق حذف پدری که فرزند داره رو نداریم
اصل refrencial integrity اینو میگه
برای این که بخوایم این کار رو کنیم باید اول فرزند ها رو پاک کنیم و بعد پدر رو حذف کنیم
34:26
اگر نخوایم این کار رو انجام بدیم میایم از cascading استفاده میکنم اتوماتیک فرزند و پدر و حذف میکنه
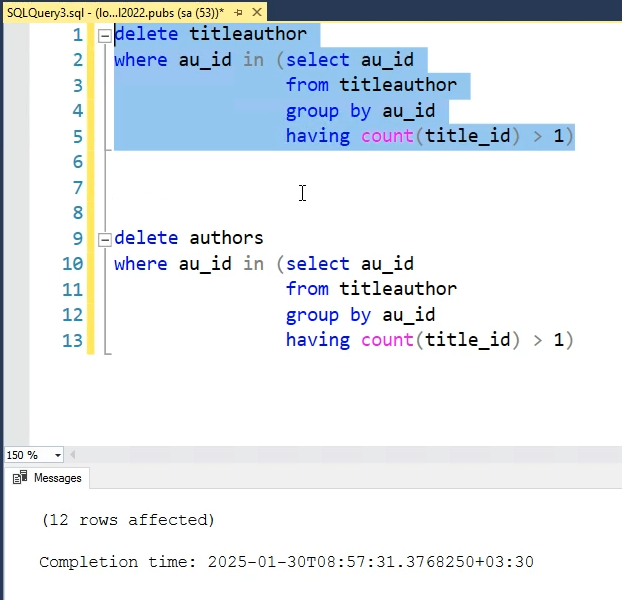
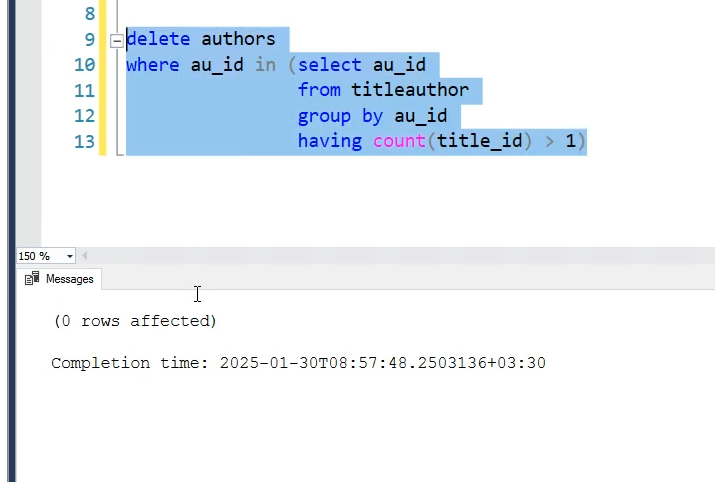 ما اومدیم بر اساس title author اومدیم auid رو شناسایی کرده بودیم ، حالا که title author ها رو پاک کردیم دیگه نمیدونیم کیا بودن
پس مکانیزم درستی رو انجام ندادیم
برای این که درست این کار رو انجام بدیم باید این کار رو انجام بدیم
خوب میایم اون دیتایی که Select زدیم و پیداش کردیم و میگیریم و بعد میریزمیش توی یه جدول دیگه
و بعد به جای این auid ها رو از روی title author بخونه از روی x میخونه
ما قبل از این بخوایم جدول title author رو پاک کنیم باید بیایم اطلاعاتی که میخوایم ازش رو بریزیم توی یه جدول دیگه و بعد اون کار و انجام بدیم
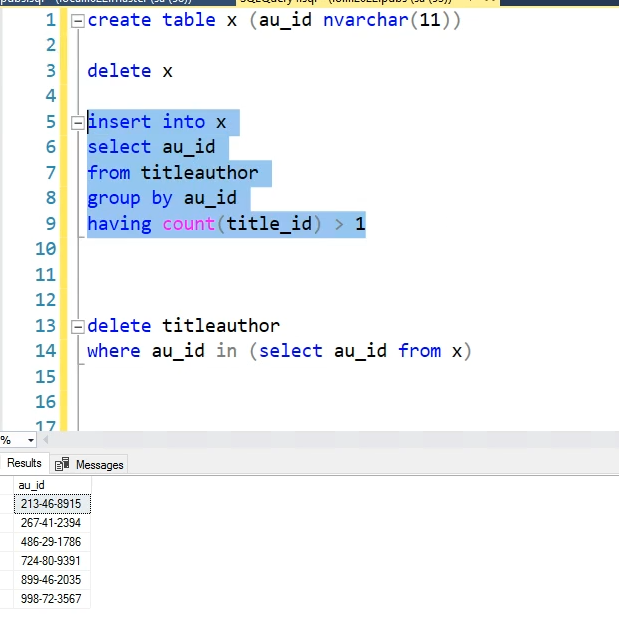
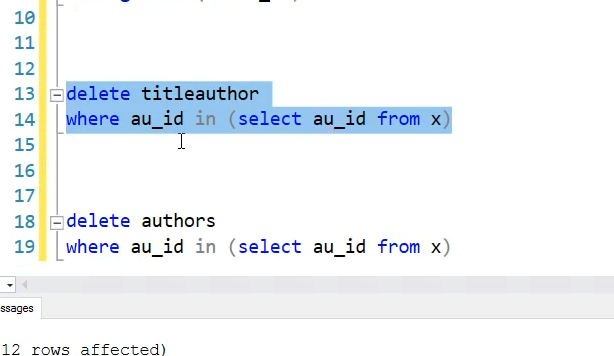
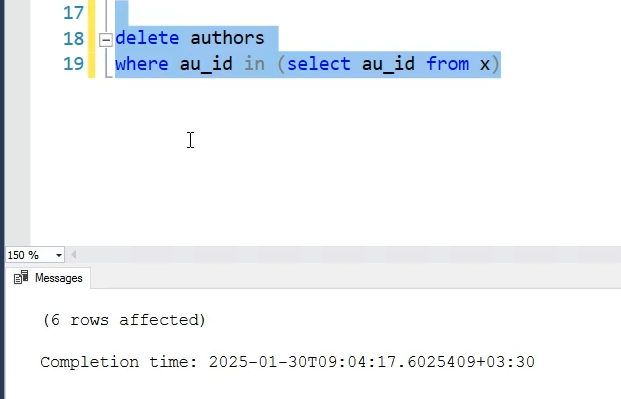
اینطوری وابستگیمون به جدول titile author از بین میره
تا 46:30
اینجا یه مشکلی هست که همه به جدول x دسترسی دارن - فقط خودمون ببینیم جدوله رو
temp table
وقتی که ما instace دیتابیس میسازیم خودش یه سری دیتابیس ها رو داخل خودش داره
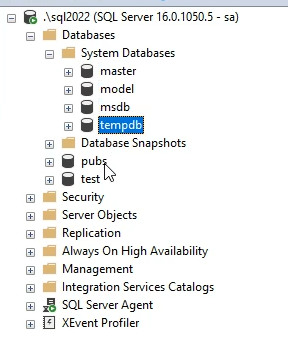
یه دیتابیس نهان هم هست به اسم resourses که اینجا نشونش نمیده
خوب حالا خوده sql server هم یه دیتابیس برای خودش داره که اطلاعتش رو توی اون ذخیره میکنه مثلا همین user password ها و … که بهش میگن master
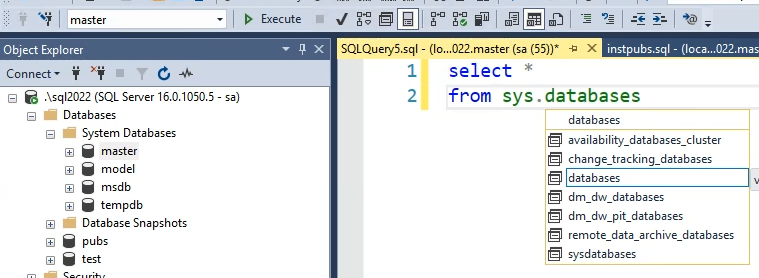
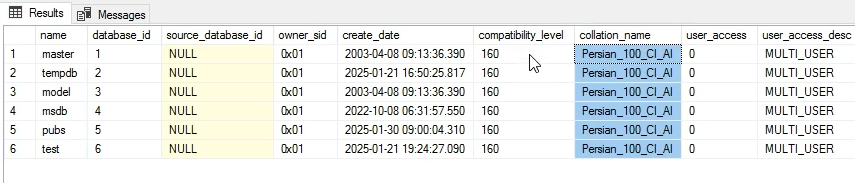
باید از master هم بک اپ بگیر چون اگر خراب بشه کلا اون engine بالا نمیاد
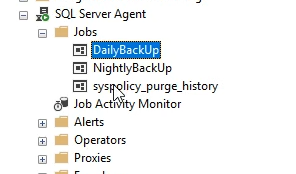
این دیتا ها توی msdb ذخیره میشن یعنی ذخیره سازی دیتاهای agent sql server
دیتابیس model : هر دیتابیسی که در این instance میسازیم مثل اینه که یه کپی از این دیتابیسه
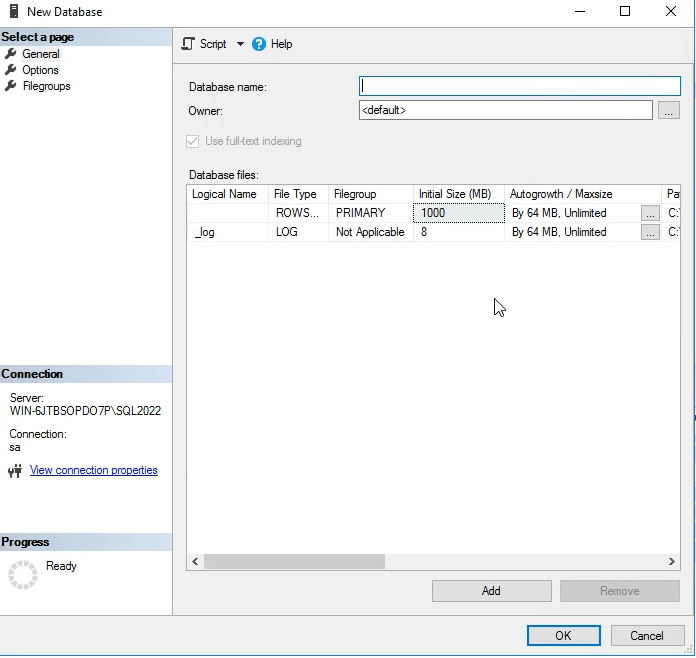
این اطلاعاتی که توی اون فیلدها هستش رو داره از دیتا بیس model میخونه
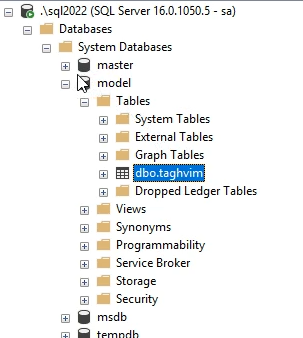
خوب اینجا ما اومدیم یه جدول taghvim رو ساختیم توی model حالا هر دیتابیس دیگه بخوایم توی این instance بسازیم این جدول رو درونش داره چون تمام دیتا بیس های جدید دارن از model ارث بری میکنن
58:42
مثلا برای همه دیتابیس ها میایم استان و شهر رو میزاریم
خوب temp db از وقتی که یه Sql server رو استارت میکنیم تا زمانی که سرویس sql server رو stop نکنیم - به حیات خودش باقی میمونه
با هر خاموش و روشن شودن temp db ساخته و خراب میشه
خوب داخلش temporay tables داریم
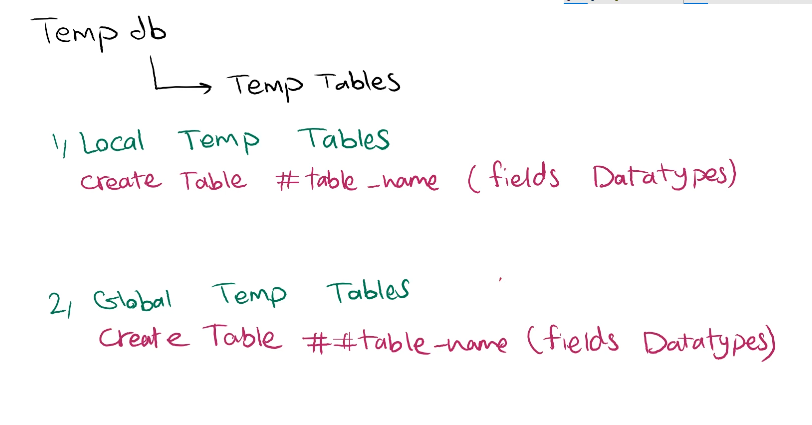
خوب اینا با life time , scope متفاوت هستش
از زمان create تا زمانی که بسته بشه query یا drop کنیم
خوب scope اینجا local رو فقط خودمون میبینیم و global رو همه میبینن
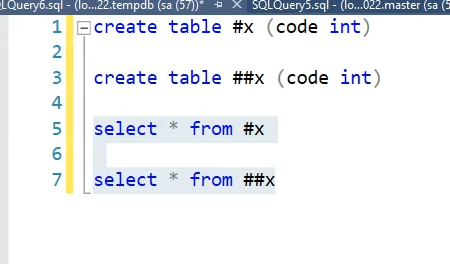
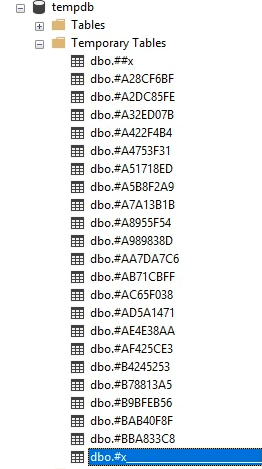
خوب حالا اون صفحه query رو ببندیم و بعد یه صفحه دیگه باز کنیم دیگه به اون loacl دسترسی نداریم ولی به global دسترسی داریم
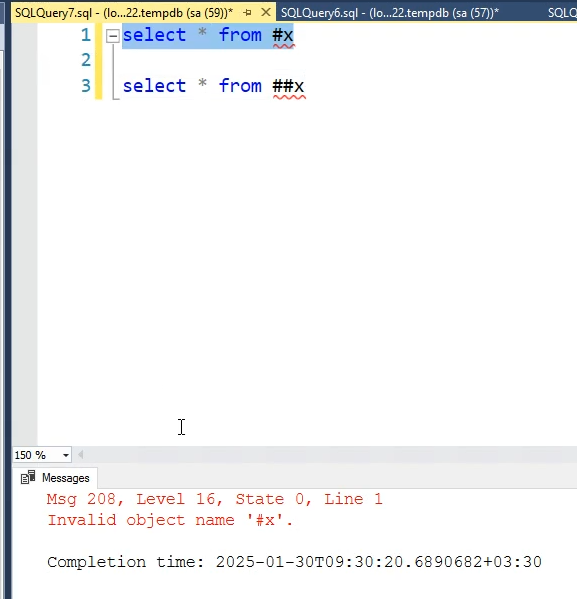
حتی اگر connection رو هم ببنیدم اون global هم پاک میشه
اینطوری دیگه هیچکسی بهش دسترسی نداره غیر از خودمون
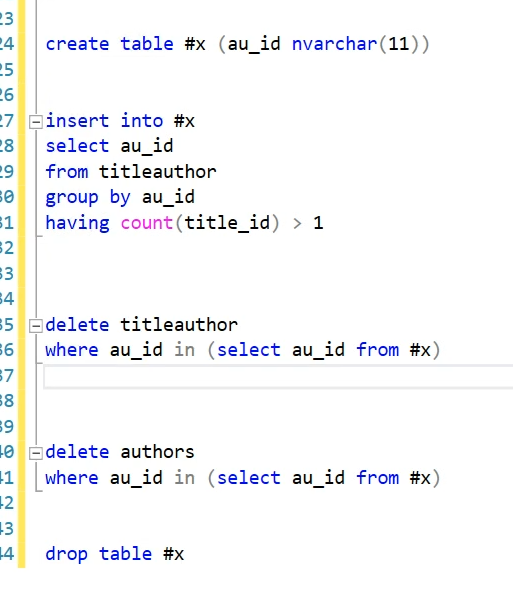
محاسبات رو توی این جدول های موقت انجام بدیم و بعد نتایج رو توی جدول اصلی بریزیم
اگر dreived table ها رو تبدیل کنیم به temp table ها سرعت رو افزایش دادیم
اتمام جلسه 10 قسمت 1
خوب میرسیم به index
مرتب سازی دیتاها برای سرچ برای سرعت بخشیدن به query ها
خوب اگر دیتا sort شده نباشه sql server از squential seach استفاده میکنه
0-100 درهم برهمه
اگر یک میلیون رکورد باشه یک ملیون بار باید بره سوال بپرسه و پیچیدگیش زیاده
ولی اگر مرتب باشه میتونیم از binary search استفاده میکنیم
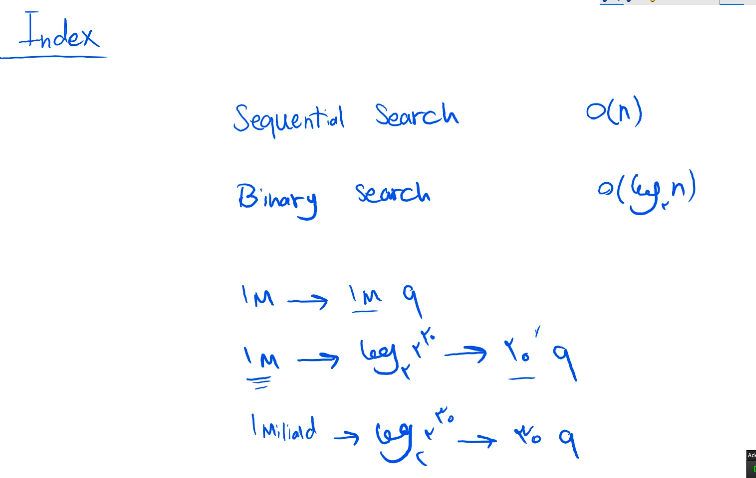
خوب حالا اگر بخوایم ازش استفاده کنیم باید برای Save کردم هم باید از binary استفاه کنیم
حالا اگر بخوایم 32 رو وارد کنیم میاد اول چک میکنه ببینه الان چه اعدادی توی دیتابیس هست مثلا اینجا 15 هستش و 32 ازش بزرگتره و بعد جاش رو پیدا میکنه
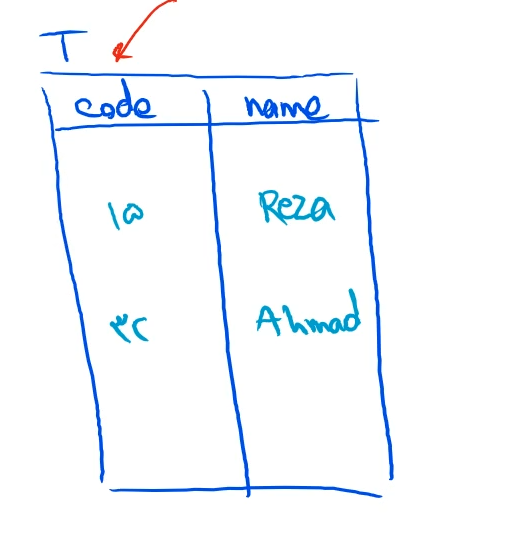
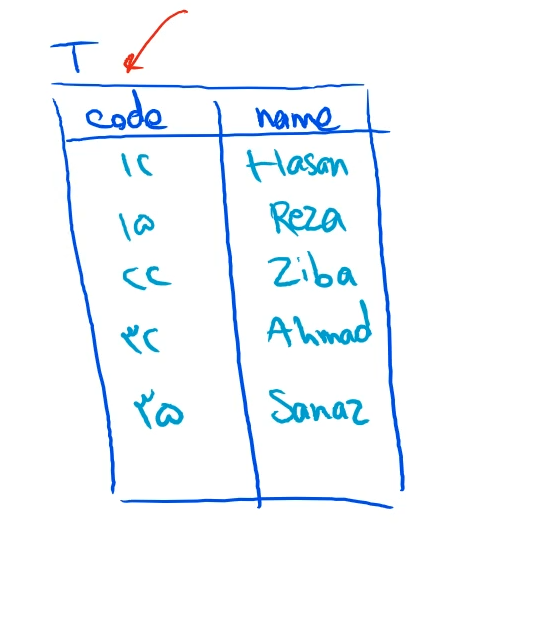
خوب اینجا اگر بخوایم بر اساس name مرتب سازی کنیم باید از sequial استفاده کنیم
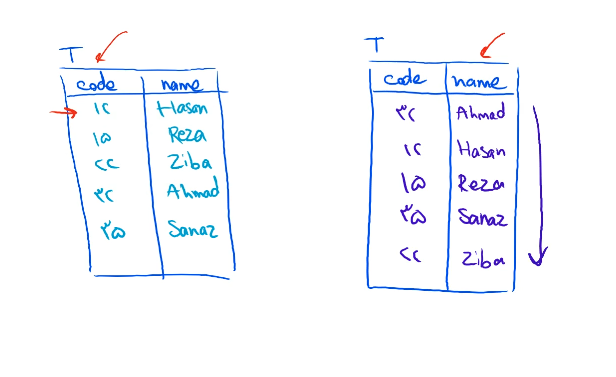
حالا اگر 40 تا فیلد داشت هر روز خواستیم بر یه اساسی مرتبشون کنیم
خوب اینجا index میاد توی کار
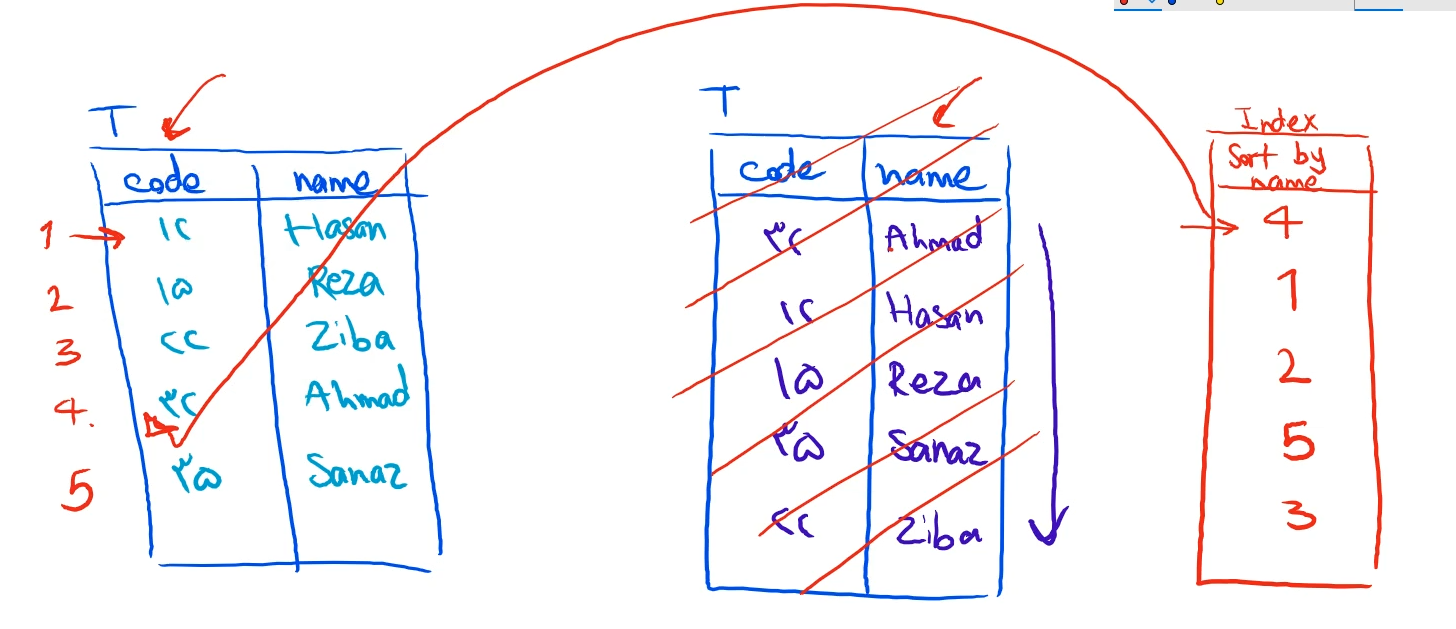
یک بار فقط بر یک اساس sort کنیم , بعدش به هر کدوم اندیس بدیم
خوب حالا مکانیزم insert
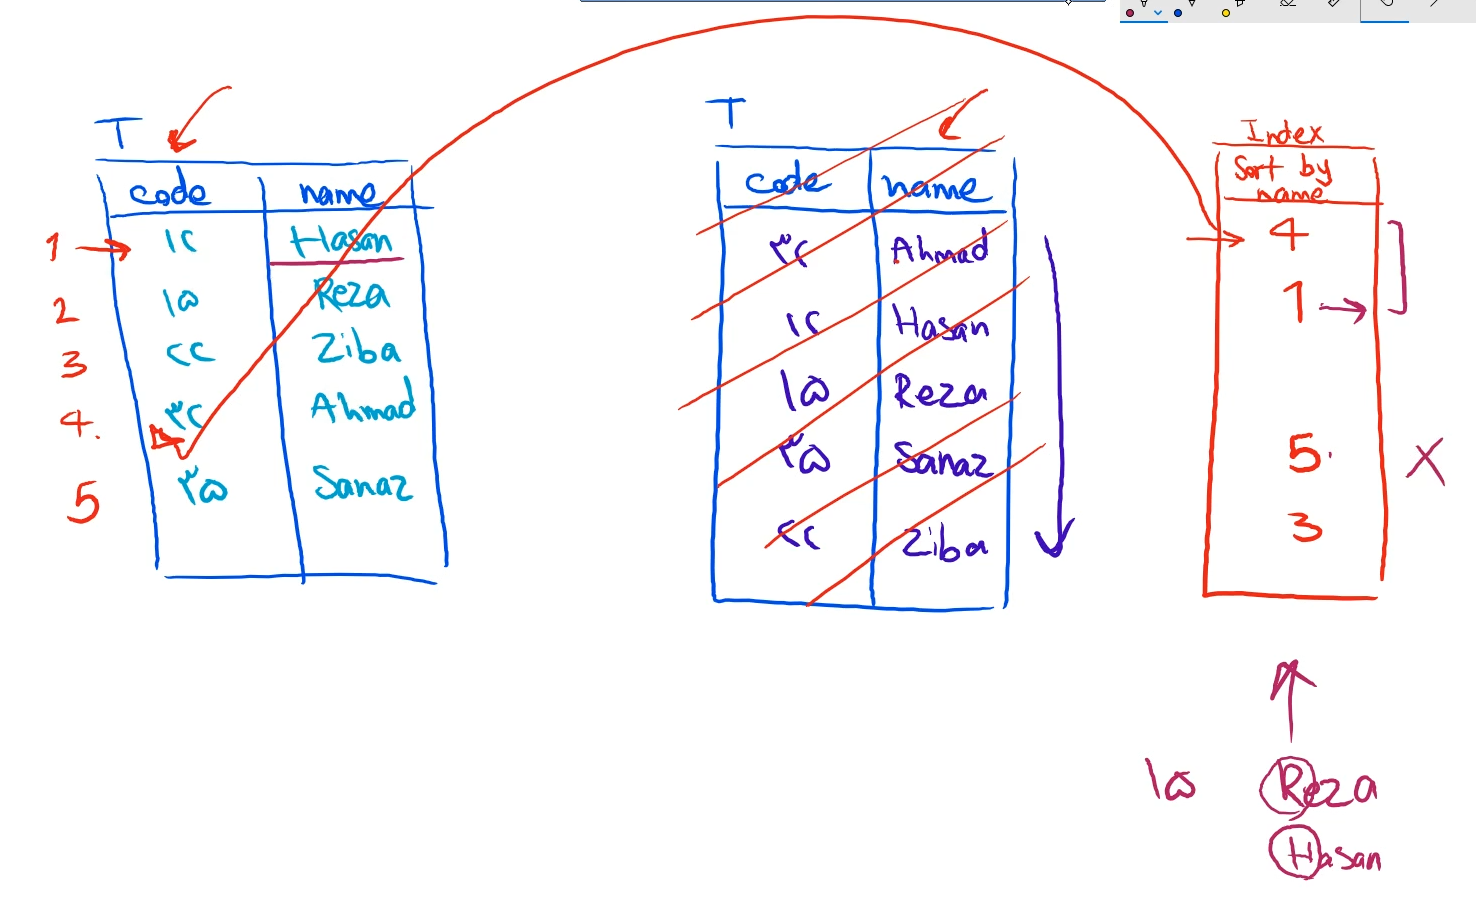
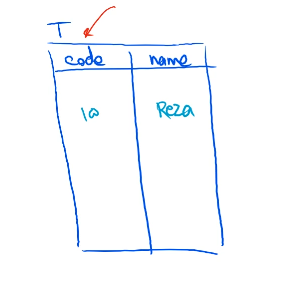
اینطوریه که وقتی که میخواد reza وارد بشه میره ببینه اندیس 1 هستش بعد میره دیتاش رو میاره ، بعدش میاد R رو با H مقایسه میکنه و بعد ادامه ی موضوع
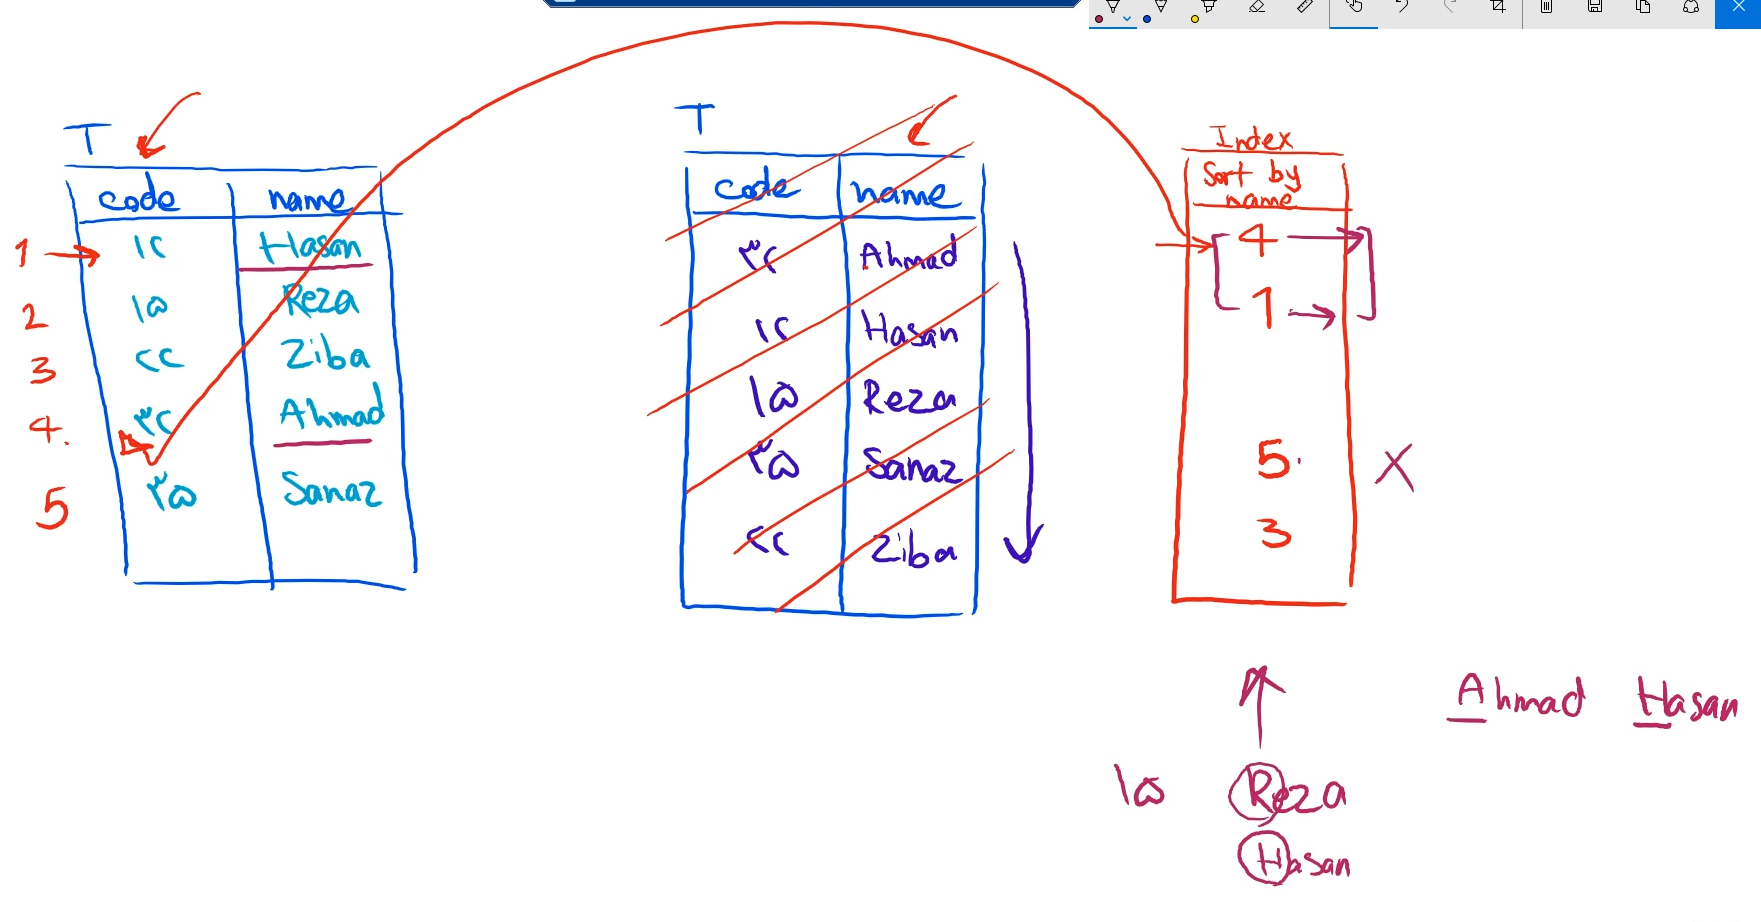
بعدش 4 رو میبینه و بعد میره دیتای اون رو میاره و مقایسه میکنه و انقدر این کار رو میکنه که جای درستش رو پیدا کنه
توی روش قبلی ما کل دیتا ها رو بر اساس اون فیلدی که میخوایم میایم sort میکردیم ولی اینجا فقط اندیس و index اش رو sort میکنیم
هر یک index به اندازه 16 بایت ازمون فضا میگیره big int هستش
این اطلاعات index توی mdf ذخیره میشه
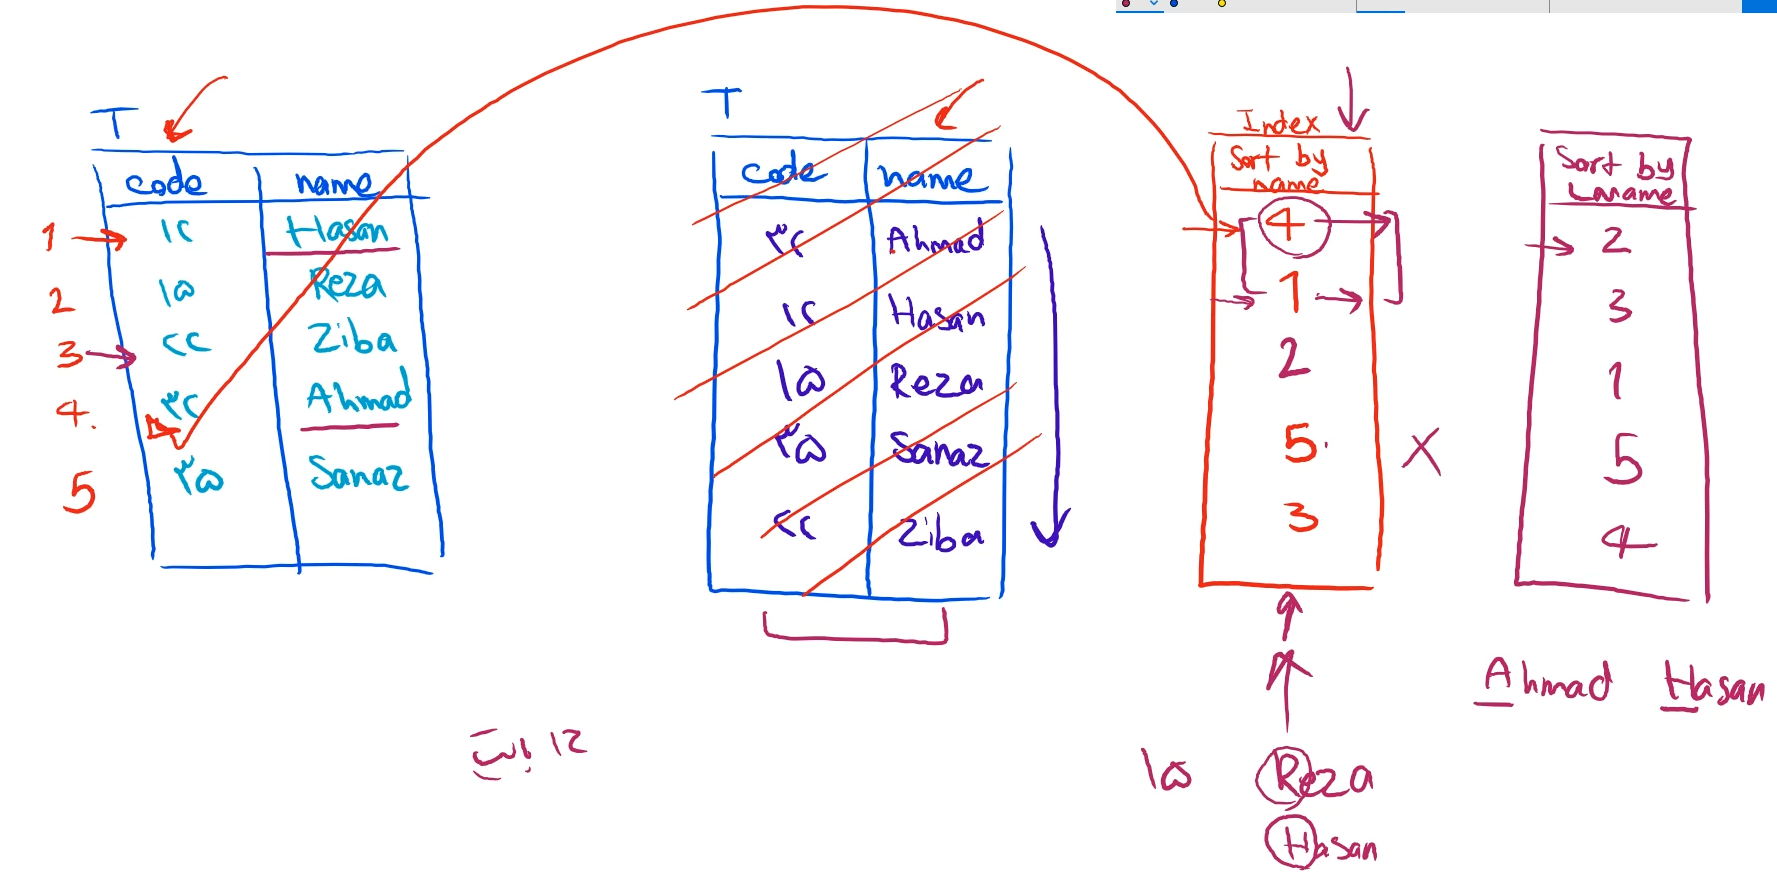
خواندن رو سرعت select رو میبره بالا و update , delete , insert رو سرعتش رو میاره پایین
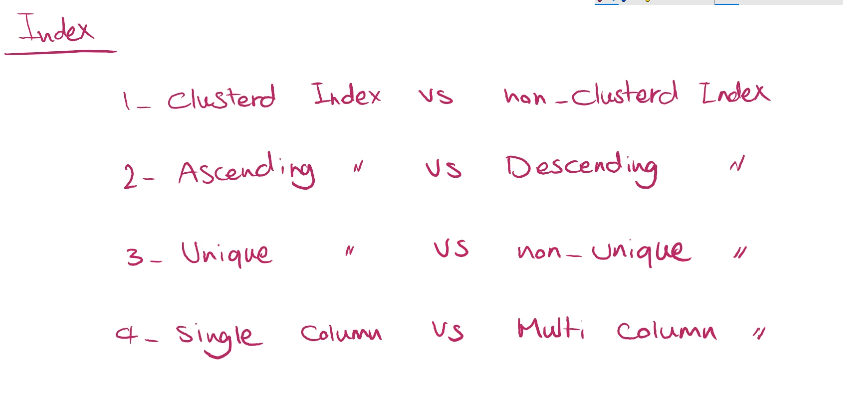
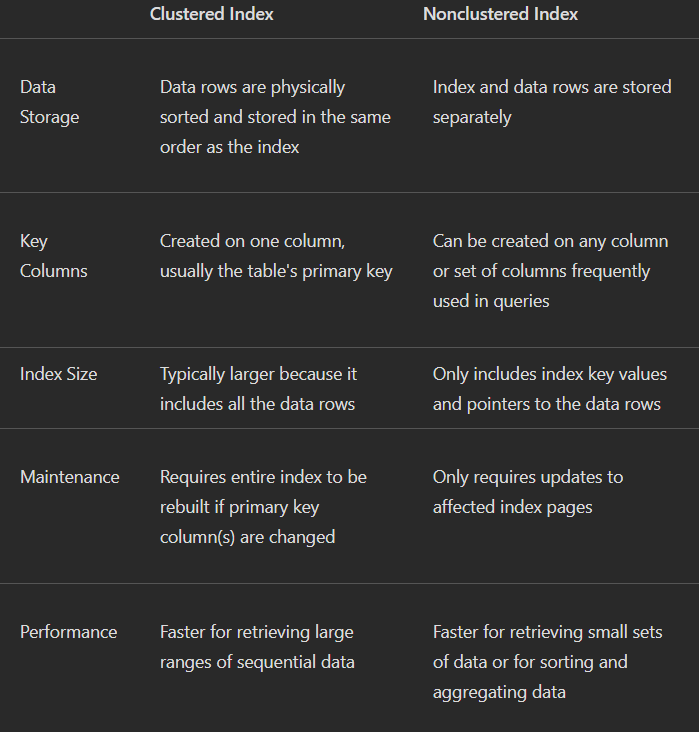
خوب clusterd کل جدول براساس یه فیلد بهش index میدیم بعدا به ازای هر cloum اطلاعاتی دیگه که خواستیم sort بکنیم از اون شماره index استفاده میکنیم که به اون ها میگن non clusterd
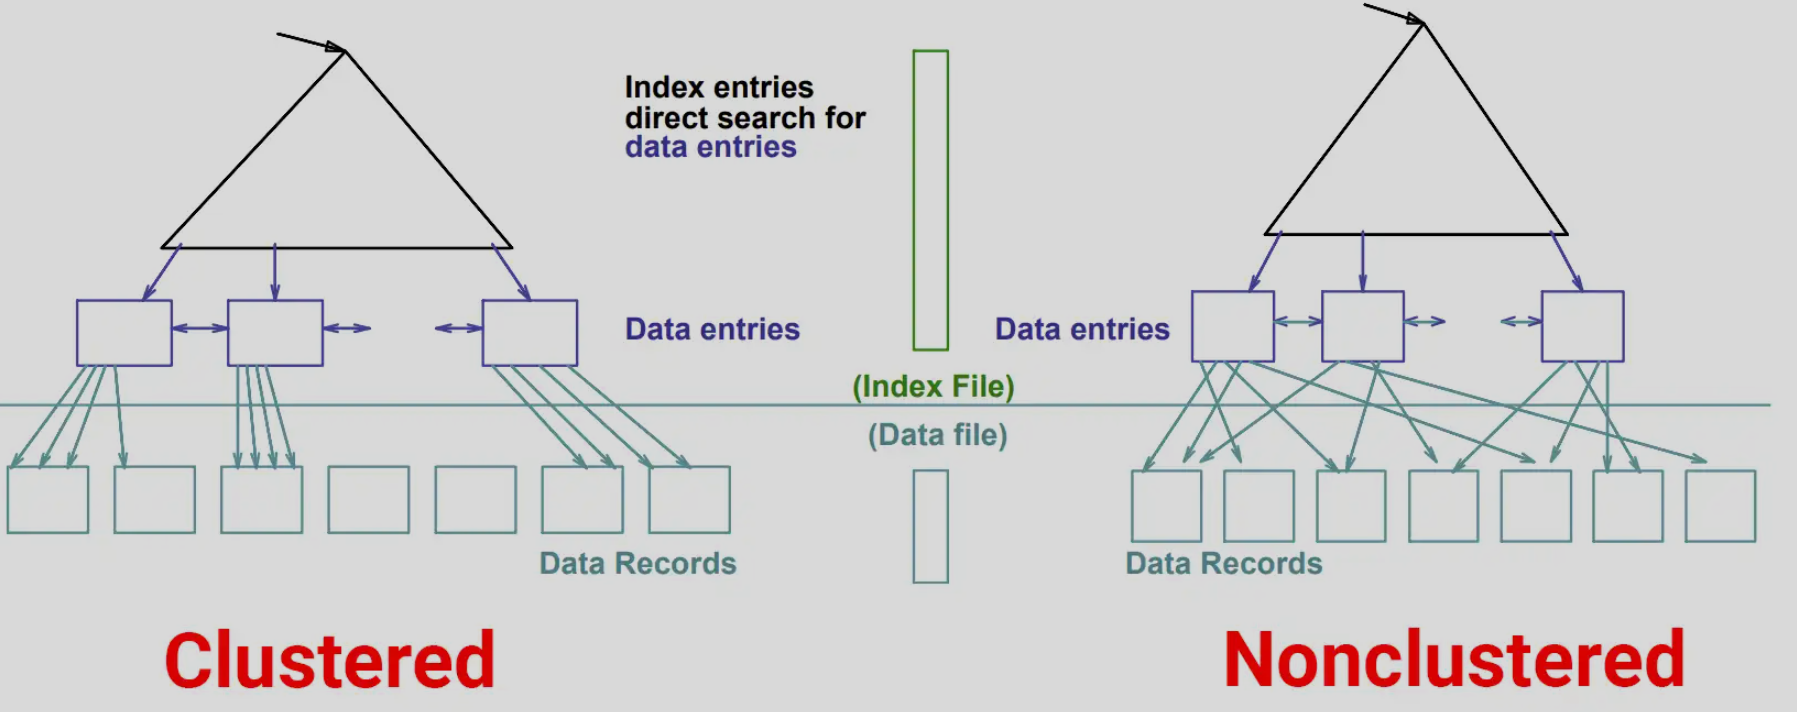
https://josipmisko.com/posts/clustered-vs-non-clustered-index
https://www.pragimtech.com/blog/sql-optimization/how-do-sql-indexes-work/
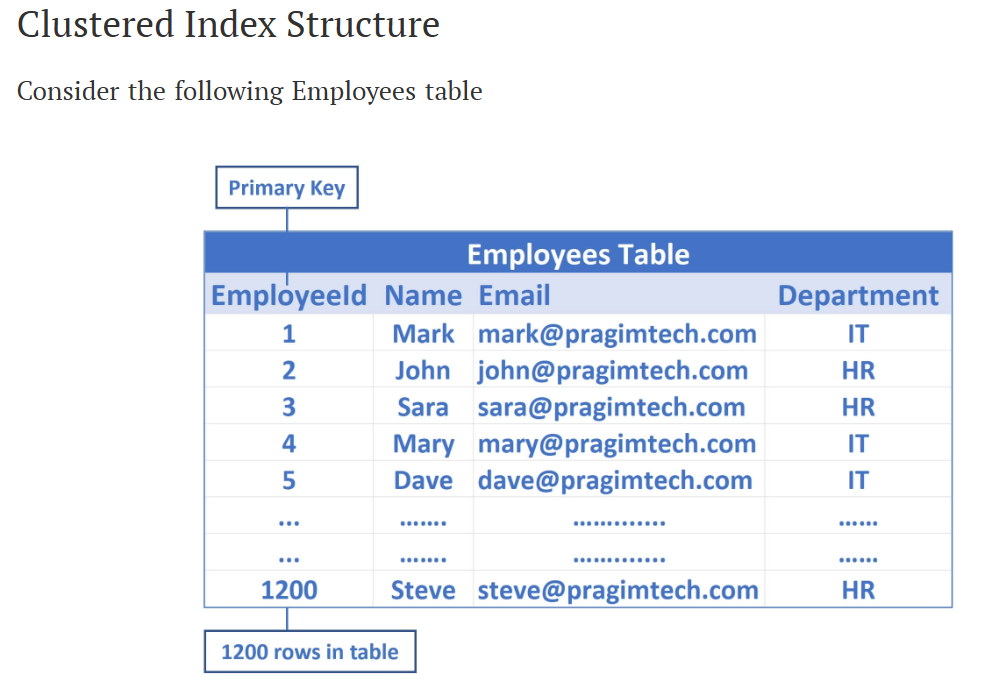
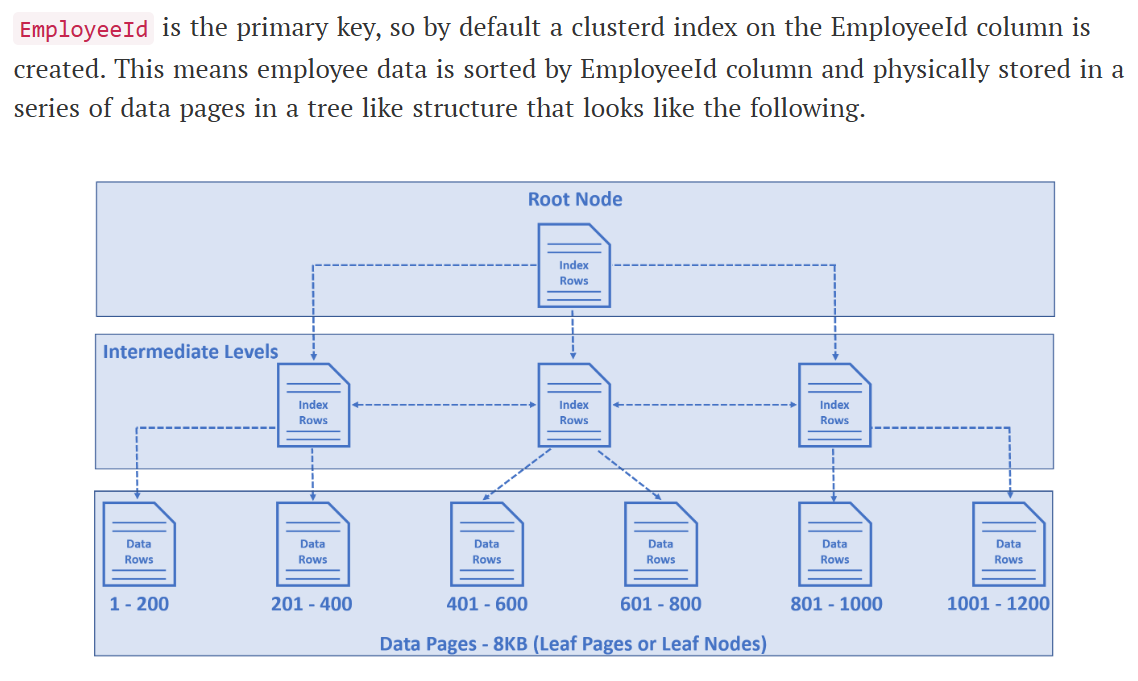
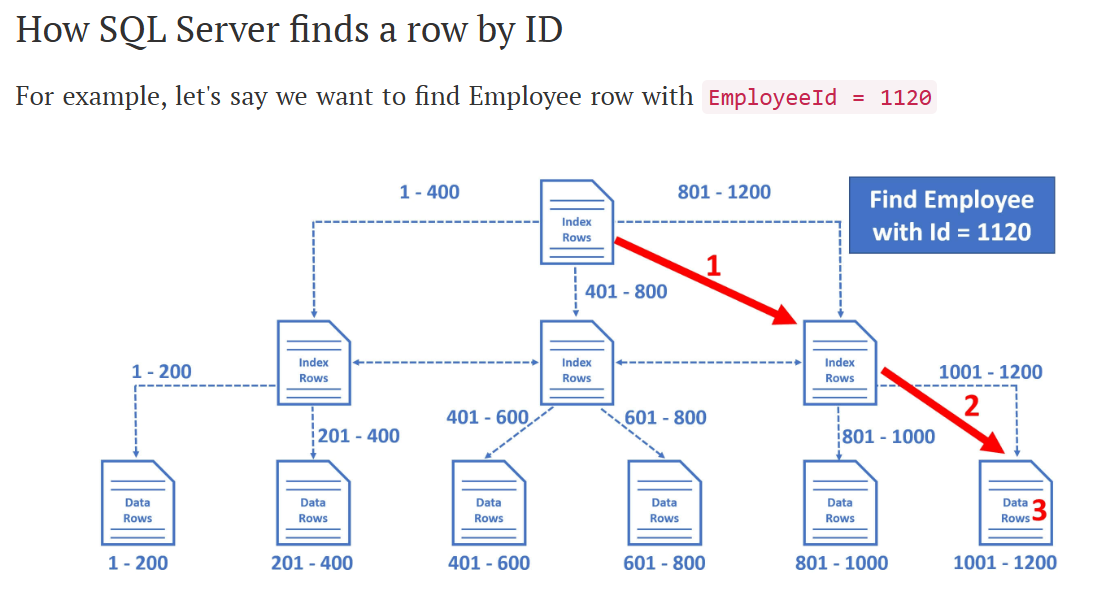
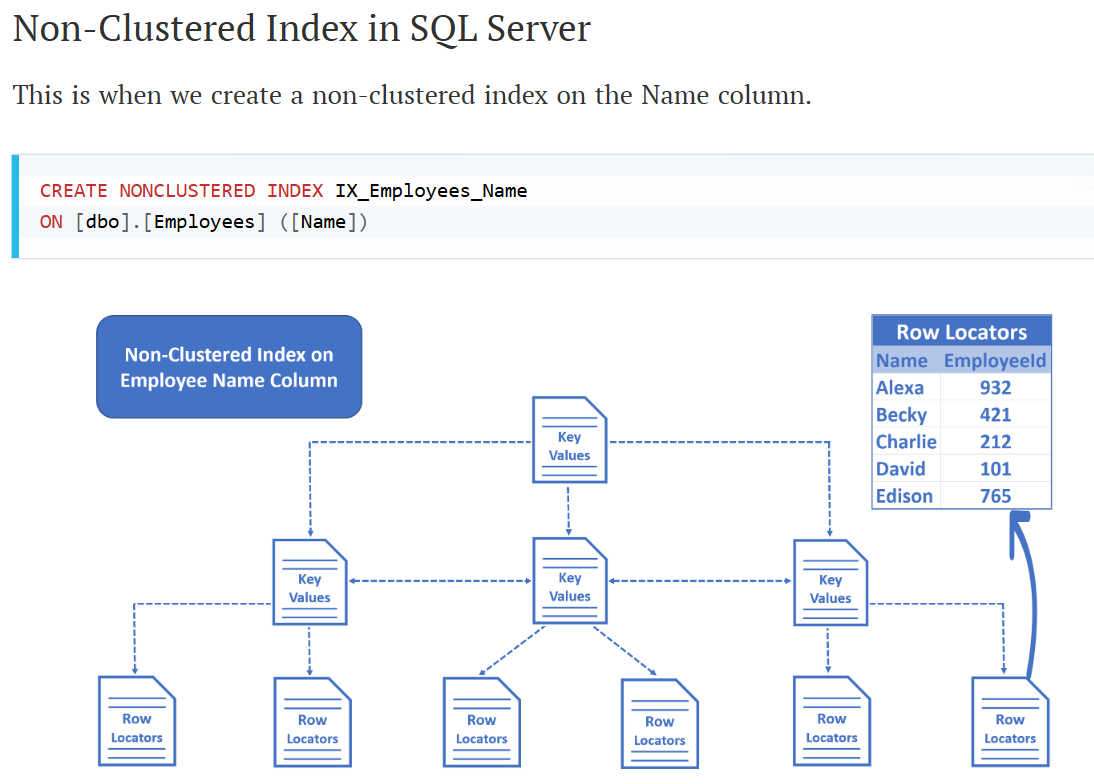
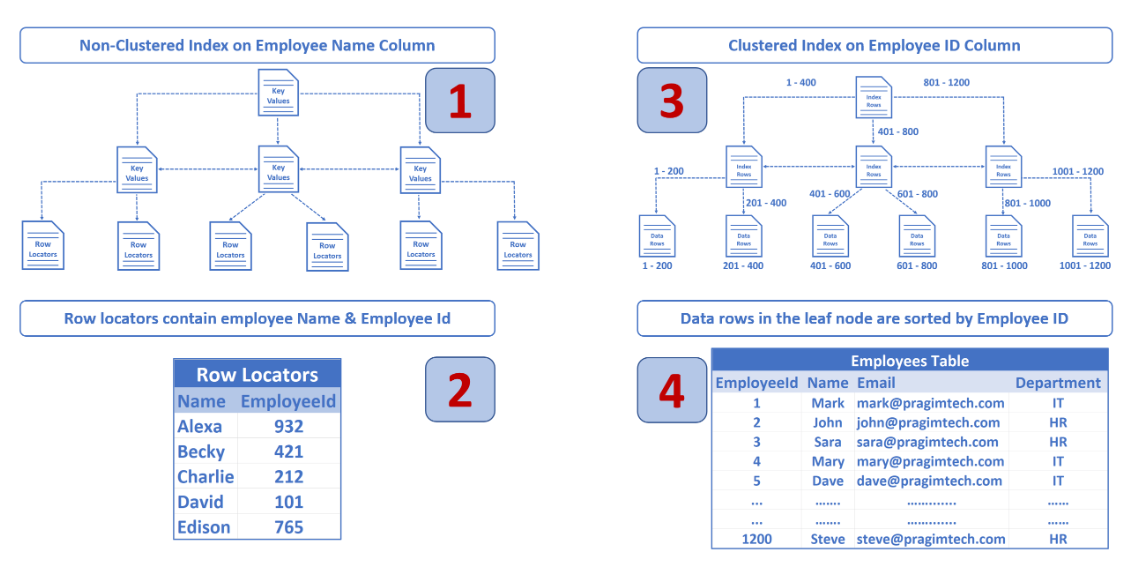
تا 26:54
یک بار کل جدول رو بر اساس یک فیلد اطلاعاتی sort کنیم و بهش شماره index بدیم بعدا برای sort کردن به ازای هر column اطلاعاتی دیگه میایم از اون index ها استفاده میکنیم
الان به ازای code ایندکس بهش دادیم و sort اش کردیم و بهش میگن clusterd ولی اگر بخوایم بر اساس cloum های دیگه اطلاعاتی sort اش کنیم میایم از این index ها استفاده میکنیم که در این حالت میشه non clusterd
یعنی توی هر جدولی ما هم clusterd داریم و هم non clusterd
بعدیش که صعودی و نزولی باشه - ایا در سرعت search تاثیر دارد در binary search ؟ فرقی نمیکند
ولی چرا داریم ؟ خوب ما order by داشتیم قبلا - خوب اون میومد دیتا ها رو به صورت مرتب شده هستش — حالا اگر این order by صعودی باشه و مرتب شدن index به صورت صعودی باشه - سرعت میره بالا
خوب ایندکس های یکتا در مقابل ایندکس های غیر یکتا - PK داریم که میومد دیتا رو uniqe میکرد اما همیشه فقط یک cloumn یا مجموعه از cloumn ها یکتا میشد
خوب uniqe index - از ورود مقادیر تکراری جلوگیری میکنه و مقادیری اون cloumn اطلاعاتی رو sort شده نگه میداره
ما در هر index گذاری از این 8 تا ما 4 تاش رو داریم یعنی یکی به ازای هر خط
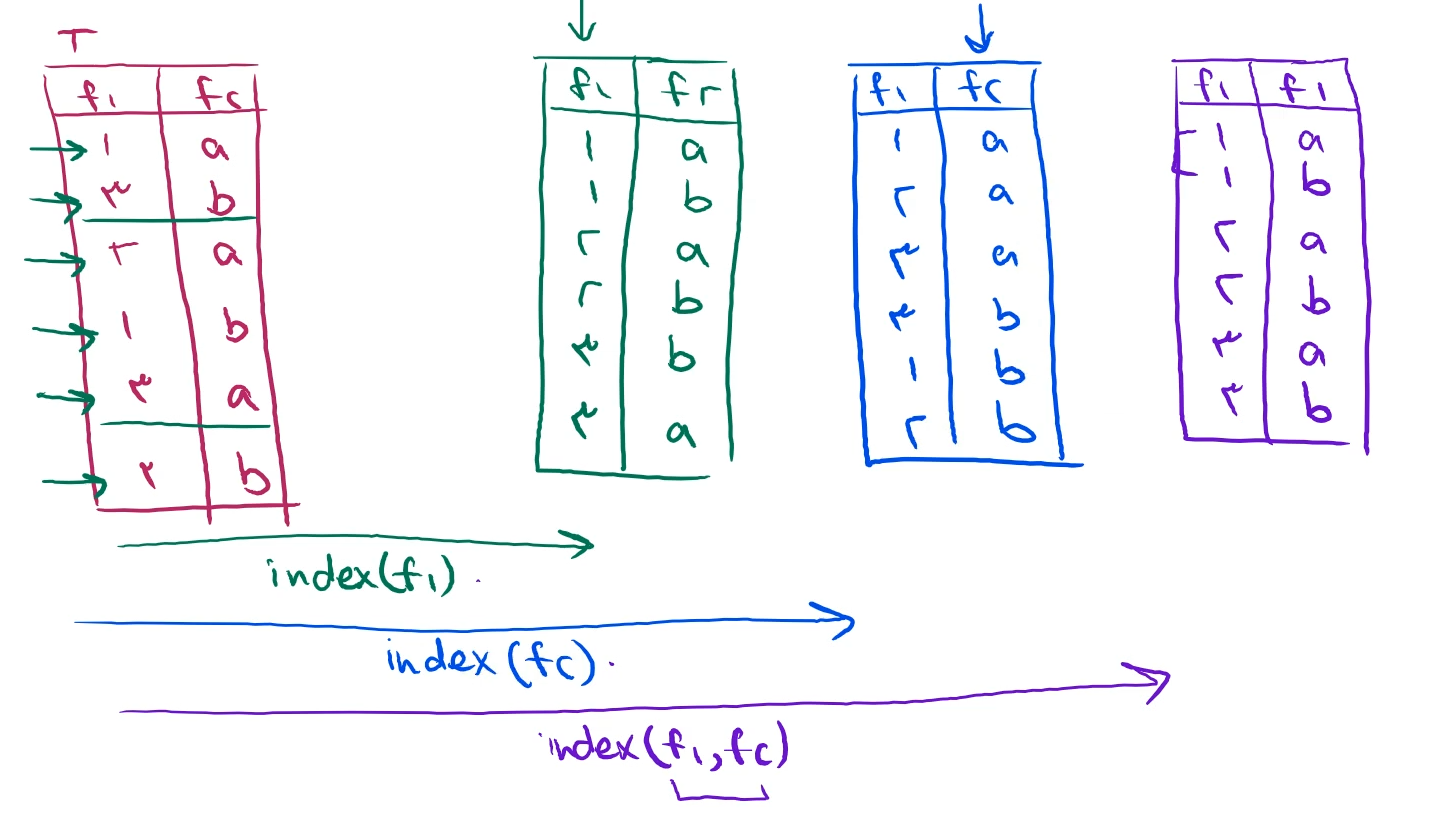
خوب اون آخریه اینطوریه که میاد اول عدد ها رو sort میکنه و بعد میاد به ازای اون ها حروف رو sort میکنه
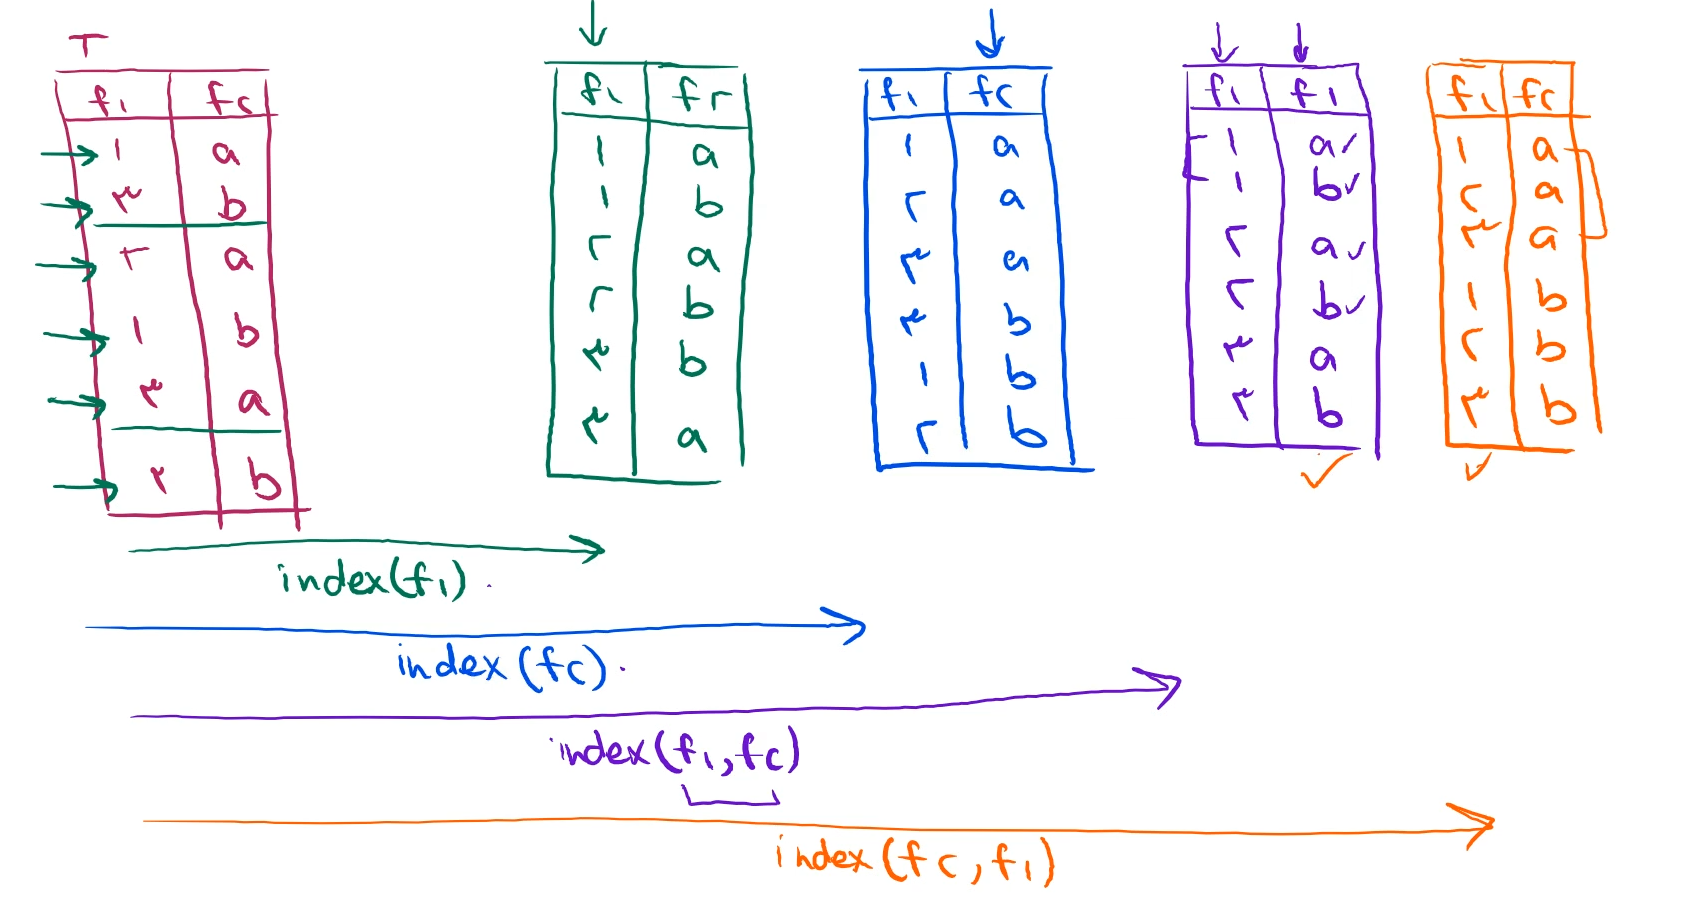
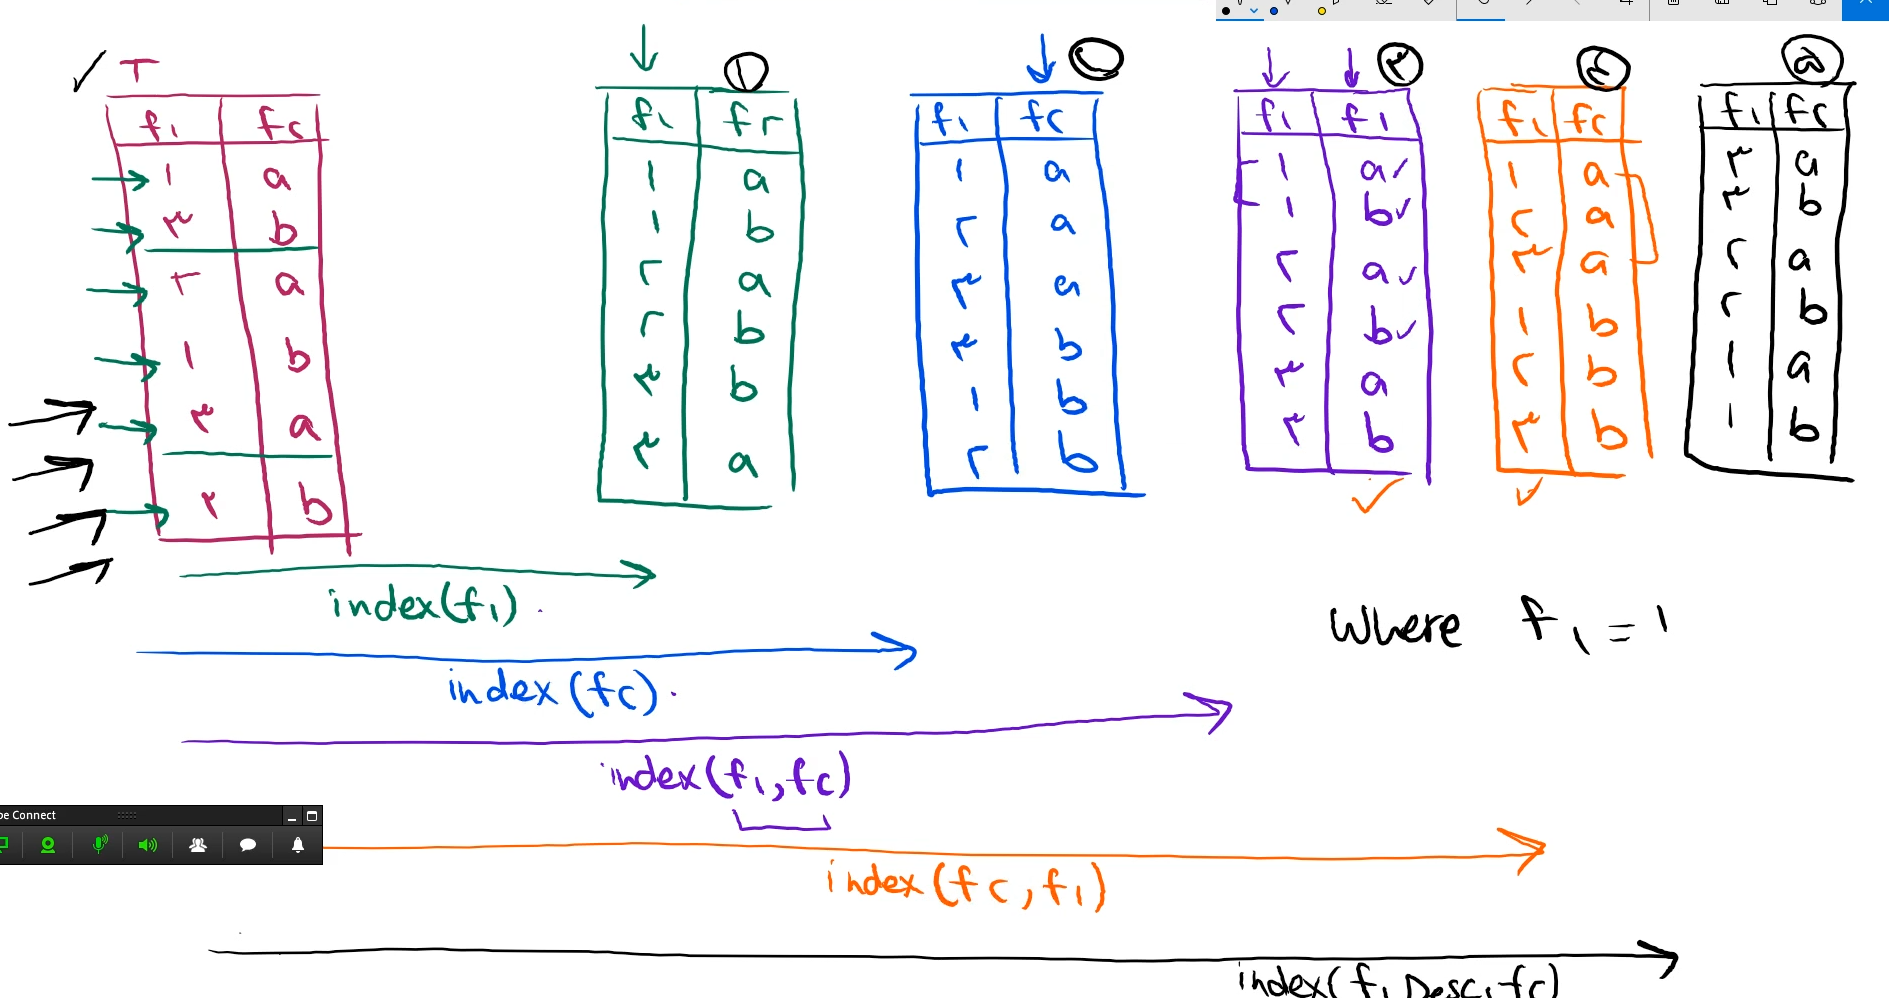
خوب اگر where داشتیم کدوم به دردمون میخوره برای پیدا کردن سریع اطلاعات
1 و 3 و 5 به دردمون میخوره خوب چون 2 بر اساس f2 مرتب شده پس بدرمون نمیخوره یعنی اگر توی این جدول ها هر کدوم از این ایندکس ها رو که داشتیم نریم براش دوباره یه ایندکس جدید بسازیم
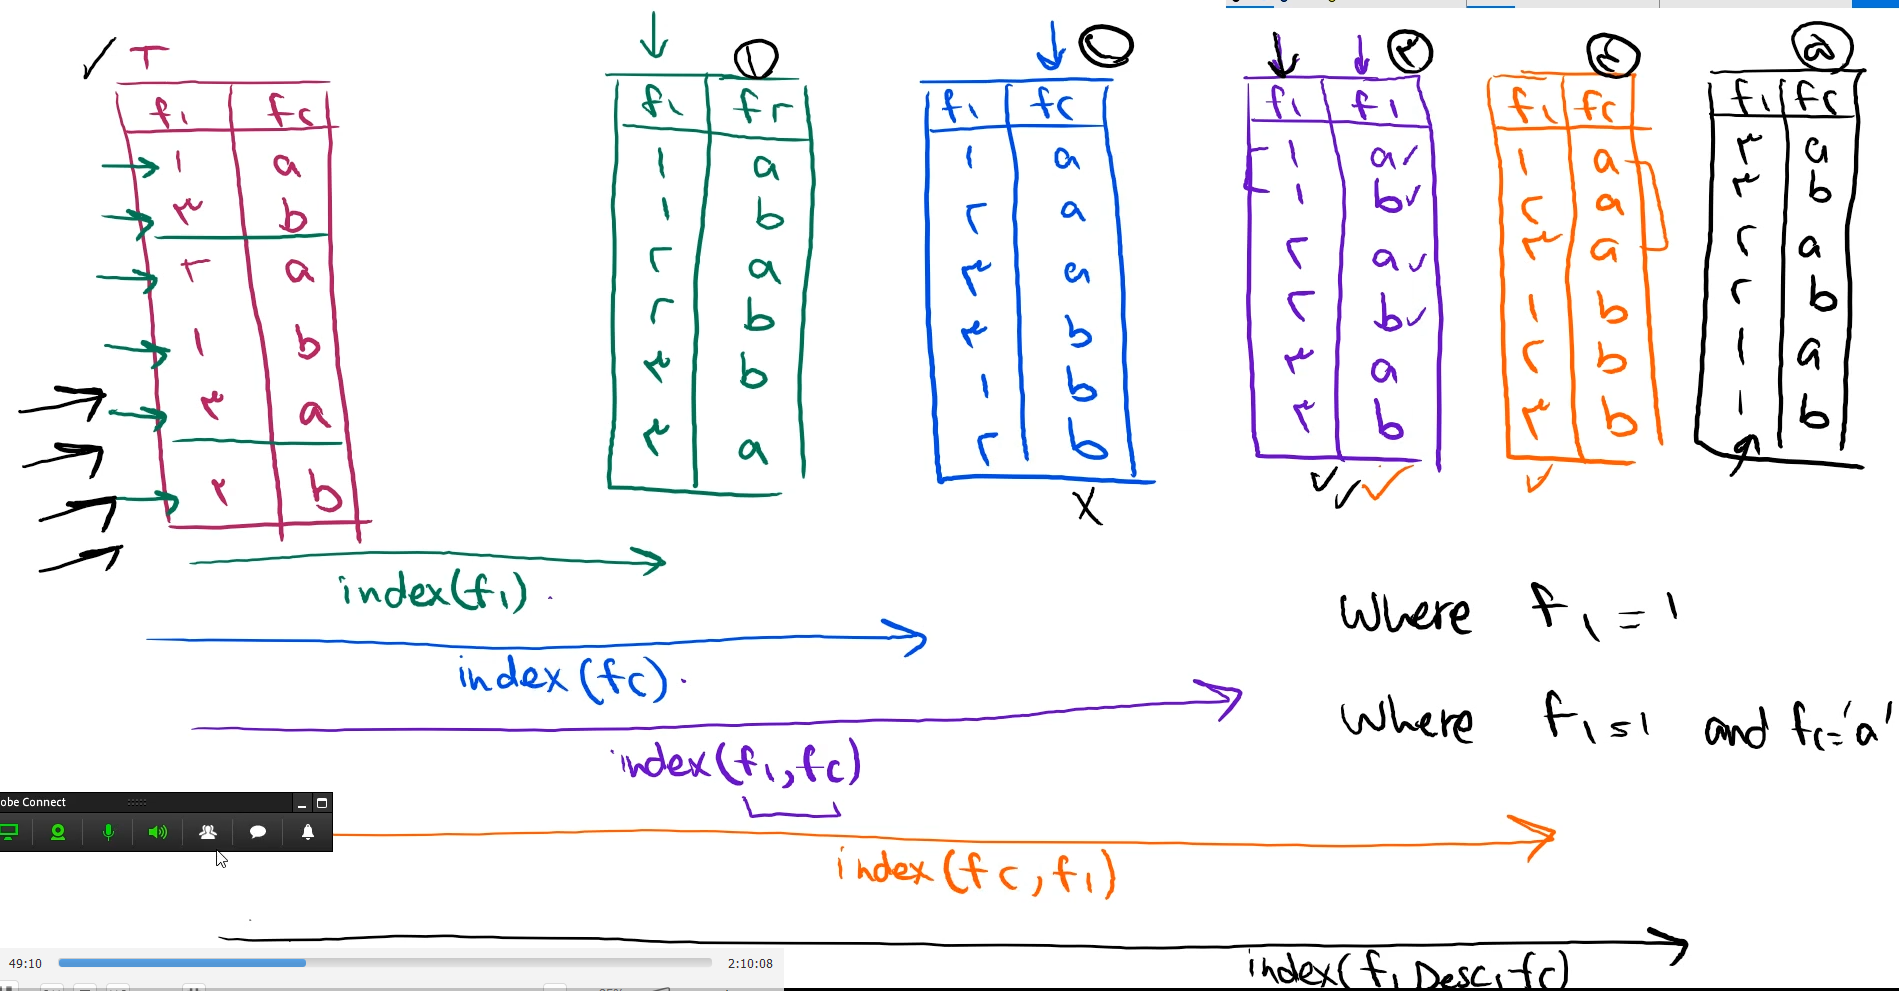
خوب توی این حالت دوم 1 و 2 به کارمون نمیاد چون توی 1 ما فقط دیتا رو بر اساس f1 مرتب کردیم و برای بدست آوردن f2 باید Squential search کنیم توی جدول 2 هم بر عکسشه
خوب 3 تای اخر بدرمون میخوره - و And خاصیت جابه جایی داره
3 یا 4 یا 5 اوکیه فقط 5 چون برعکسه یکم سرعتش پایین تره
به ازای هر رکورد 16 بایت ازمون فضا میگیره - یعنی اگر 1000 تا رکورد داشته باشیم 16000 بایت ازمون فضا میگیره
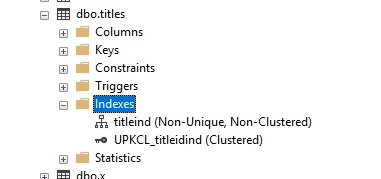
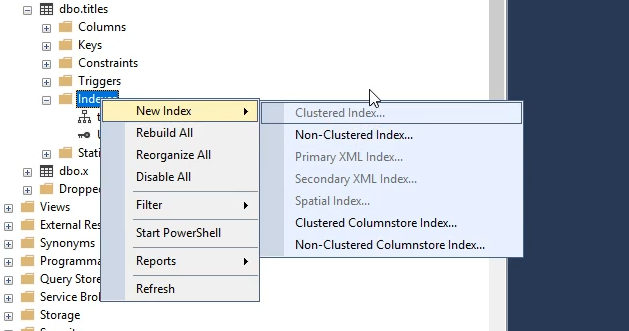
خوب اینجا ما clusterd index مون بسته است چون فقط هر جدول میتونه یه cluster index داشته باشه با بینهایت تا non clusterd
بقیه از روی اون clusterd ساخته میشن و میشن non - clusterd
خوب خوده sql server اومده این clusterd index رو ساخته - وقتی که pk رو ما تعیین میکنیم خوده sql servver میاد index میسازه از جنس اون PK و uniqe هستش
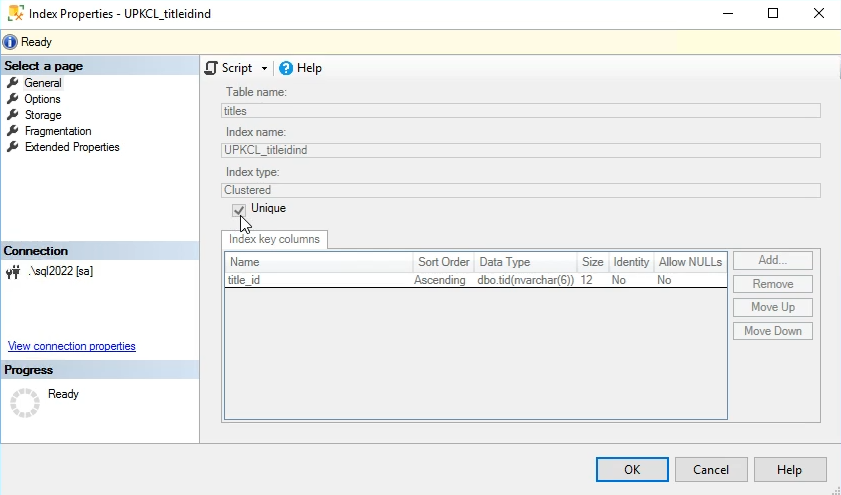
خوب حالا میرسیم به non clusterd ها
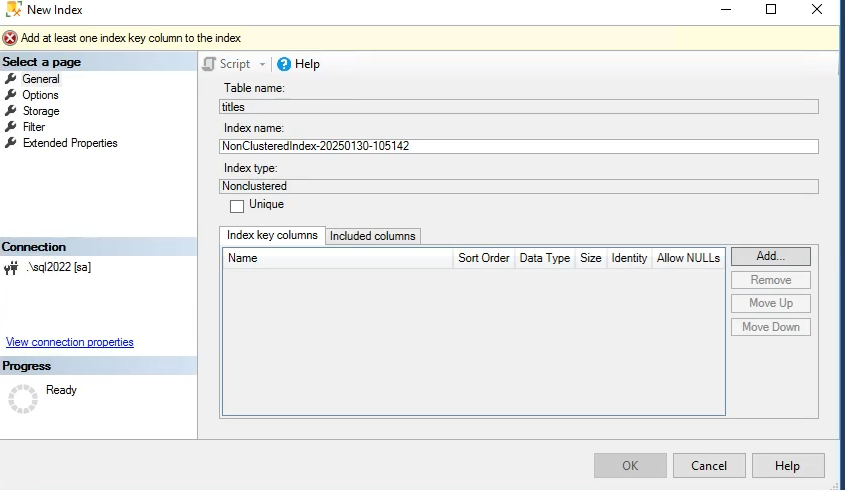
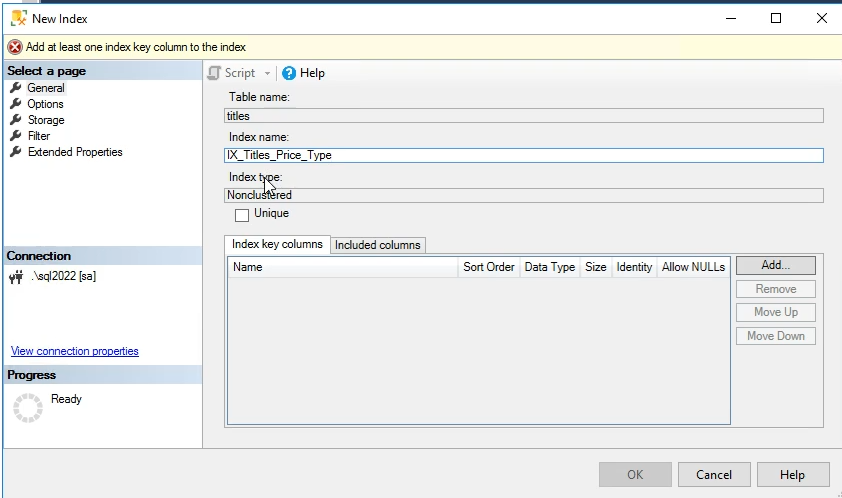
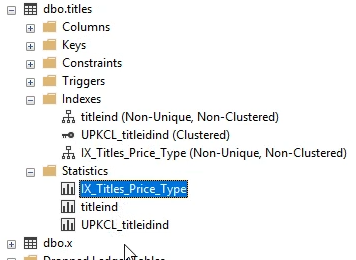
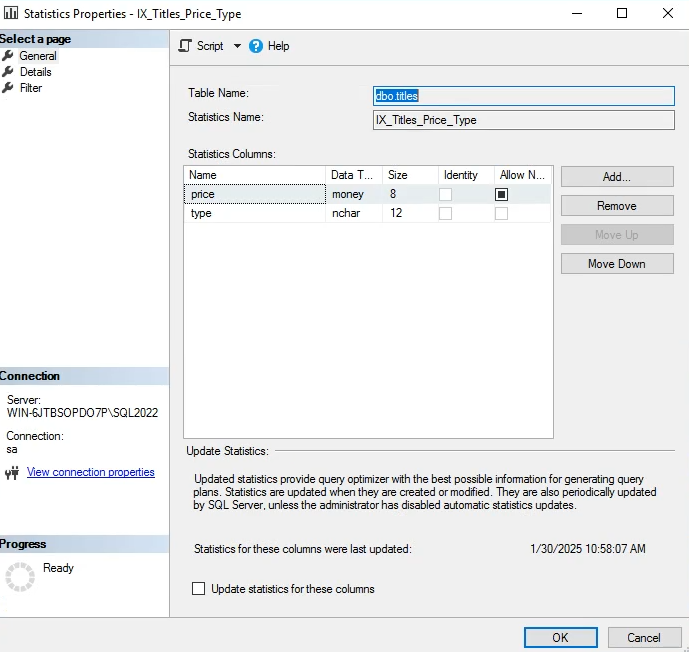
خوب مرسوم هستش که IX بسازیم شروعش رو با _ جداش میکنیم و اسم جدول رو میزاریم که میشه titles و بعد میشه اسم اون جدول / جدول هایی که قراره روش ایندکس بزاریم - خوب حالا اینجا میخوایم که multi cloumn باشه برای همین میخوایم اول بر اساس price مرتبش کنه و بعد بر اساس type
فقط فیلد هایی که لازم است رو باید uniqe اش کنیم مثل شماره ملی
حالا اگر ما اینجا uniqe رو بزنیم چون در price قیمت های یکسان داریم ، اجازه ی این کار رو به ما نمیده
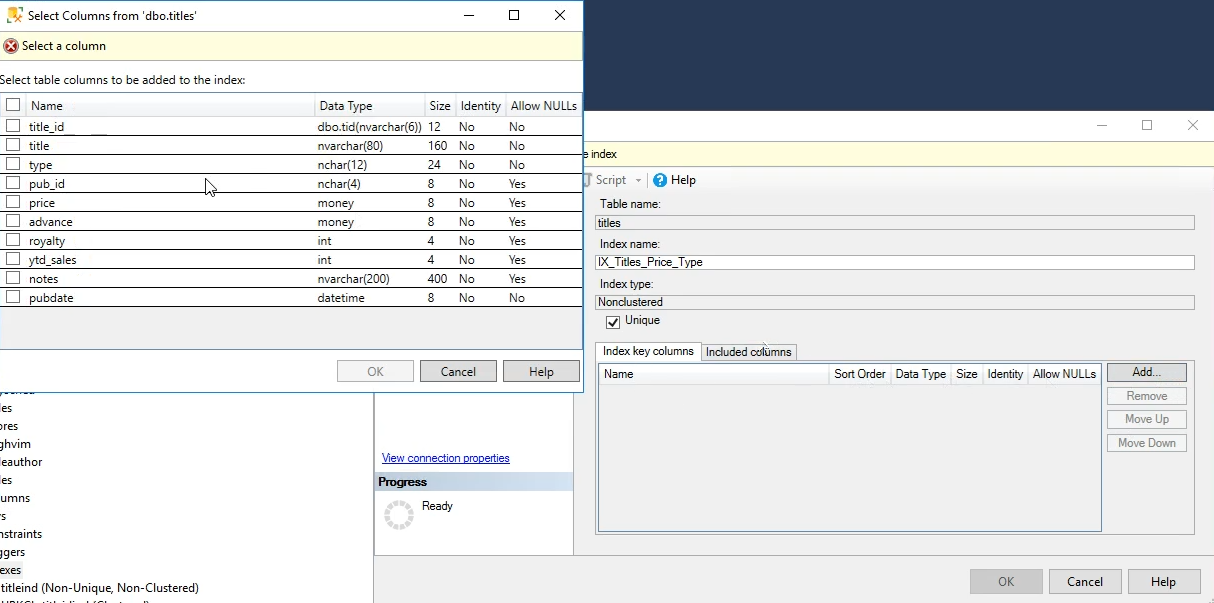
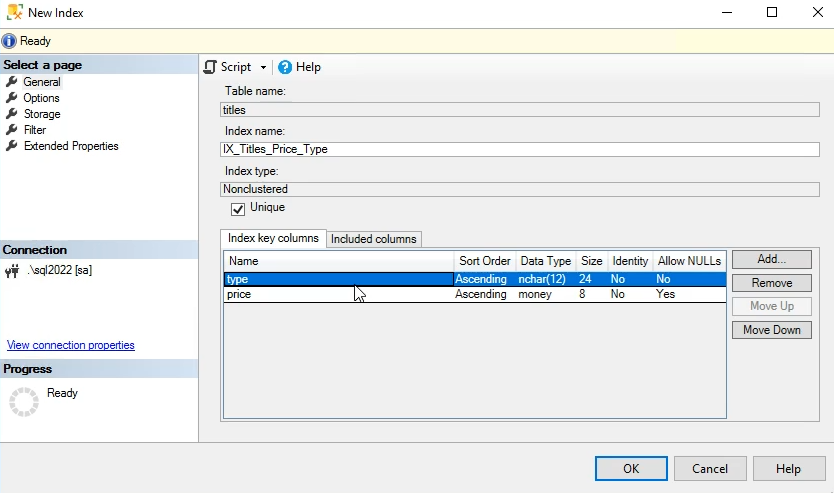
اینجا ما ترتیبش و درستش میکنیم
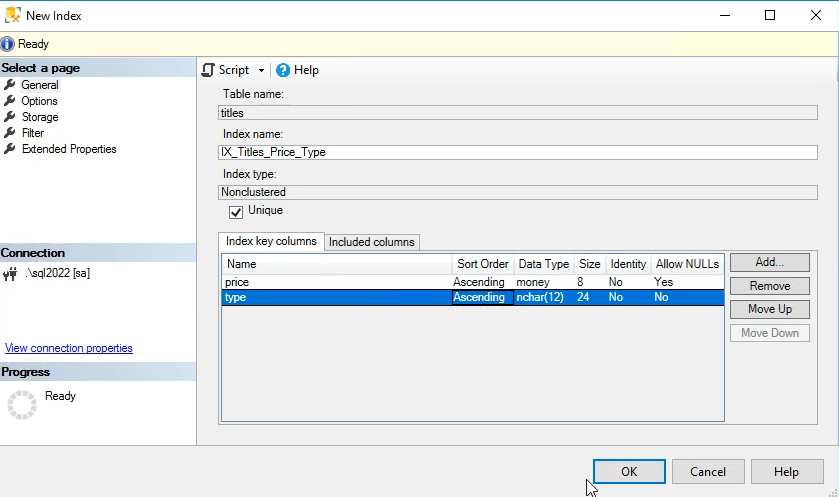
ارور همونه
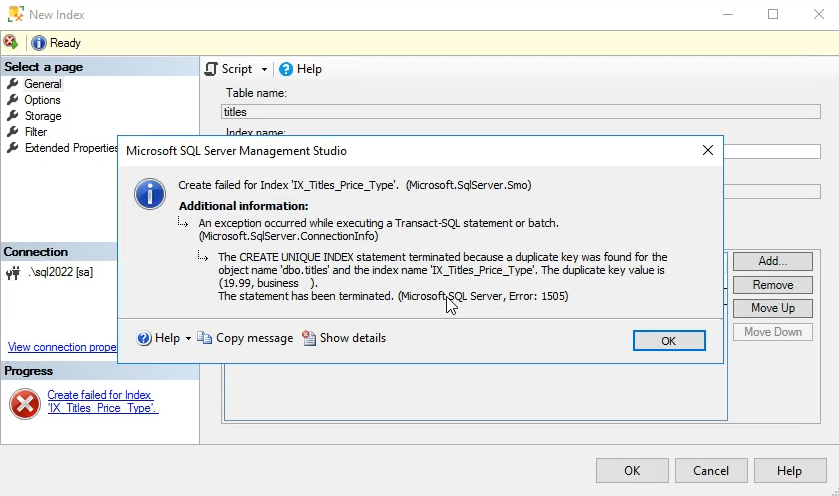
دقیقه توی ارور هم نوشته که 16,99 تکرار هستش
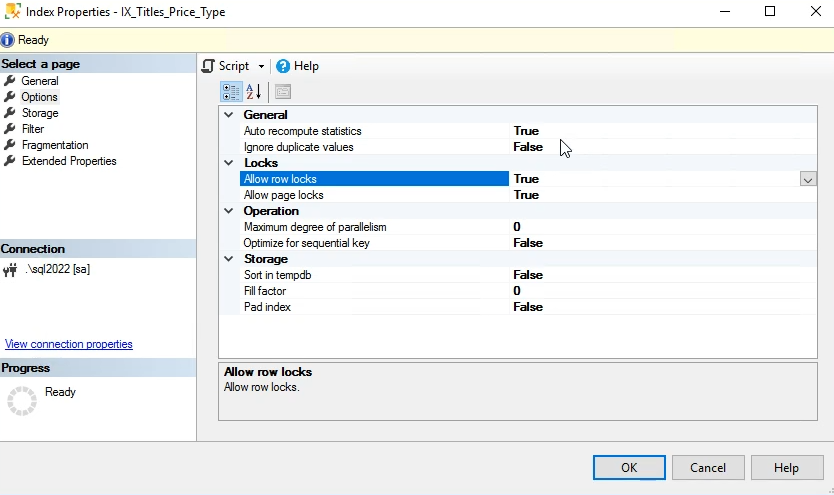
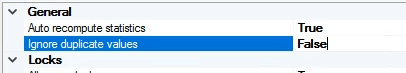
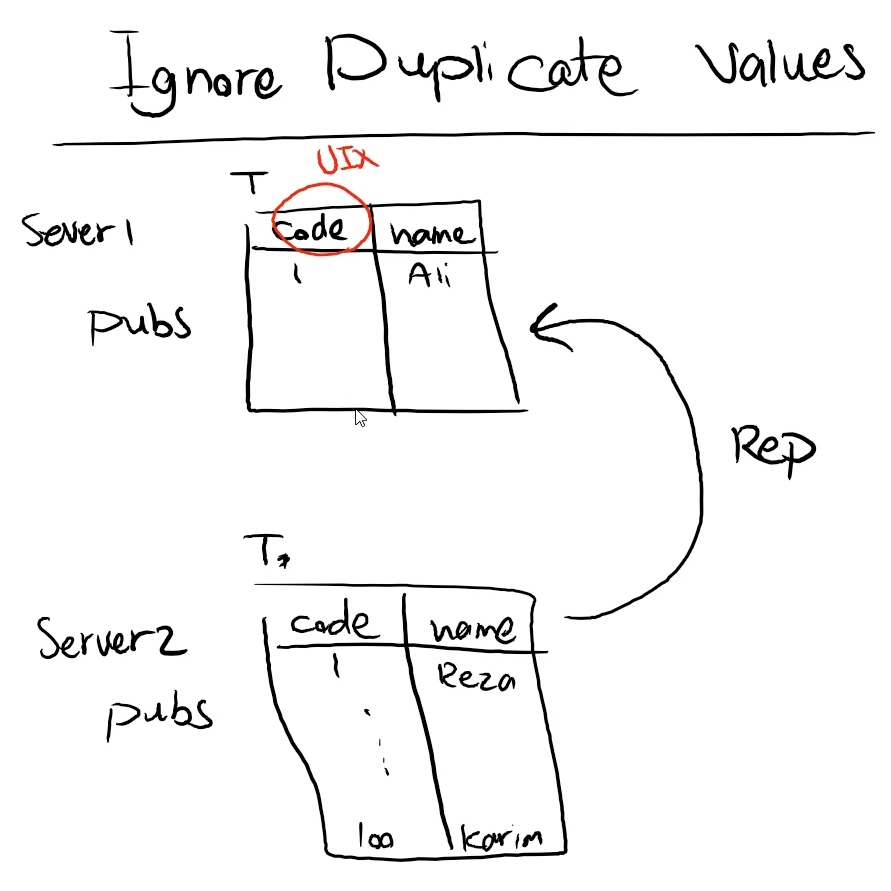
خوب میخوایم هر شب دیتا های جدول پایین رو بریزیم توی جدول بالا خوب اینجا یه حالتی پیش میاد اینجا ما 1 ali رو داریم حالا میخواد 1 reza رو بریزم اونجا ولی اونجا uniqe بودن رو داره پس نمیشه که انتقال بدیم - اگر ignore duplicate values = false باشه عملیات میره توی دیوار - توی این حالت هیچ دیتایی انتقال پیدا نمیکنه
حالا اگر بزاریم true - میشه و دیتا ها انتقال پیدا میکنن ولی دیتا هایی که تکراری نباشن انتقال پیدا میکنن - منظور - فقط code رو تکراری میکنه - اونهایی که تکراری باشن رو نمیاره
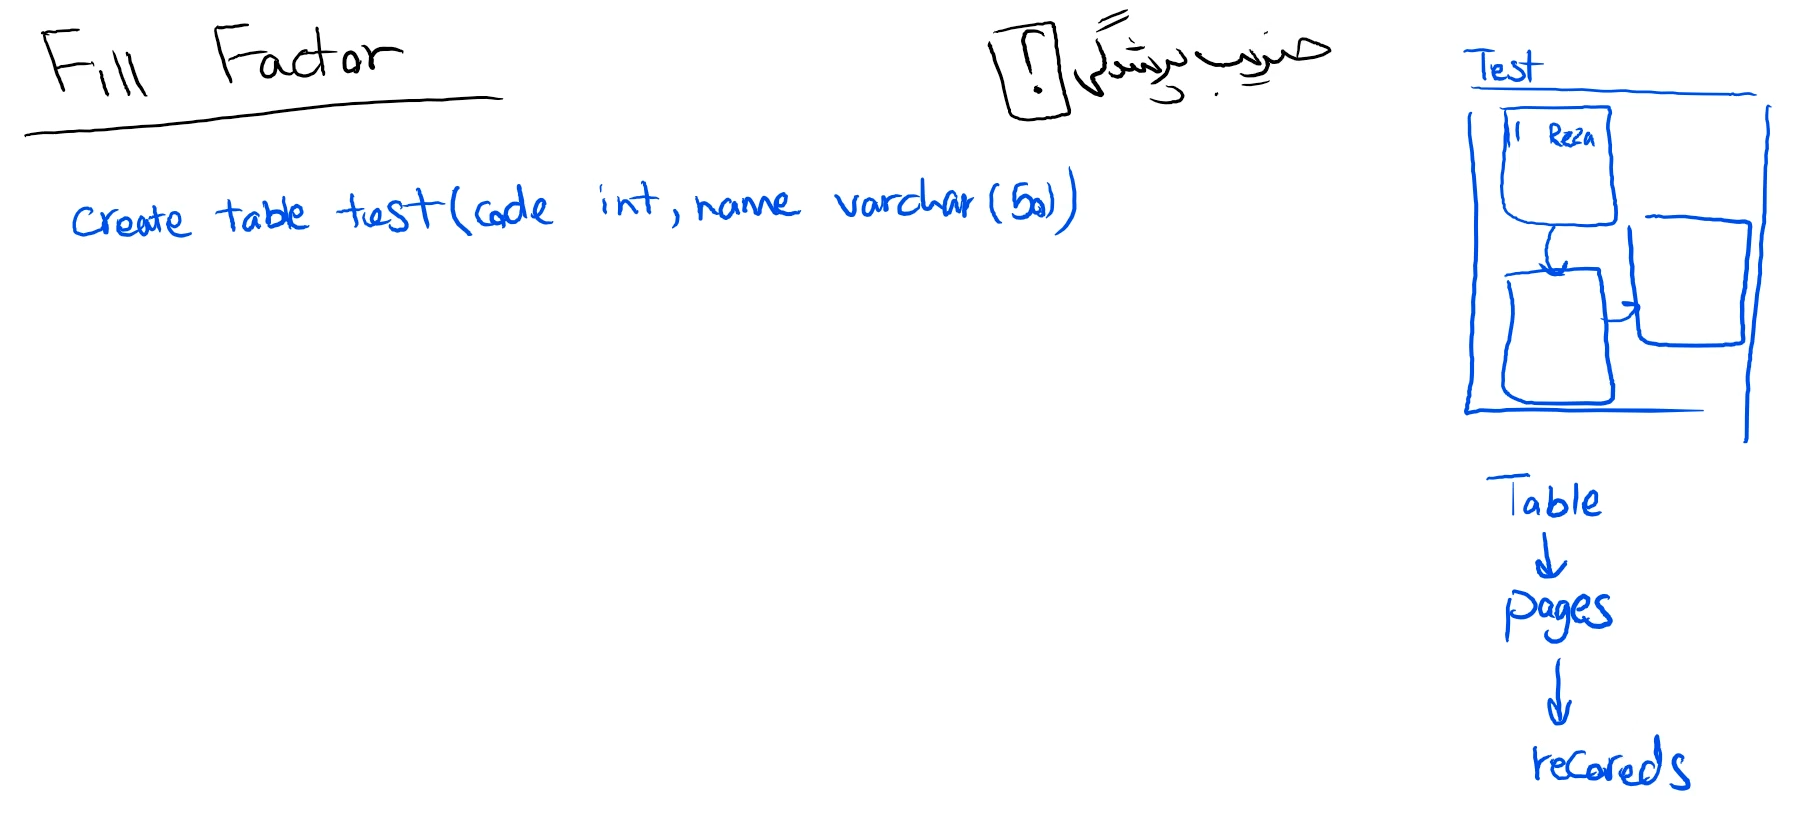
لایه page ها قابل دیدن نیست - چون لایه سخت افزار هستش
هرکدوم از page ها 80060 بایت در حافظه جا میگیرند که 8000 تاش رکورد ها هستش و 60 تاش internal هستش
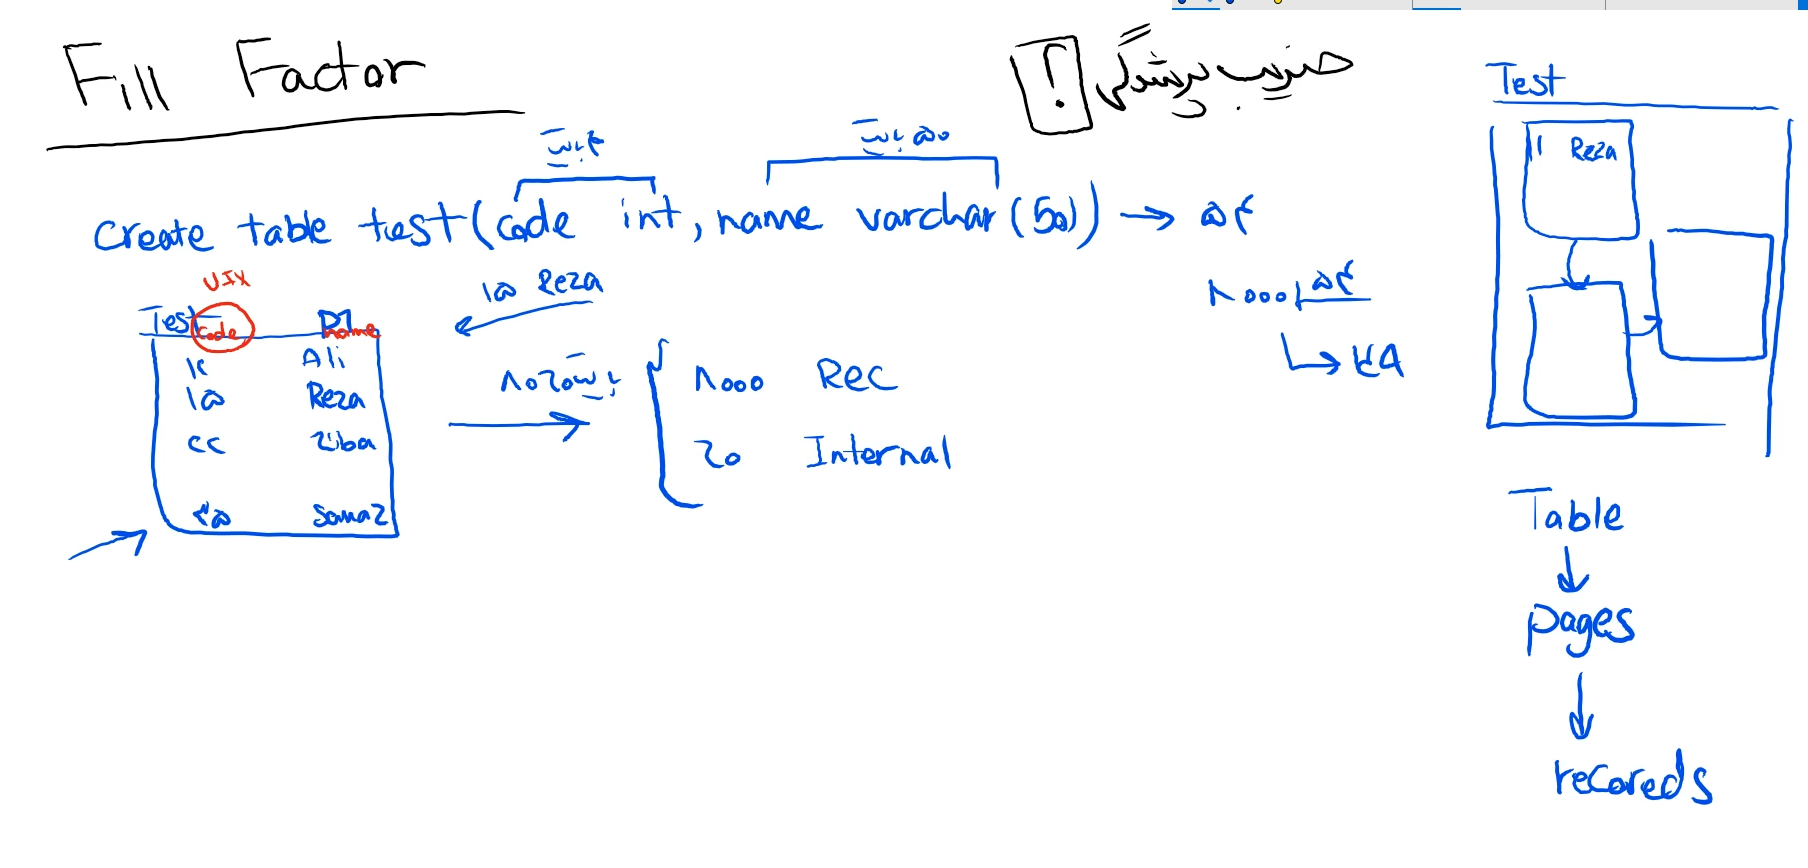
که ما به طور مثال 149 تا رکورد میتونیم داشته باشیم در هر page و وقتی که این page پر میشه میره یه page دیگه درست میکنه
از پیج قدیم یه pointer میزنه به page جدیده که این میره توی اون حافظه internal که 60 بایت هستش ذخیره میشه آدرسش
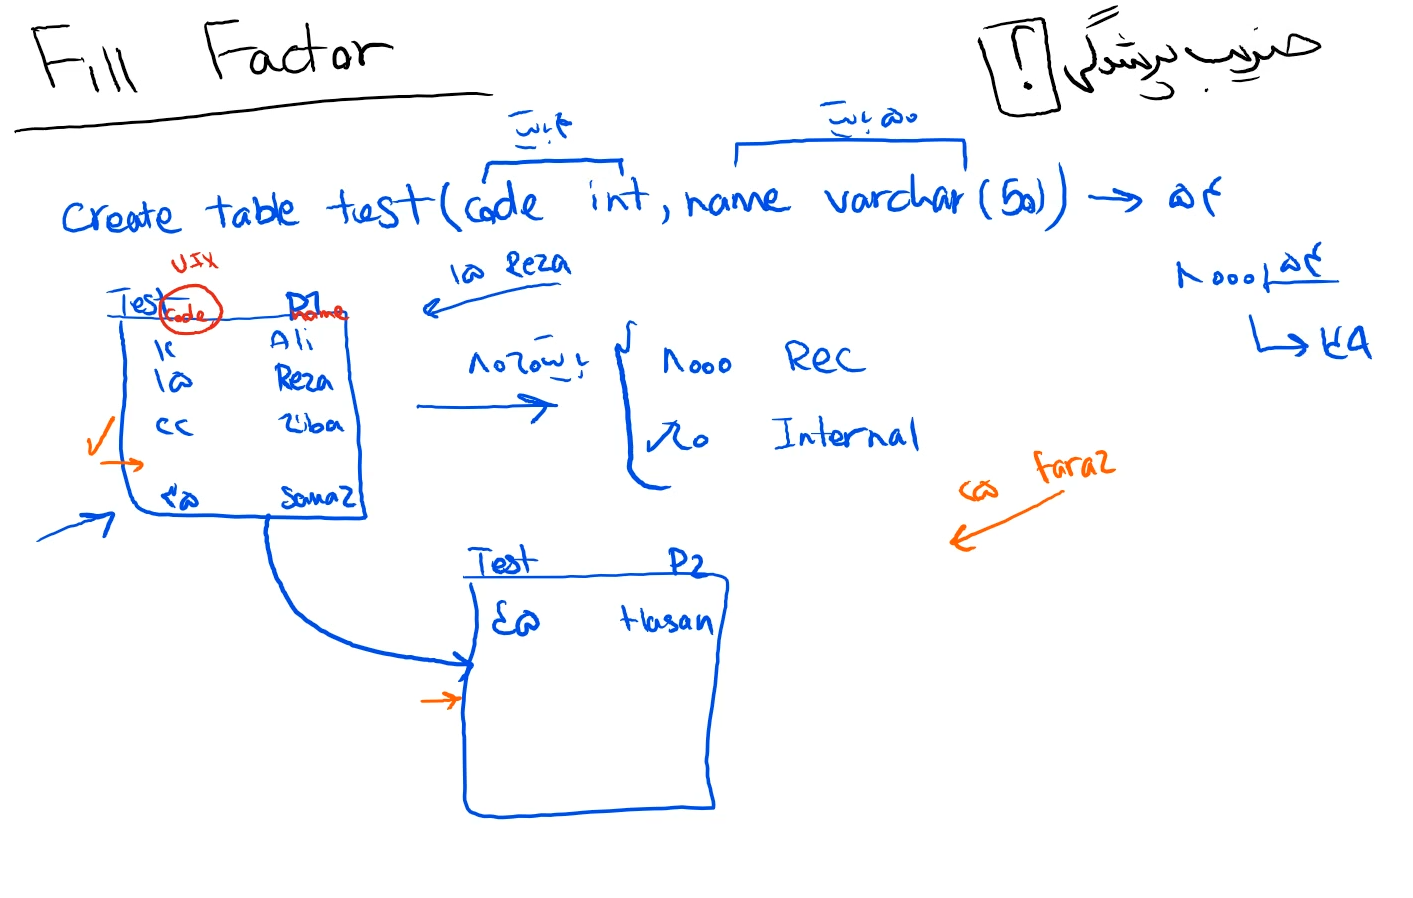
حالا 25 میخواد وارد بشه ، توی صفحه قبلی که پر شده باید بره ، حالا اتفاقی که میوفته اینه کخه
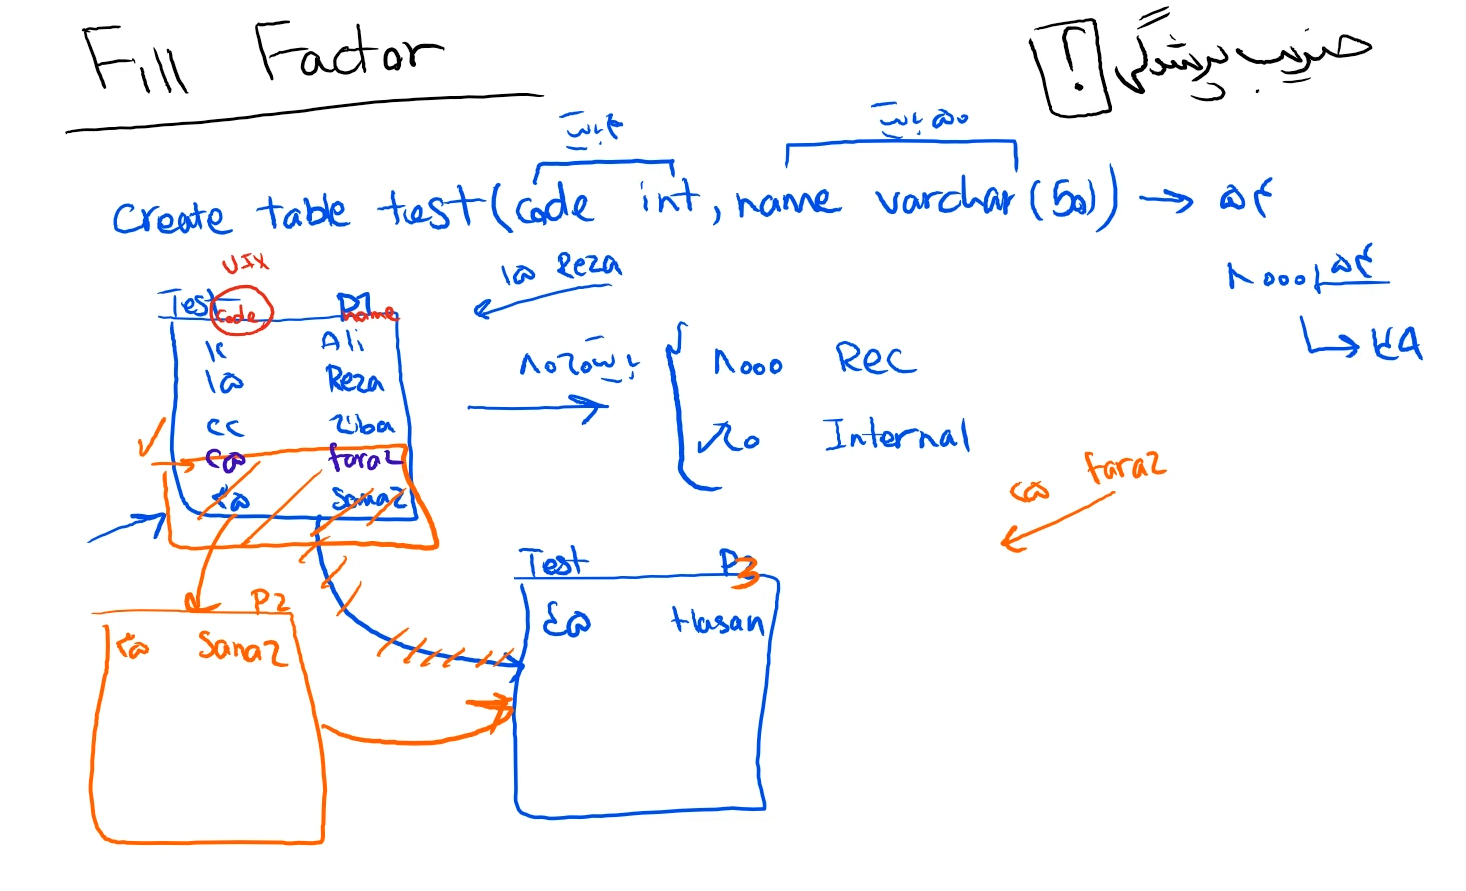
میاد اول ارتباط p1 , p2 رو قطع میکنه و میره یه page جدید درست میکنه و بعد میاد یه مقداری از p1 رو میریزه توی اون page جدید که اینجا اسماشون رو تغییر دادیم , و بعد اون دیتا رو میزاره جایی که باید باشه و به این عملیات میگن page split
سرعت تمامی عملیات رو کند میکنه page split یعنی create , select , update , delete
برای این که کمتر page split توی اینجا اتفاق بیوفته از ضریب پر شدگی page ها میتونیم استفاده کنیم
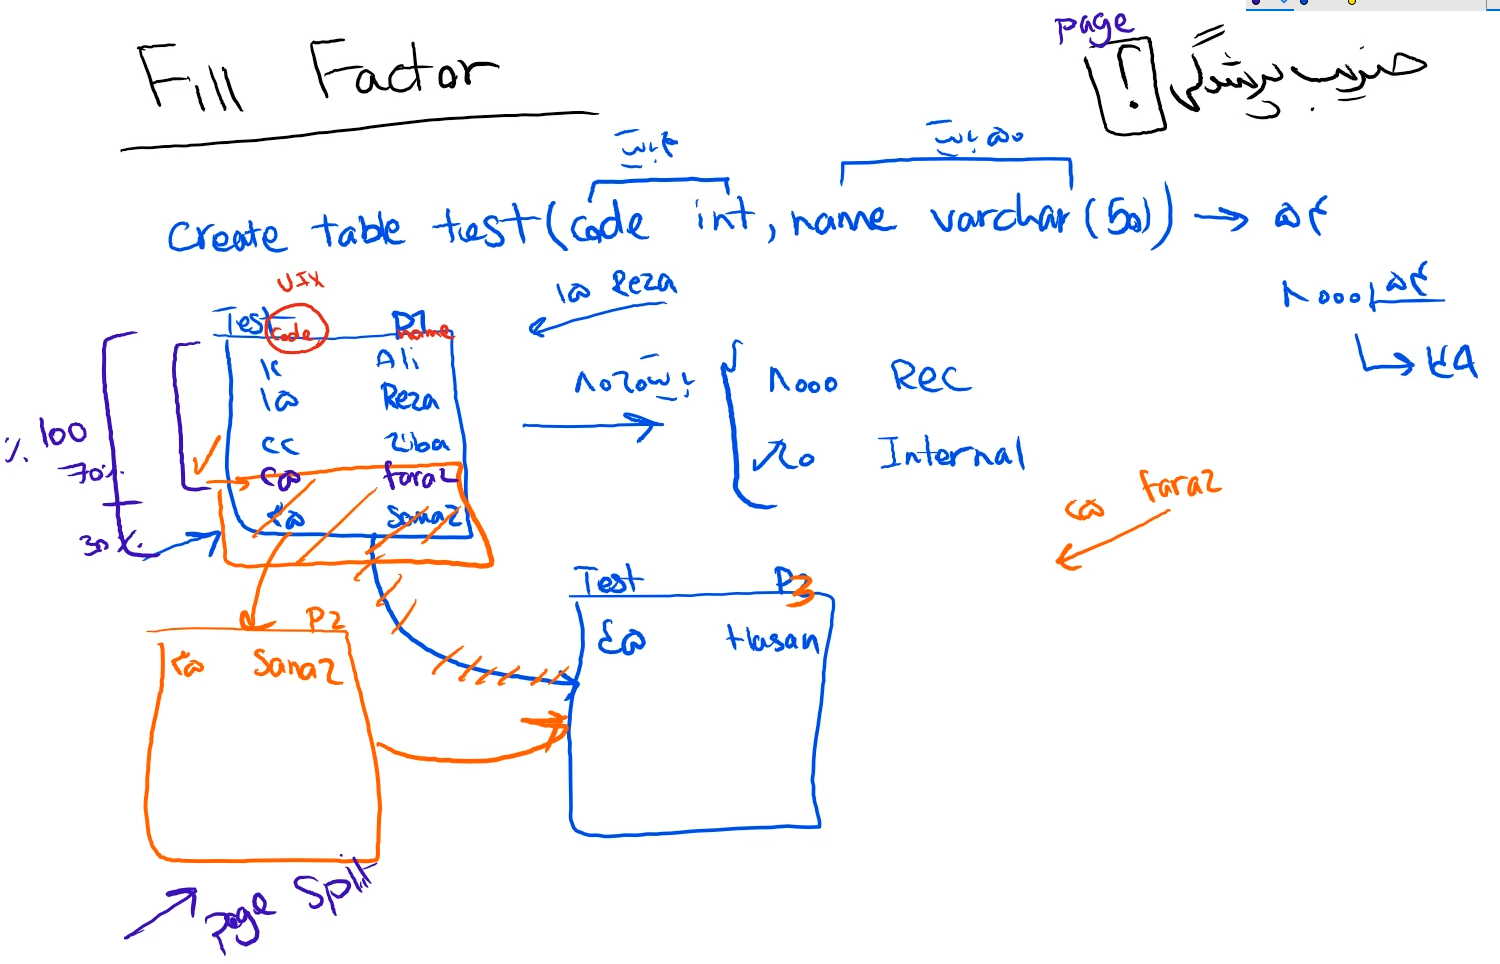
خوب به جای این کار میایم میگیم مثلا از 100 درصد 70 درصداش رو استفاده کنیم و 30 درصداش رو بزاریم برای مواقعی که مثلا یه رکوردی که 25 هستش میاد داخل دیگه page spliting اتفاق نیوفته
یک خاصیتی که باید داشته باشه اینه که دیتایی که میزنیم نخواد بره وسط رکورد ها - مثلا تاریخ ، ما هر تاریخی که میزنیم بزرگتر از تاریخ قبلی هستش
و time span ها و اینها 100 درصد باشه fill factor باشه
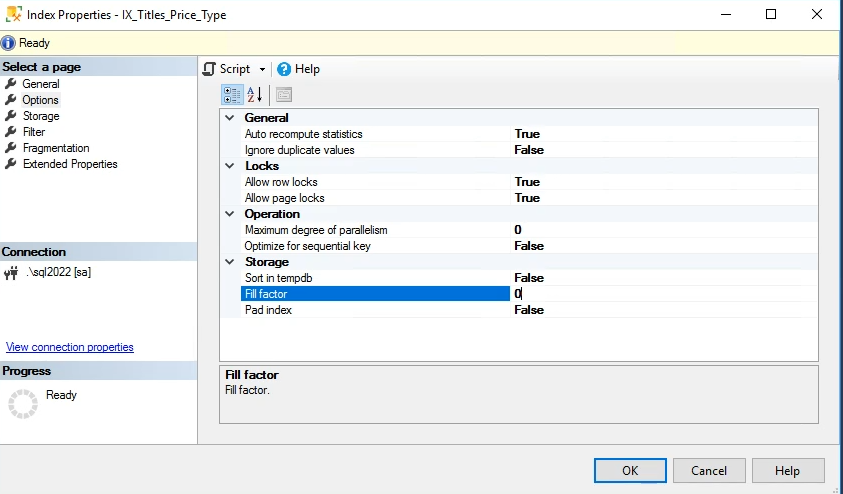
اینجا درسته که 0 هستش ولی sql server به صورت دیفالت 70 درصد در نظر میگیره
خوب حالا اگر فیلد identity باشه این روی 100 هستش چون اجازه نمیده فیلدی جدیدی وارد بشه
1:34:35 پارت 2
خوب میرسیم به pad index میاد روی fill factor سوار میشه
خوب دیتا ها به صورت binary tree
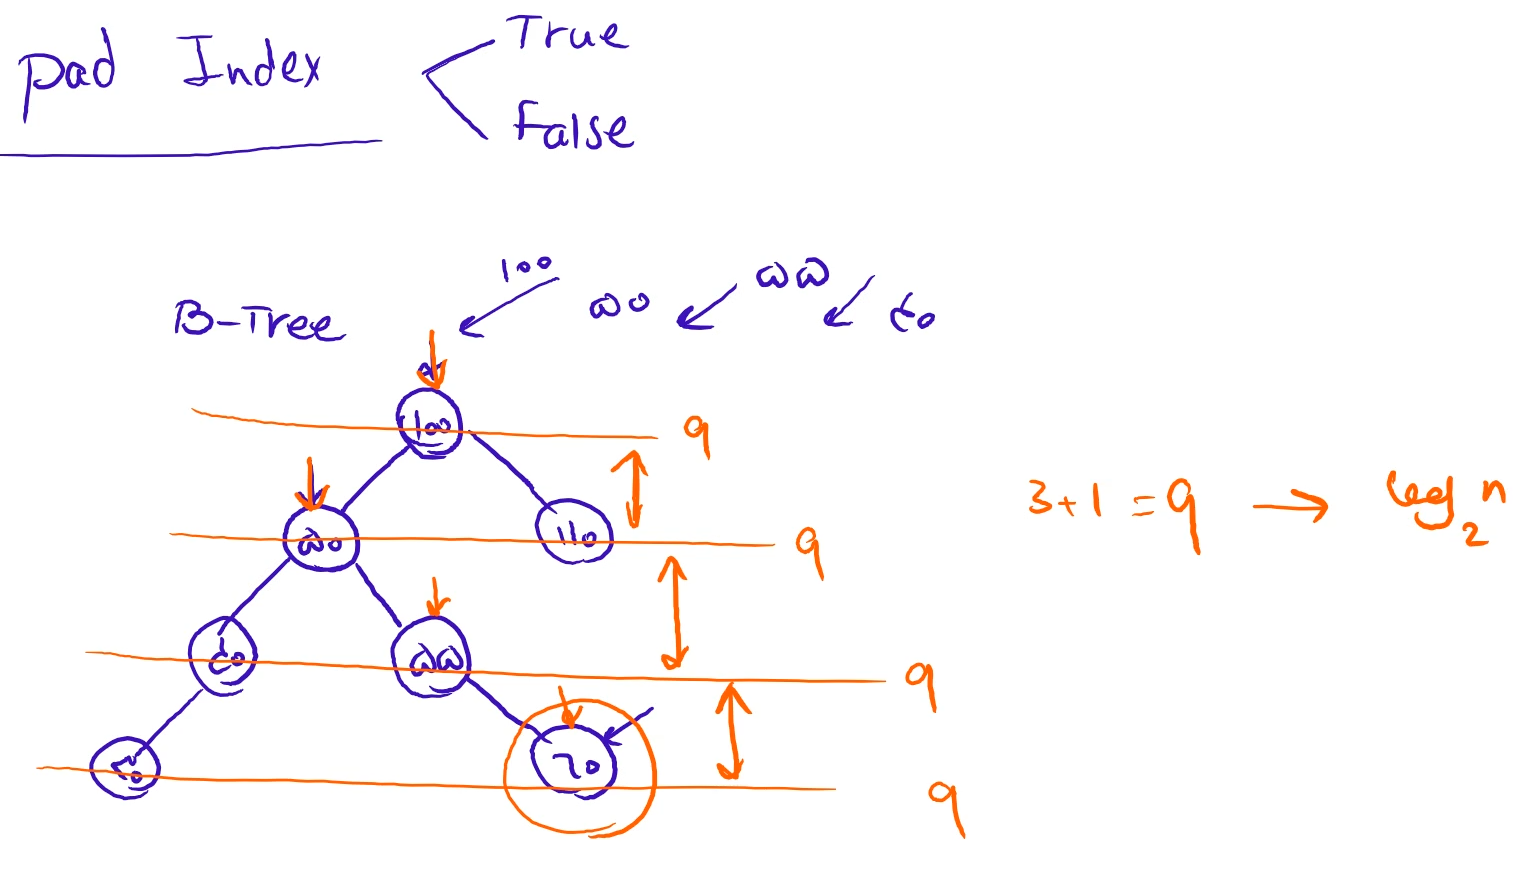
خوب page ها به صورت binary tree به هم وصل هستند
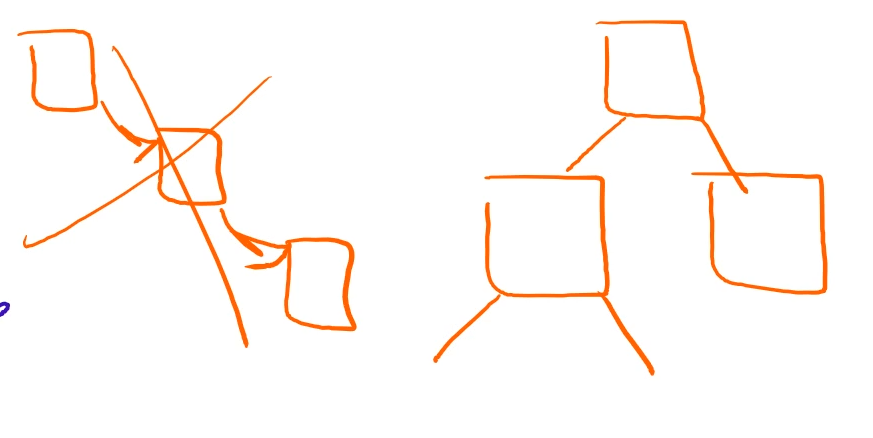
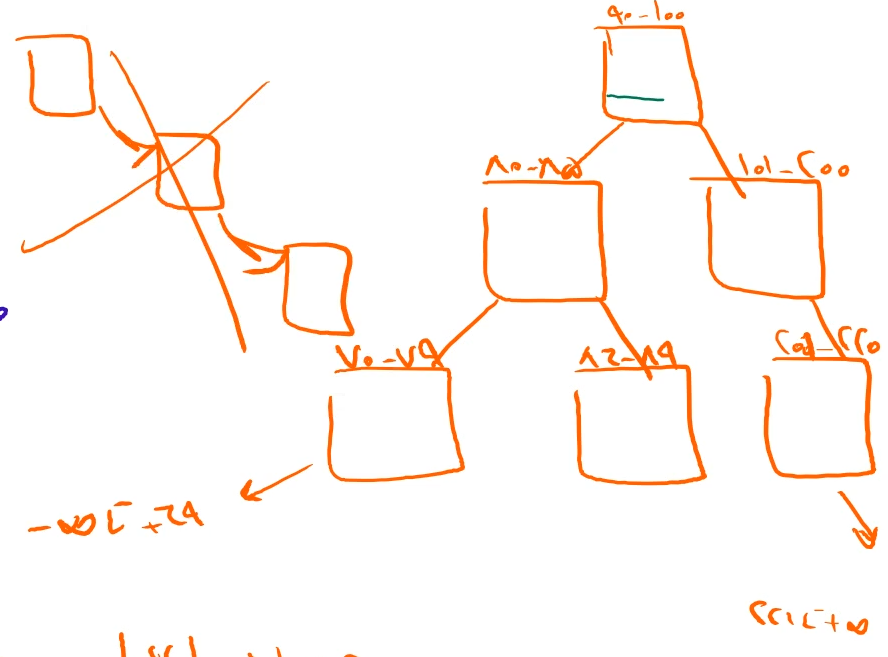
خوب اتفاقی که میوفته اینه که اگر pad index false باشه فقط میاد برای leaf ها فضای اضافه در نظر میگیره - چون معمولا دیتاهای جدید در leaf ها اضافه میشه -
اگر دیتا جدید در لایه intermadiate انجام بشه page spoliting اتفاق میوفته
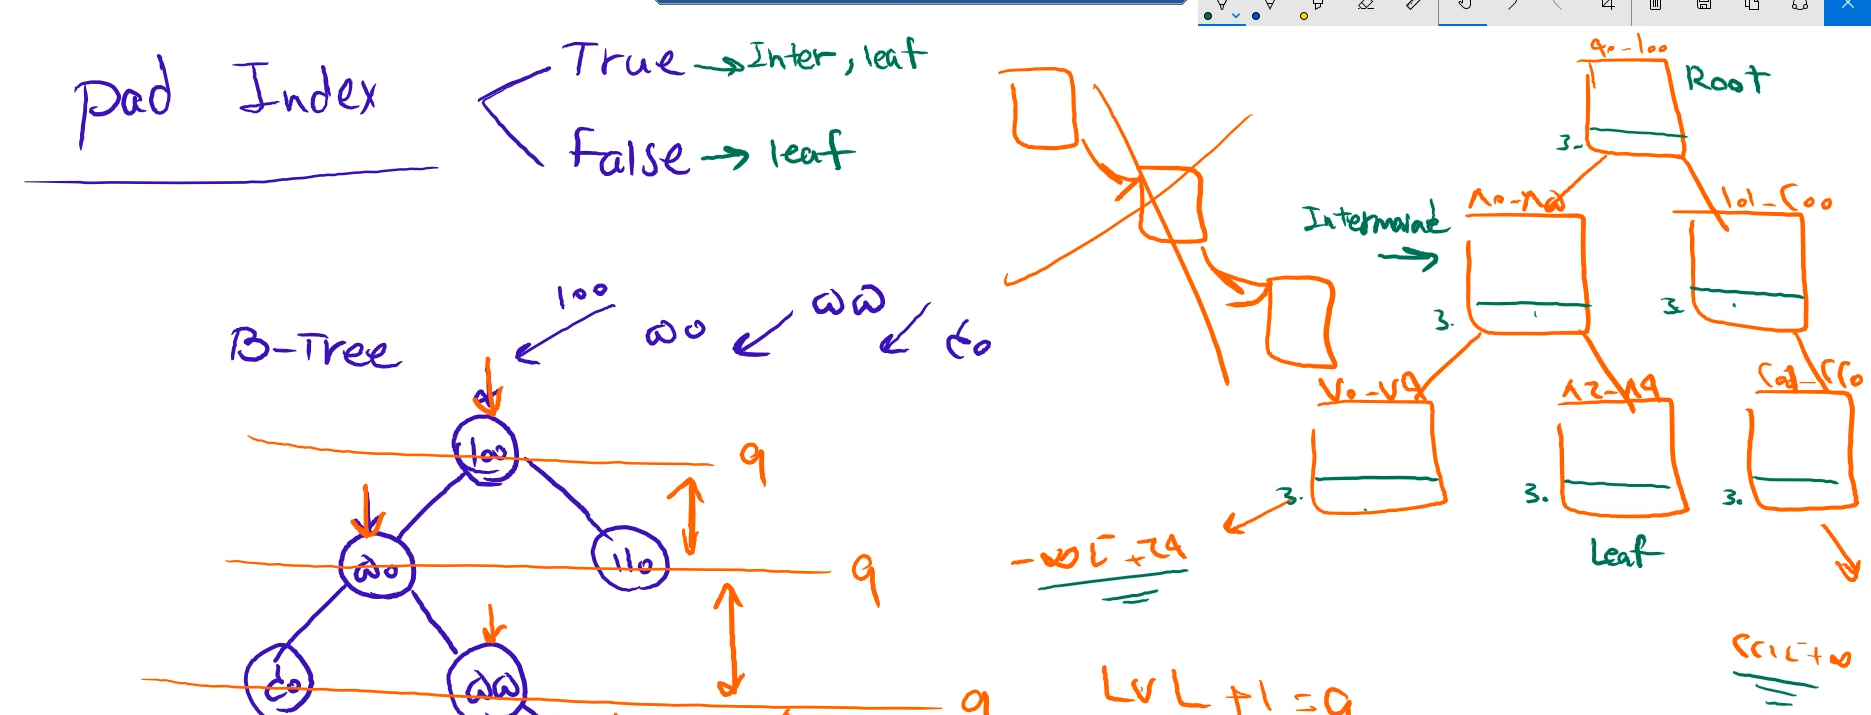
خوب توی حالتتی که pad index true باشه شاخه intermadiate و leaf هست
اگر pad index true باشه ما سرعت insert update delete مون میره بالا چون همه جا فضای خالی اضافه هستش - ولی به دلیل همین قضیه page هامون تعدادش زیاد میشه و به همین دلیل سرعت سرچمون میاد پایین
و برعکس هم - نتایجش رو برعکس میکنه
خوب یه پروسه index گزاری داریم - که میاد دیتاها رو مرتب میکنه و براساس یه فیلدی که خودمون تعیین میکنه این کار رو میکنه و بعد دیتا ها رو ذخیره میکنه - جایی که میلیاد تا دیتا داره این پروسه زمان بر هستش
پروسه rebuild index داریم - بعد از یه مدتی درخت باینری که درست میشه ممکنه دیگه efficent نباشه و باید توی این حالت باز سازیش کنیم و این re build index هم زمان بر هستش
خوب حالا فرض کنید که ما یکدوم از این پروسه های بالا رو داریم انجام میدیم و یه سری هم در همین حین میخوان selct بزنن
خوب توی این حالت sql server برای index گزاری میاد اون رکورد هایی که قرار روشون این عملیات انجام بشه رو از دسترس خارج میکنه و به اصطلاح lock میشه خوب این lock شدنه چدین تا سطح داره یا خوده اون سطره - یا page یا table هستش
خوب کدومش بهتره که اتفاق بیوفته ؟
خوب اگر هر دو تا page lock , row lock رو تیک بزنیم خوده Sql server تصمیم میگیره که کدوم بهتره
خوب زمانی که ما میخوایم یه رکورد جدید که داره وارد دیتابیس میشه رو بهش index میدیم خوب Sql میگه که row lock بشه
خوب حالا اگر 100 تا رکورد داره وارد سیسیتم میشه - page ما 101 ظرفیت داره - توی این حالت میاد page رو lock میکنیم
وقتی که lock میکنیم سرعتش بیشتر میشه چون کس دیگه ای بهش دسترسی نداره
اگر page lock , row lock رو false کنیم همیشه table رو lock میکنه
اگر دیتا خیلی مهم باشه - باید بیایم table رو lock کنیم مثل موقع هایی که بانک ها مثلا از دسترس خارج میشن
خوب اگر 5 ملیون رکرود جدید قراره وارد باشه - میایم index رو خاموش میکنیم و دیتا رو میزیم توی جدول و بعد دوباره index میزاریم
خوب ما یه چیزی داریم به اسم que یا صف که درخواست ها میرن توی صف
اوراکل یه چیزی داره به اسم feild lock که فقط همون فیلد رو lock میکنه
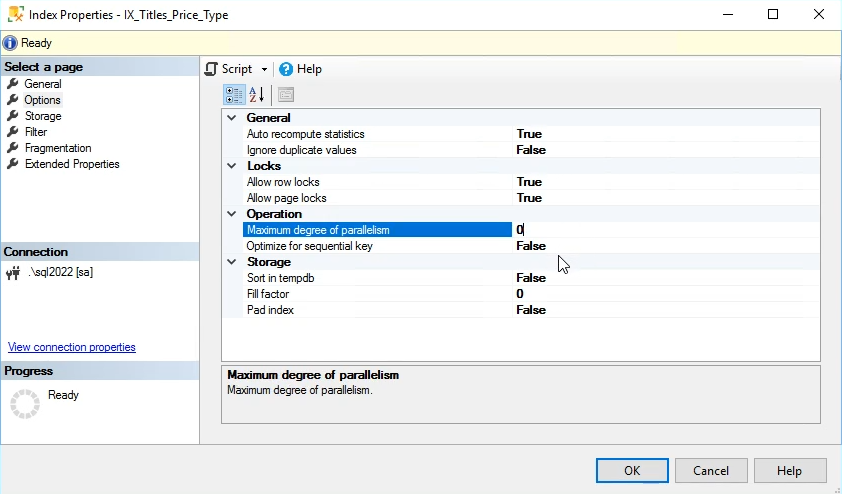
خوب این cpu ها درگیر برای پروسه index گزاری هستش رو تعیین میکنیم تمام core ها رو به این ندیم / نصفش رو بدیم — به ازای این که 0 نوشته باشیم میره کل core های cpu رو میگیره
خوب sort in temp db میتونیم پروسه ی index گزاری رو ببریم توی temp db انجام بدیم index گزاری رو و مرتبش کنیم و بعد برگردونیم به دیتابیس اصلی خودمون - سرعت رو میبره بالا
اگر temp db سرش شلوغ باشه و ازش جاهای دیگه داریم استفاده میکنیم این پردازش رو نباید بندازیم گردنش
خوب auto recompute satitstic -
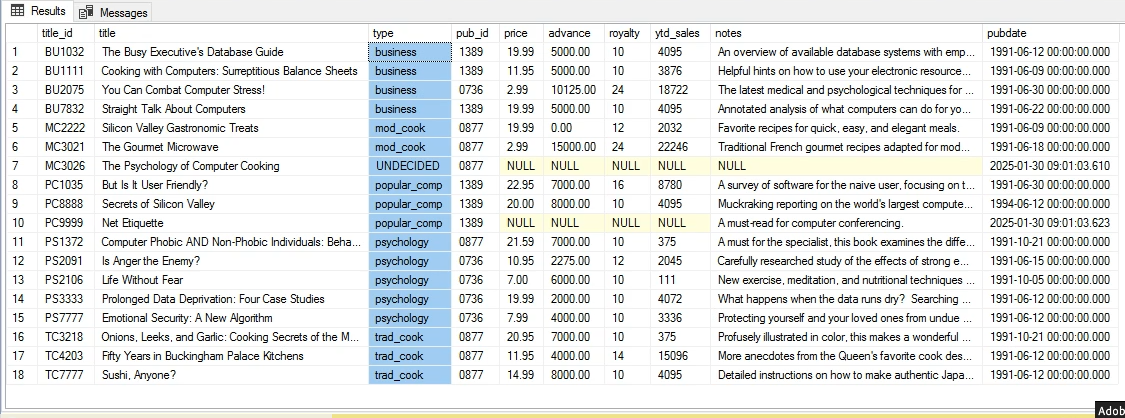
خوب اینجا اگر بخوایم بر اساس درصدی هر کدوم از این تایپ ها رو محاسبه کنیم - وقتی که روی type میایم index میزاریم - میزان فراوانی دیتا رو بر اساس مقادیردیتا ها مشخص میکنه
مثلا 20 درصد busisnesi و … و این آمار رو میبره میزاره اینجا
خوب 32 ملیون اشخاص رو میخوایم بریزیم توی دیتابیس - همه اون هایی که مال استان تهران هستند و حقوقشون از یه یه مبلغی بالاتر هستن رو میخوایم حقوقشون رو دوبرابر کنیم
خوب اول یه اکسل 1 ملیونی اماده شده - که قرار شده اون رو اول بریزیم - خوب روی cloum استان index میزاریم که همه sort بشن
خوب اینجا وقتی که ما این 1 ملیوین دیتا رو ریختیم میگه که 99 درصد این دیتا همشون برای تهران هستند - توی این حالت چون 99 درصد دیتا تقریبا sort هستش اینجا دیگه از index ها استفاده نمیکنه یعنی دیگه به روش binary tree نمیره دیتا ها رو پیدا کنه و update رو انجام بده و update اش سریع اتفاق میوفته
خوب حالا 31 ملیون دیتا دیگه بهمون میده که توی این حالت برعکسه - فقط 1 درصد تهرانی هستن و 99 درصد سایر استان هاست - حالا اینجا دیگه پراکندگی دیتا زیاد هستش - حالا توی این حالت از index استفاده میکنه و میره تهرانی ها رو sort میکنه
خوب Sql میاد از Statistics استفاده میکنه برای تشخیص این که از index استفاده کنه یا خیر خوب این statistics رو باید اپدیت نگه داریم
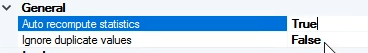 اگر این true باشه هر شب که index گزاری انجام میشه اون آمار ها هم آپدیت میشه
اگر بخوایم در آن واحد انجام بشه این تیکه رو میزنیم
قسمت سوم
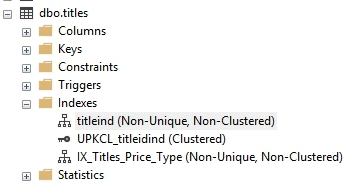
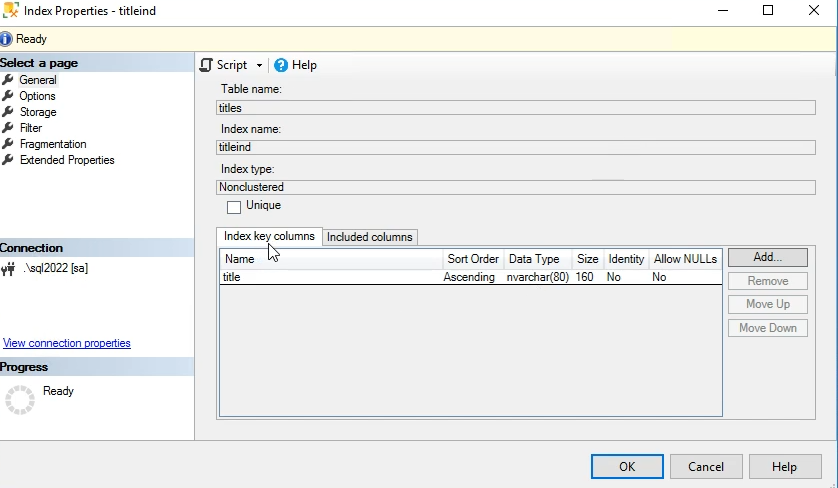 ]
خوب یه چیزی داریم به اسم included cloumns یه محدودیتی داریم برای ساختن ایندکس ها
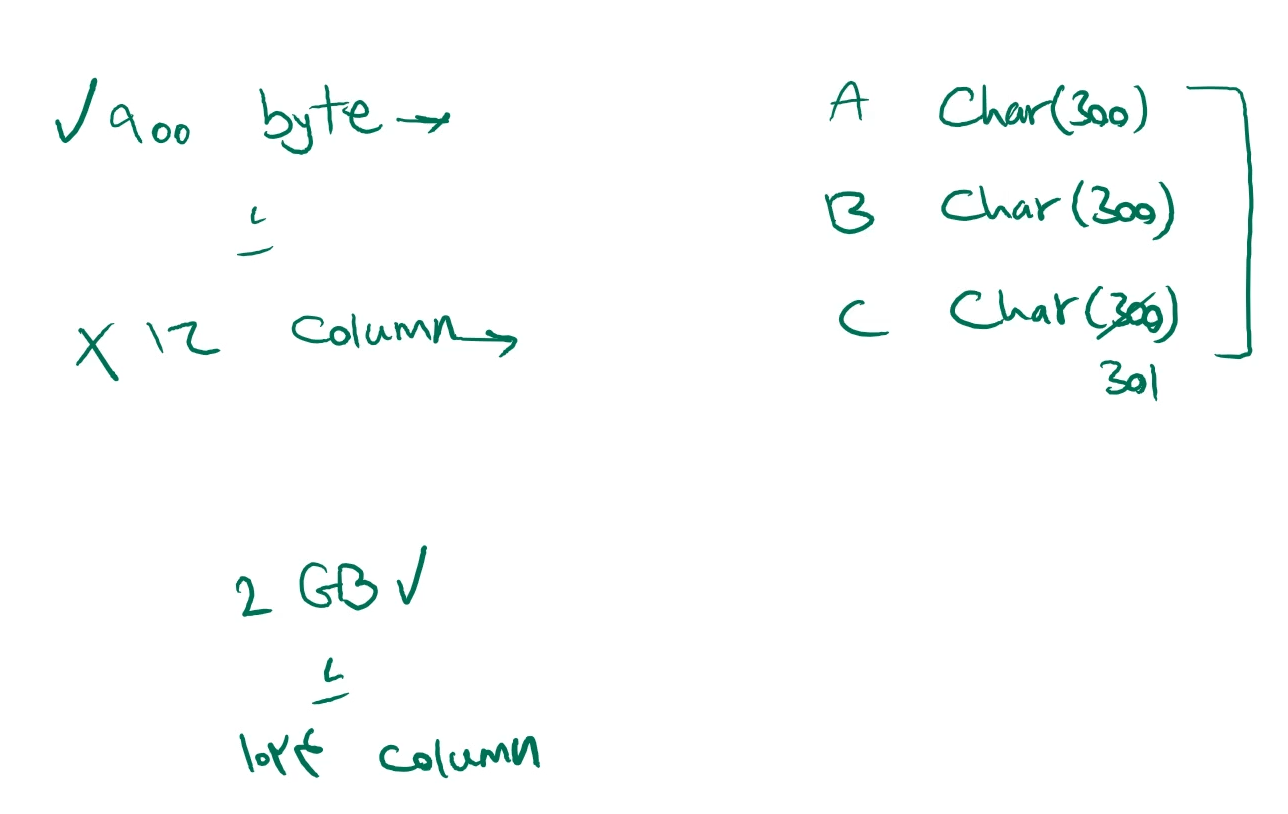
ما ماکیزیمم 16 ستون یا حجمش 900 بایت بشه - این محدودیت ها رو داریم
اینطوری میشه
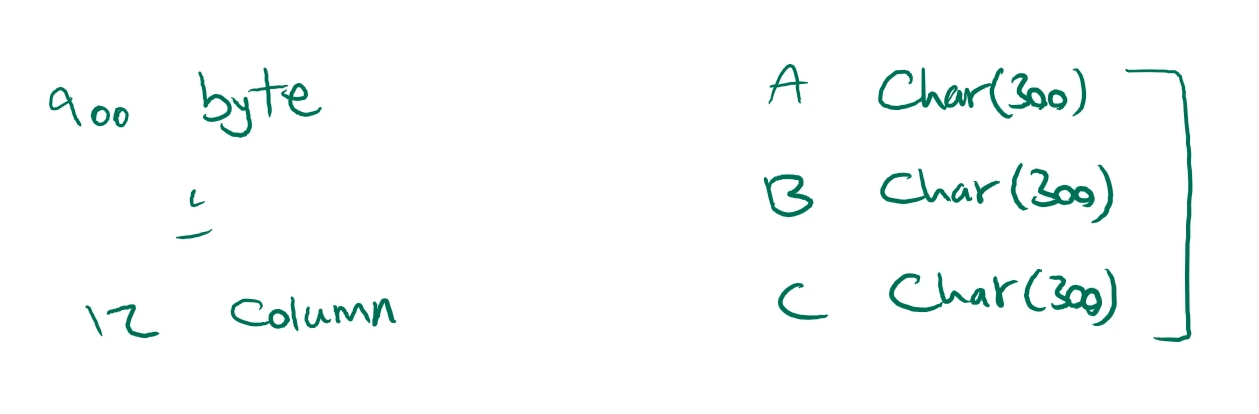
ولی اینطوری نمیشه :
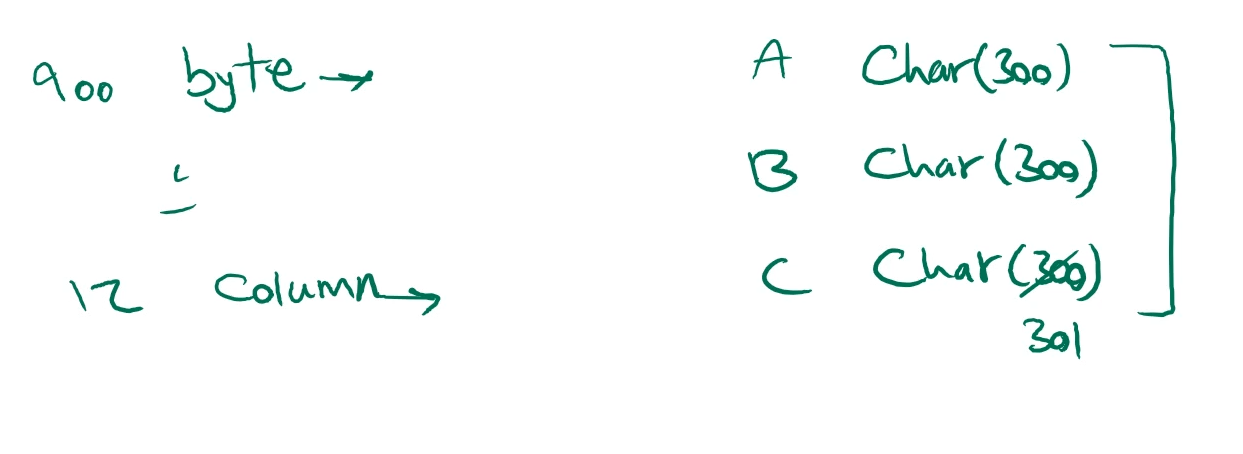
خوب
خوب یه آپشن باحال داریم که میاد فقط اطلاعات اون ستونی که میخوایم رو sort میکنه
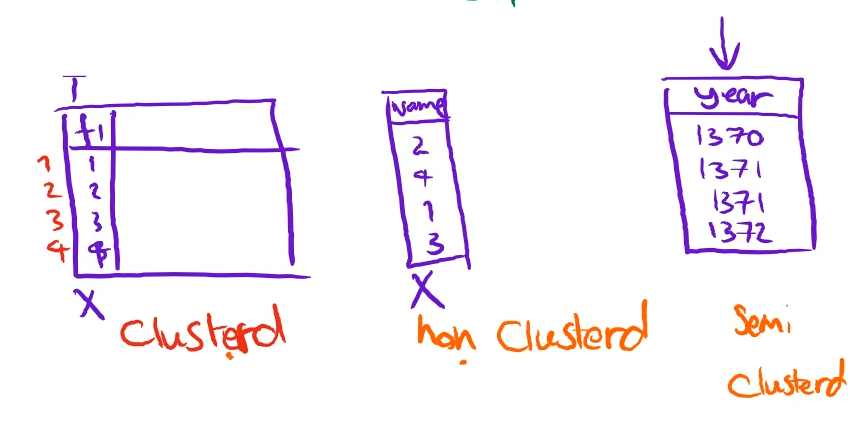
بهش میگن semi clusterd
خوب توی حالت semi clusterd ما سرعتمون بیشتره چون ما خوده اطلاعات رو داریم ولی توی حالت non clusterd ما pointer میزنیم برای بدست آوردن اصل اطلاعات
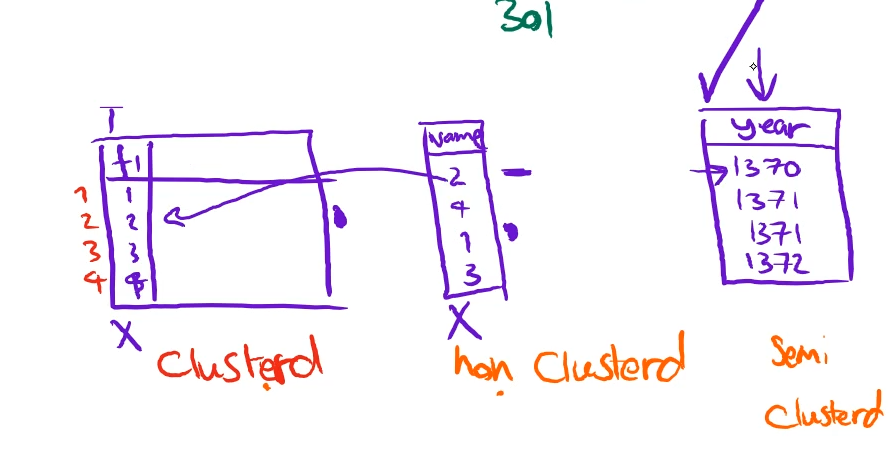
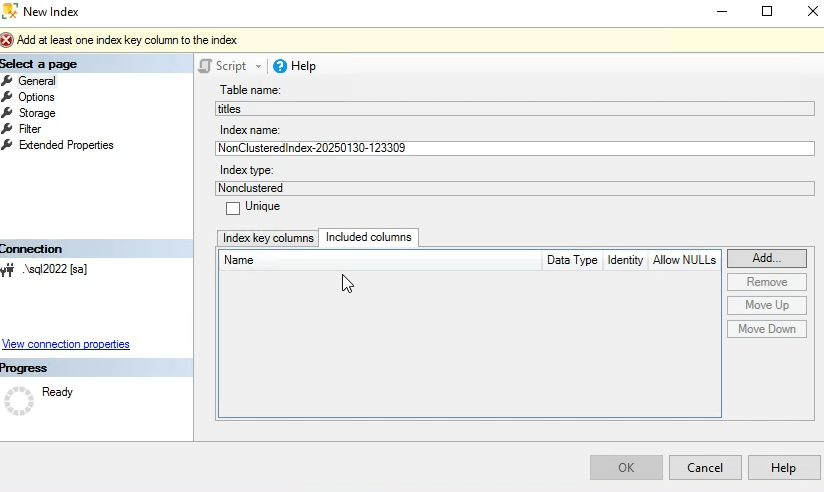
خوب اینجا 2 gb رو داریم - تعداد cloumn های بیشتر با حجم دیتا های بیشتر رو میتونیم بریزیم توش و خوده اون cloum اطلاعاتی رو اطلاعاتش رو مرتب نگه میداره
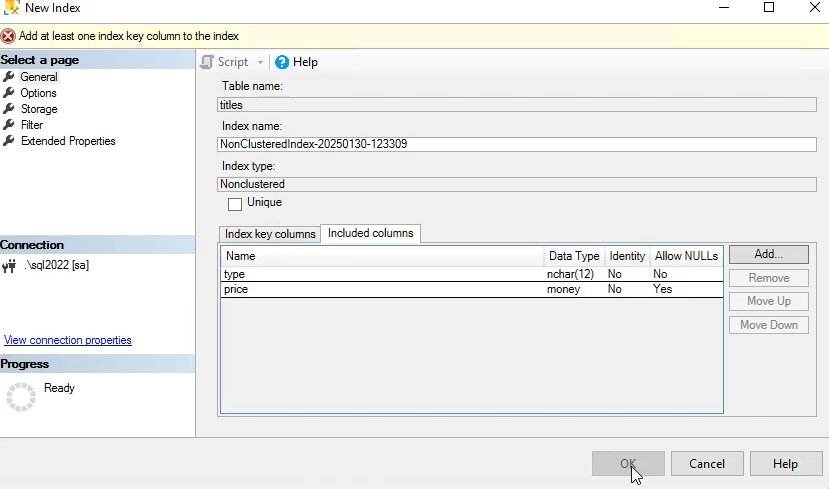
اینجا وقتی که میخوایم ok کنیم نمیزاره - چون باید حتما pk رو هم توی index ley cloum ها تعیین کنیم و بزاریم که این یه طوری ارتباط این دیتا ها رو با pk حفظ کنه
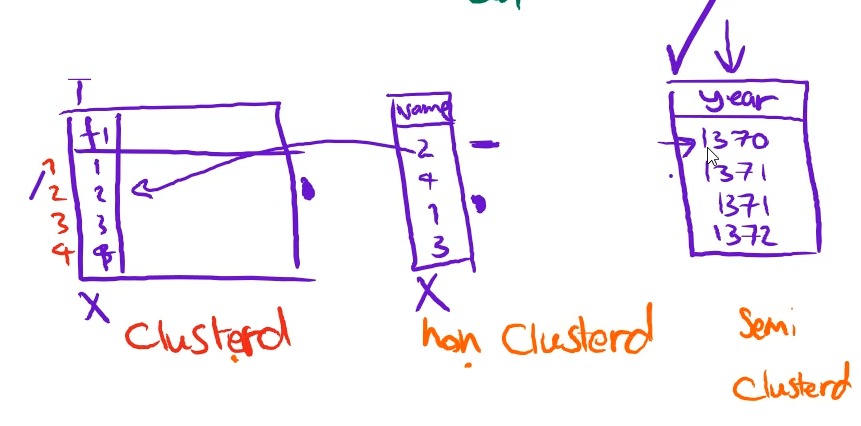
اینجا ما نمیدونیم که این 1370 برای کدوم رکورده برای همین میایم pk اش رو هم ذخیره میکنیم
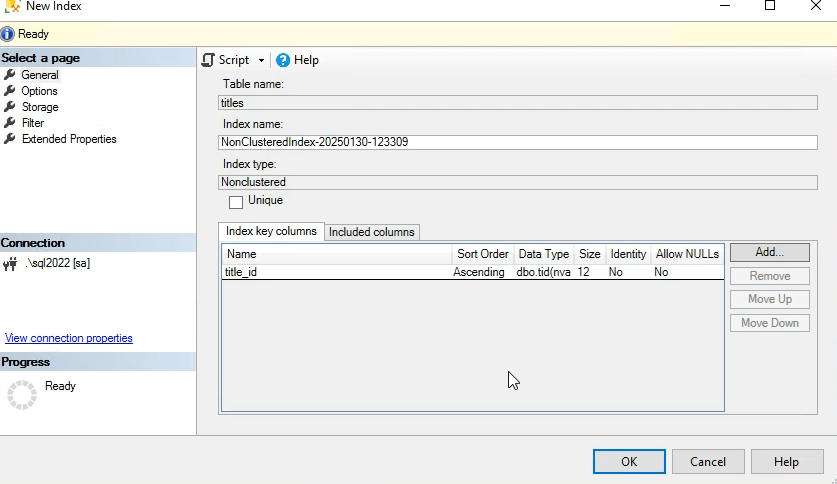
اگر حجمش رو داریم از این included cloum استفاده کنیم
خوب کی باید rebuild index کنیم ؟ خوب یه ایتمی داریم به اسم refragmentation فضا خالی بلا استفاده که وسط درخت btree مون داریم یا فضای خالی بین pag هامون داریم
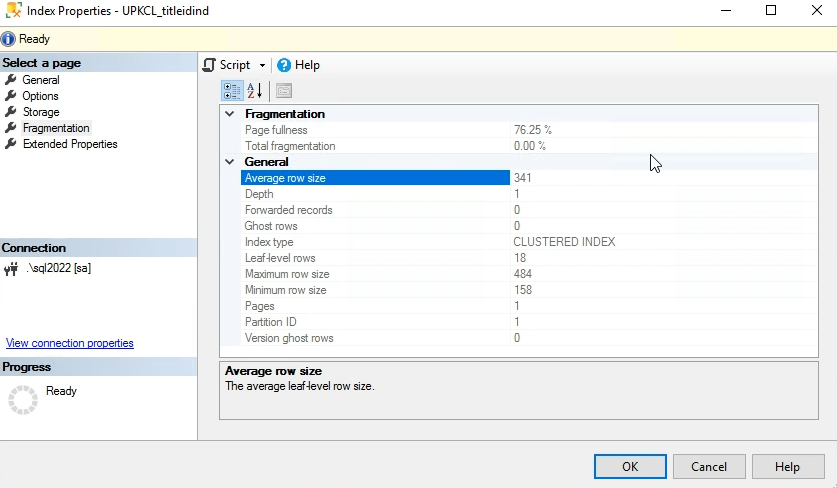
این فضاهای خالی - وقتی که page split اتفاق میوفته - مثل زمانی که 1 رکورد یا چند تا رکورد میخواست بیاد وارد بشه و یه page جدید ساخته میشد - ممکنه بقیه فضای توی اون page هم ازش استفاده نشه - پس page split های زیاد فضای خالی بدرد نخور بهمون اضافه میکنه در داخل btree
خوب update یک delete هستش و یک instet - وقتی که میگه 5 سهیل رو تغییر بدیم به 70 سهیل - اینجا 5 سهیل رو پاک میکنیم و میریم 70 سهیل رو توی یه page دیگه میریزیم - که این میتونه fragmentation رو ایجاد کنه
خوب اون فضا های خالی که برای پیج ها در نظر میگیریم ممکنه هیچ وقت استفاده نشن مخصوصا در intermadiate لایه ها
ممکنه درخت b tree ما نامتقارن باشه - اینطوری که اگر دیتا ی اول من 1 باشه تمام شاخه های بعدی در سمت راست شکل میگیره اینطوری که دیتای بعدی داره میاد اگر بزرگتر بود سمت راست و اگر کوچکتر بود سمت چپ شکل میگیره - در این حالت باید دیتا رو بشکونیم - و باید متقارنش کنیم که تعداد question ها رو کم کنیم
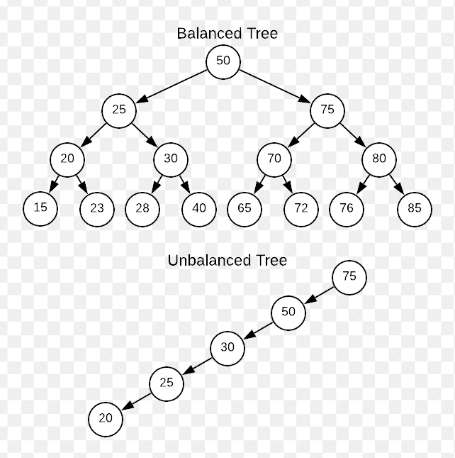
اگر زیر 30 درصد باشه اوکیه بین 30 تا 70 - مکانیزنیم re orgnize استفاده مکینیم
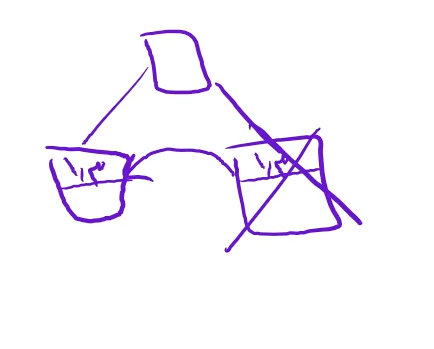
میگه اگر بتونم دیتا های سمت راستی رو ببرم توی سمت چپی به طور مثال بعدش اون راستی رو پاک میکنه - merge کردن میشه یه جورایی
بهینه سازی کمتر نسبت به rebuild ولی سریع تر
بالا 70 میشه rebuild
کلش رو پاک میکنیم و دوباره میسازیم - یعنی همه چی باید index گزاره بشه و … سرعتش پایینه ولی بهینه سازیش بهتره
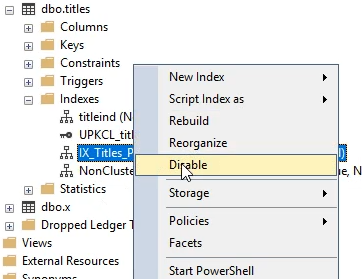
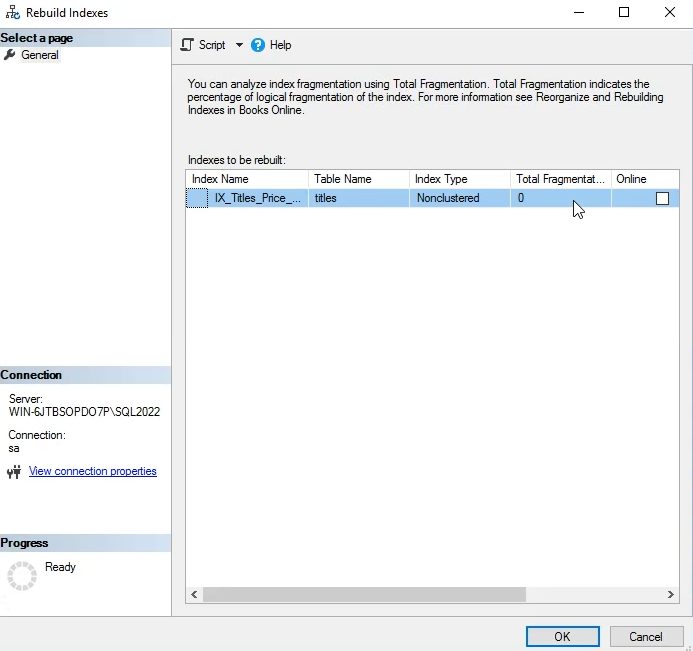
یه حالت دیگه هم داره
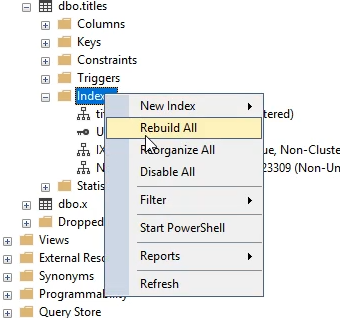
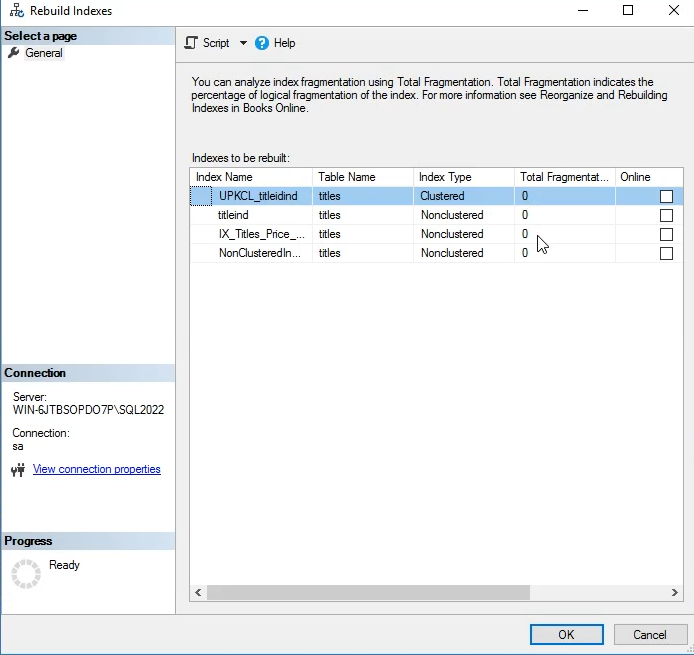
خوب diable هم برای وقتی که bulk - insert update delete میکنیم بهتره که index ها disable بشن
بشونیم توی جدول اول و بعد شروع کنیم index گزاری دوباره
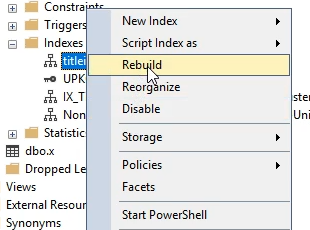
در مقابل disable ما enbale نداریم rebuild رو داریم
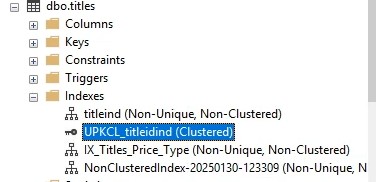
خوب وقتی که ما میزنیم که pk رو rebuild کنه چون index اش تغیییر میکنه بقیه non clusterd ها هم از دسترس خارج میشن چون به ایندکس pk وصله
بقیه هم باید rebuild بشن توی این حالت
ولی non clusterd ها رو rebuild کنیم همچین مشکلی پیش نمیاد
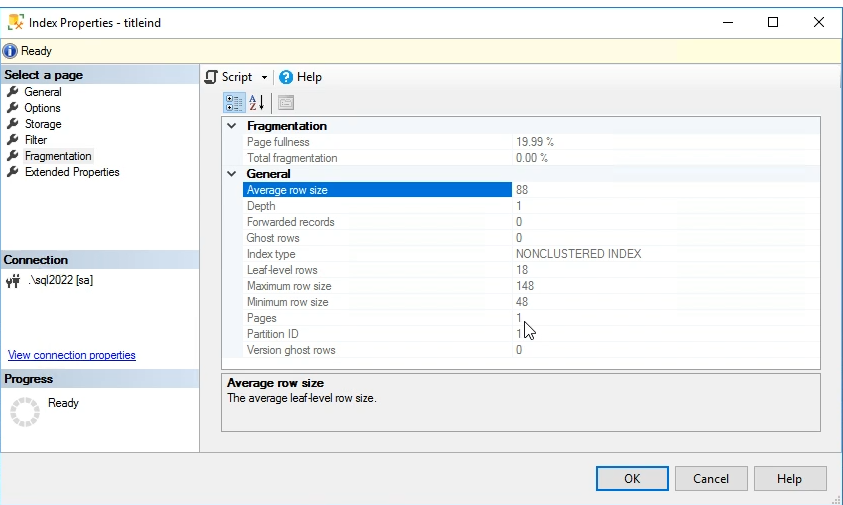
دیتاهای ملیونی به بالا تاثیر داره
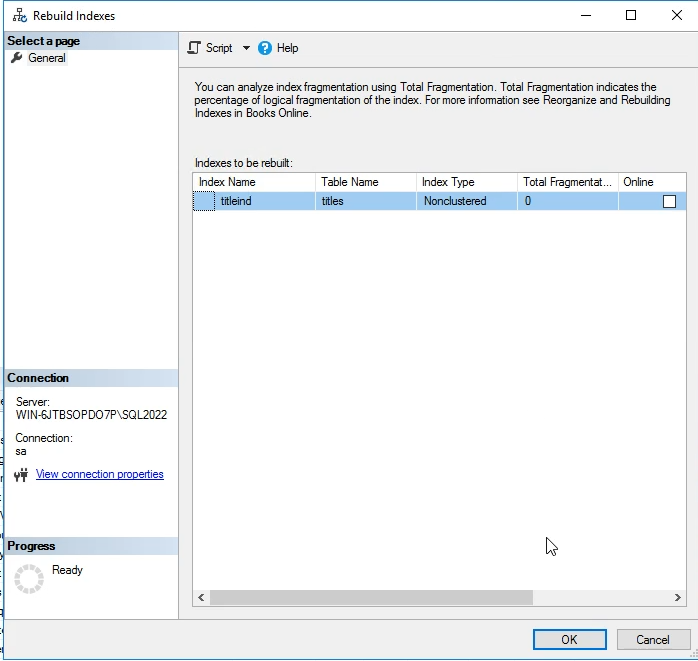
خوب نکته اینه که ما زدیم رو rebuild ممکنه این چندین ساعت طول بکشه — این صفحات wizard ای timeout دارن - بعد کلا پنجره رو میبنده و پروسه رو از بیخ قطع میکنه
اگر index گزاری مون بیشتر از 1 ساعت طول میکیشه میزنیم script اش رو میگیریم
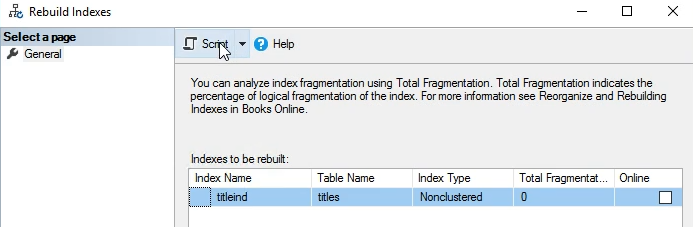
صفحه new query ما time out نداره
کی index بزاریم ؟
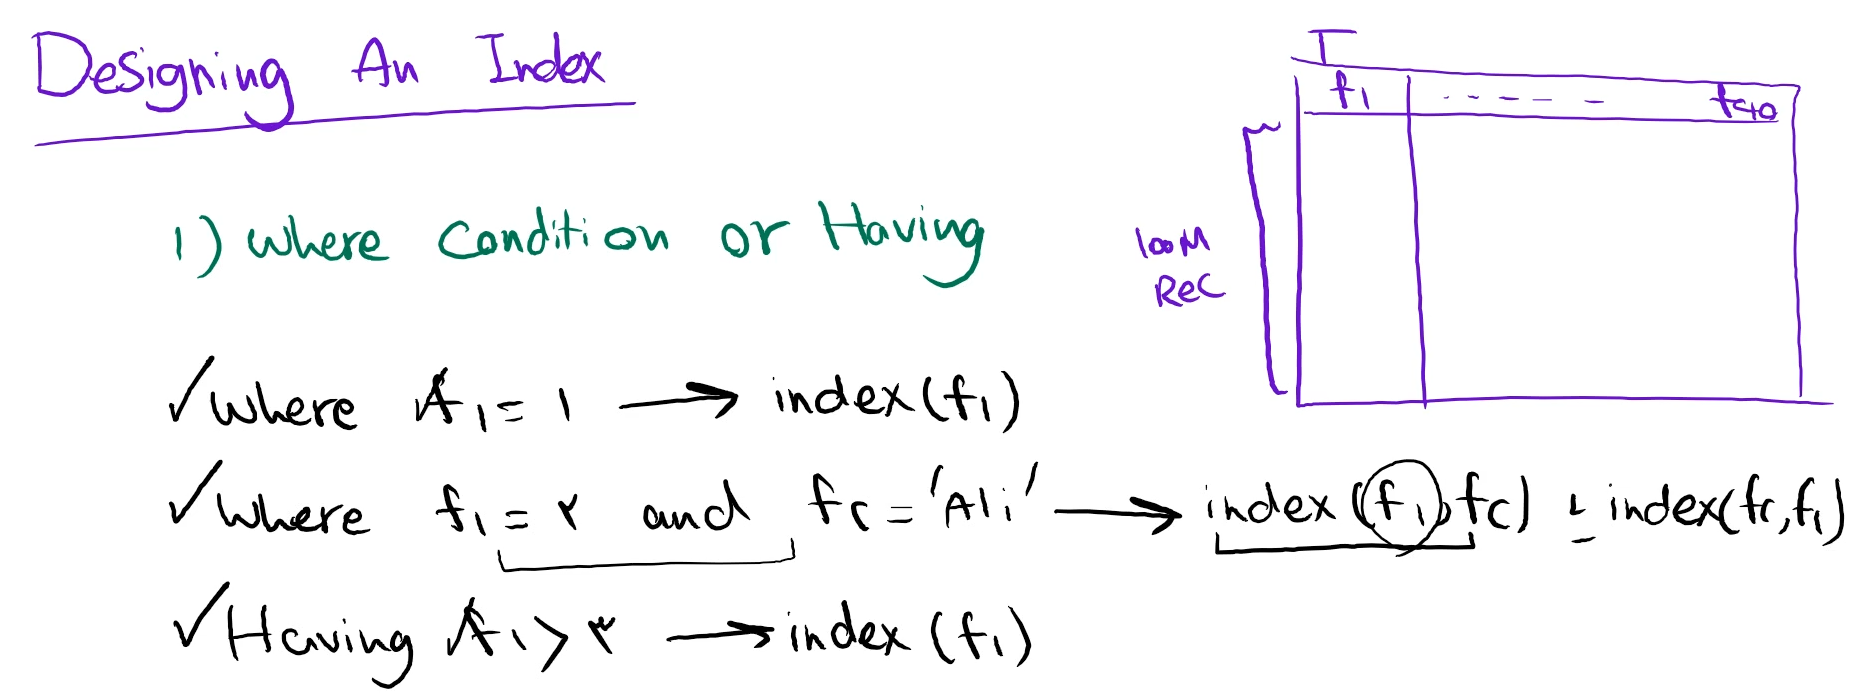
خوب اگر ما index f1 f2 یا برعکسش رو داشته باشیم دیگه نیازی نیست که index دیگه ای بزاریم
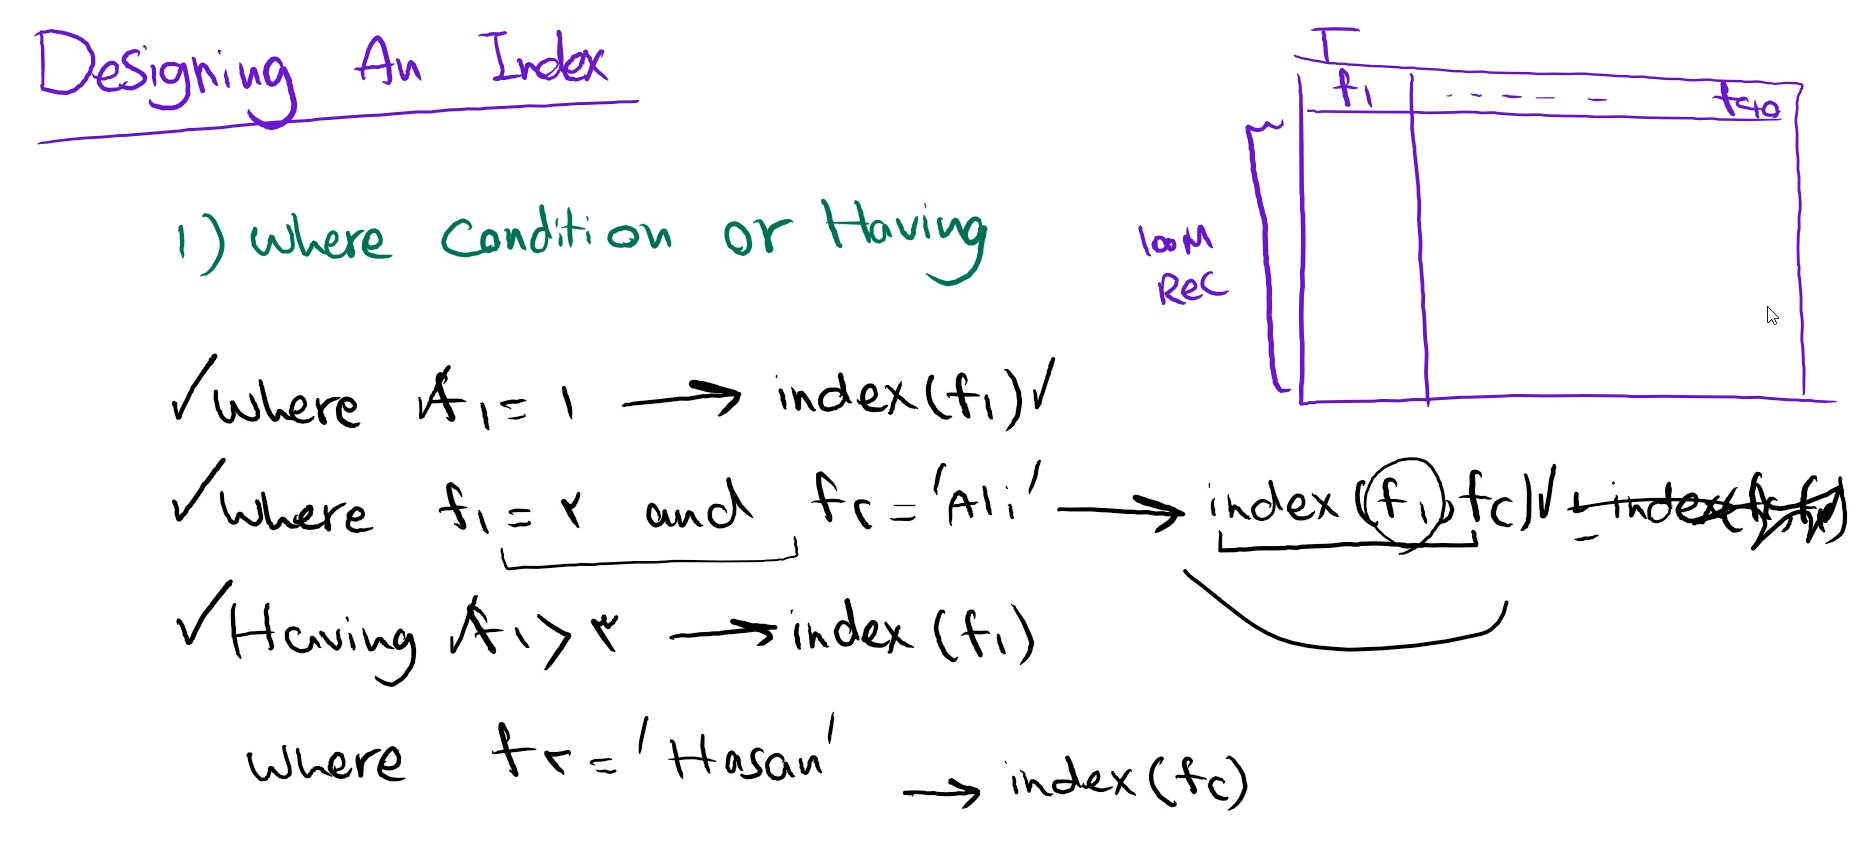
ما اول به where , having ها نگاه میکنیم
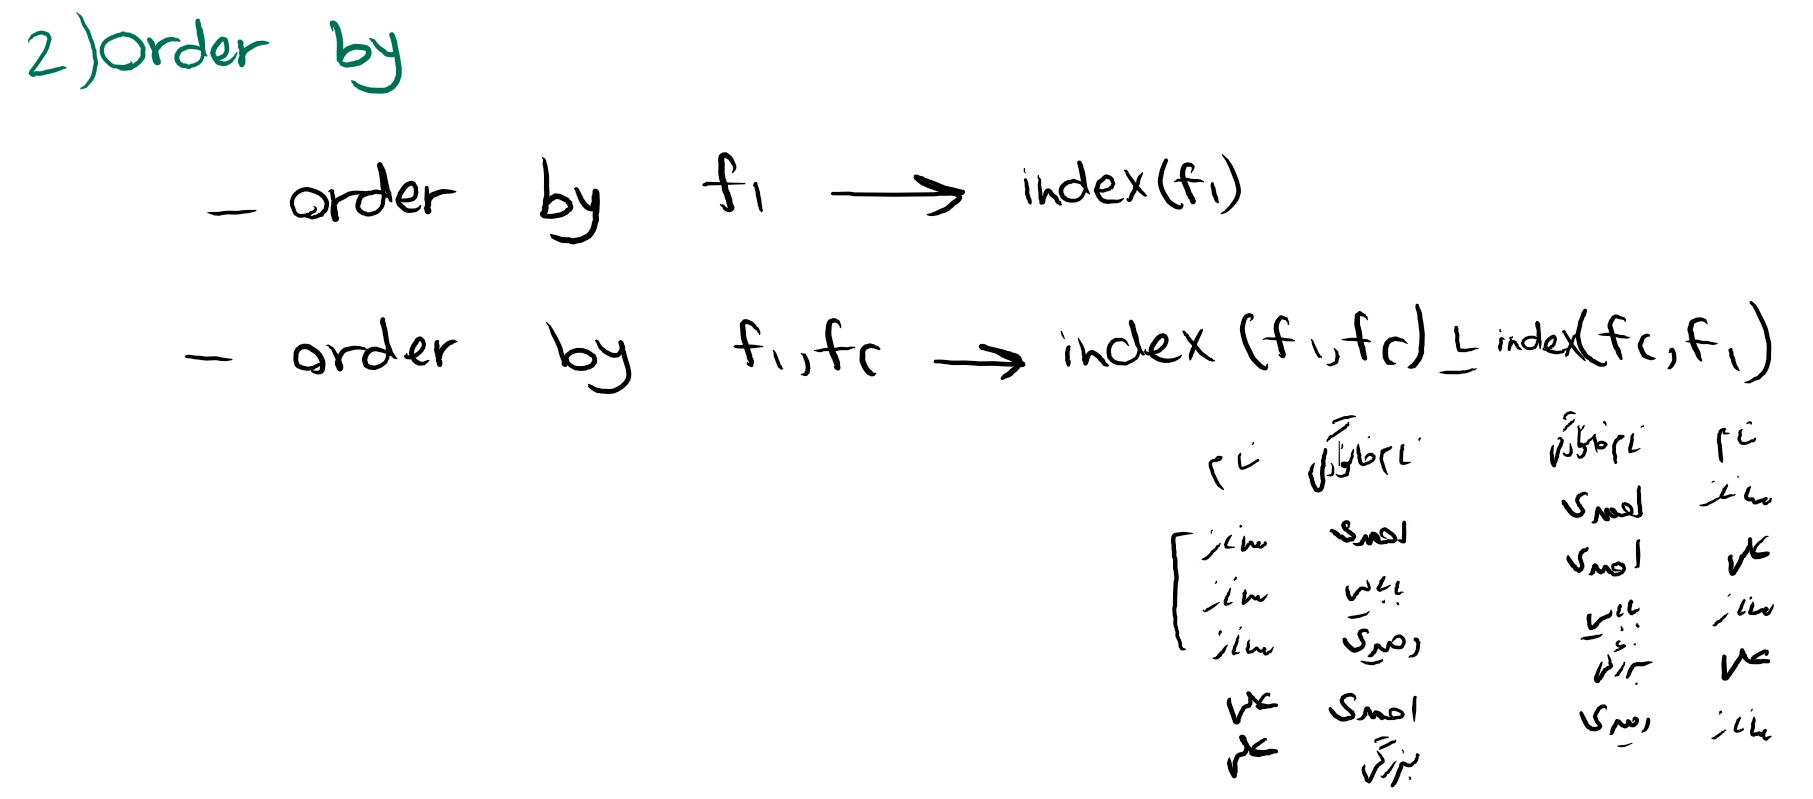
این دو تا order by با هم تفاوت داره
خوب مرتب کردن بر اساس سفارش ها از جدول سفارش و کد ملی از جدول اشخاص بره sort کنه - باید از indexed view استفاده کنیم
خوب یه مورد دیگه هم group by هستش :
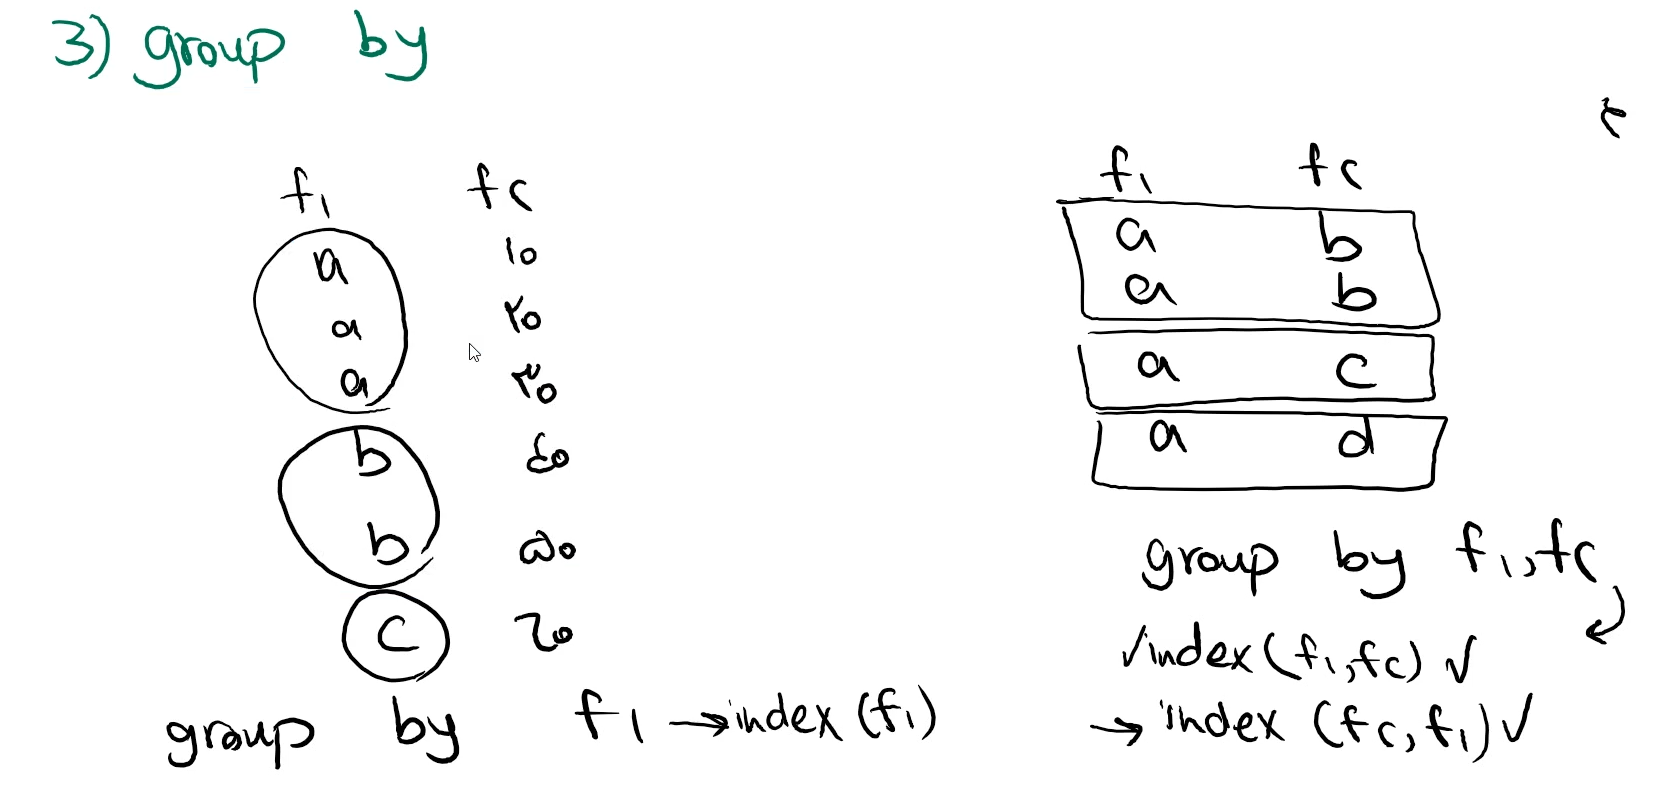
تایم 39:16
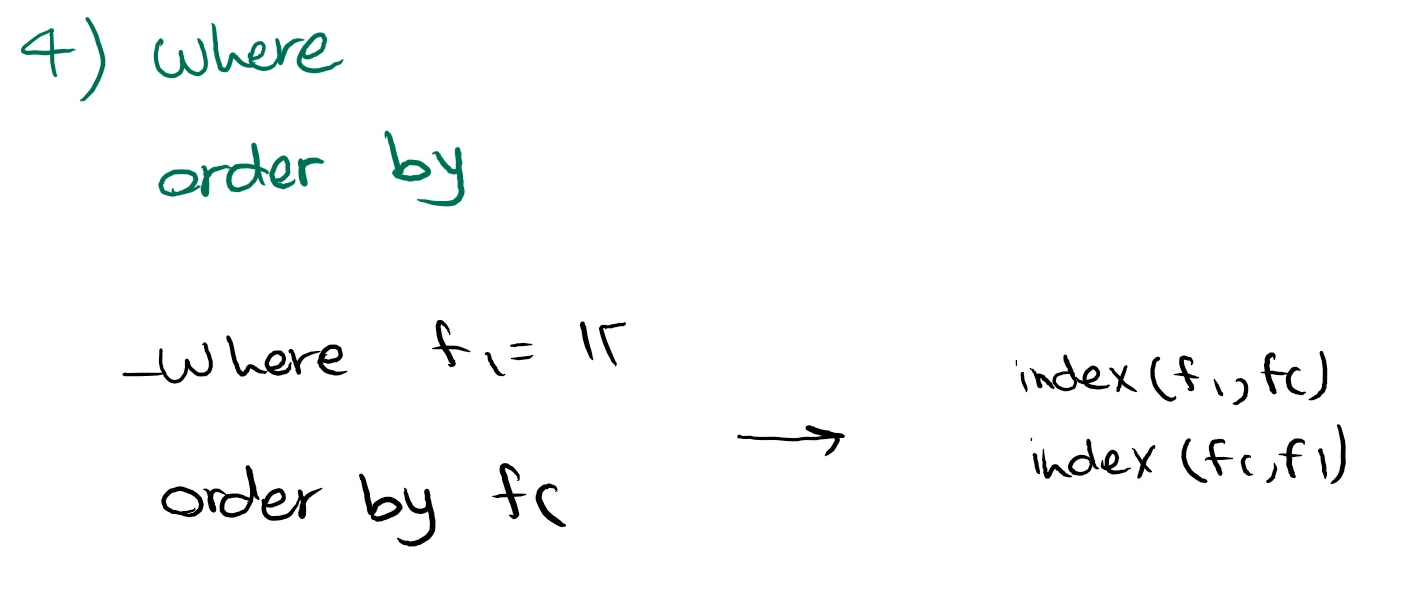
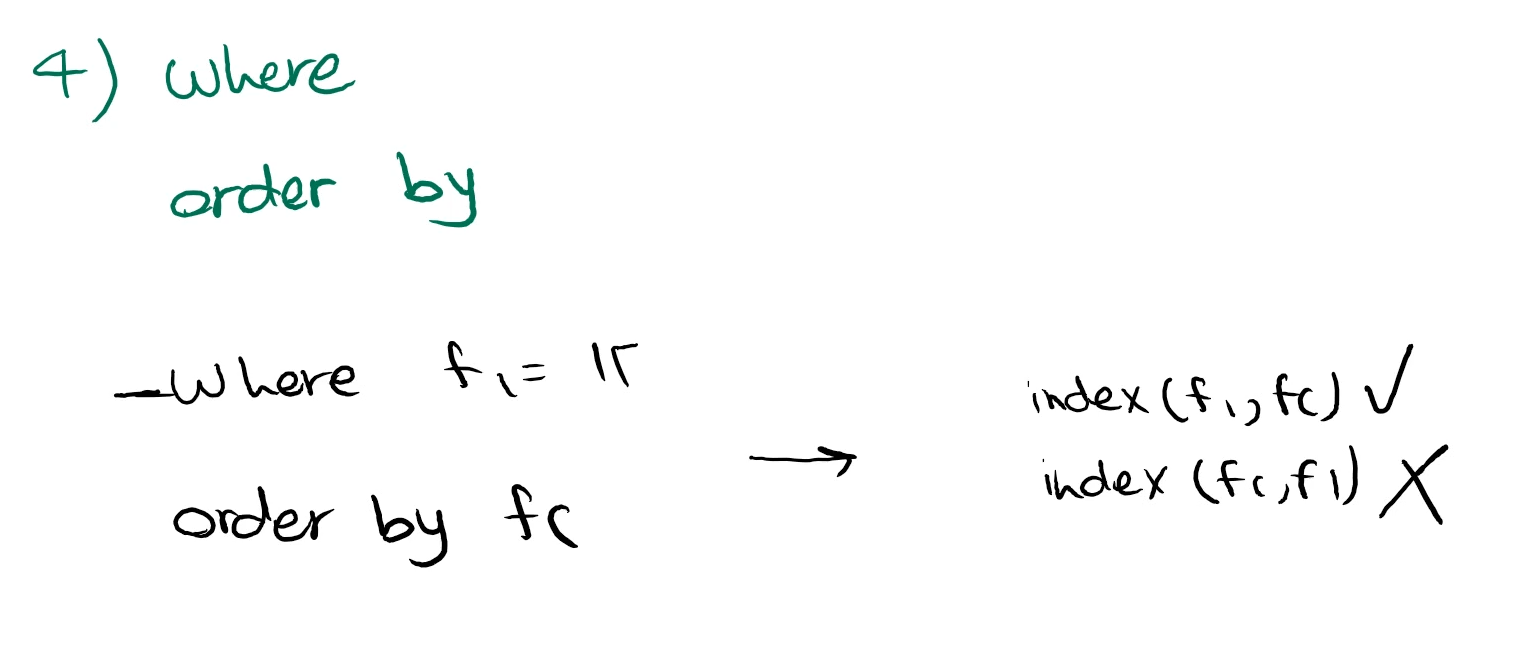
ترتیب اجرا مهمه پس اول whre که f1 هست و بعدش order by
ترتیب نگارشی داریم
ترتیب اجرای engine داریم
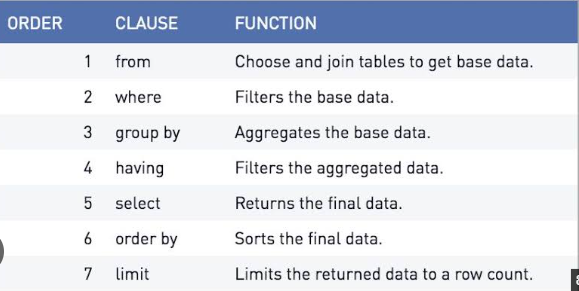
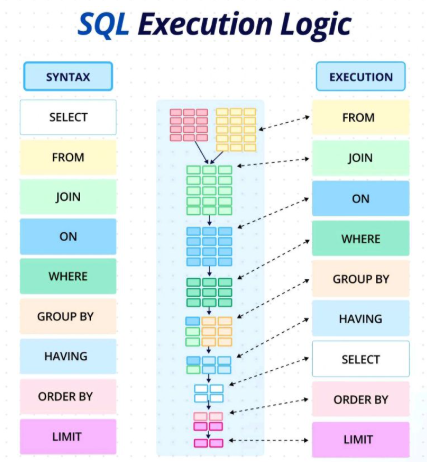
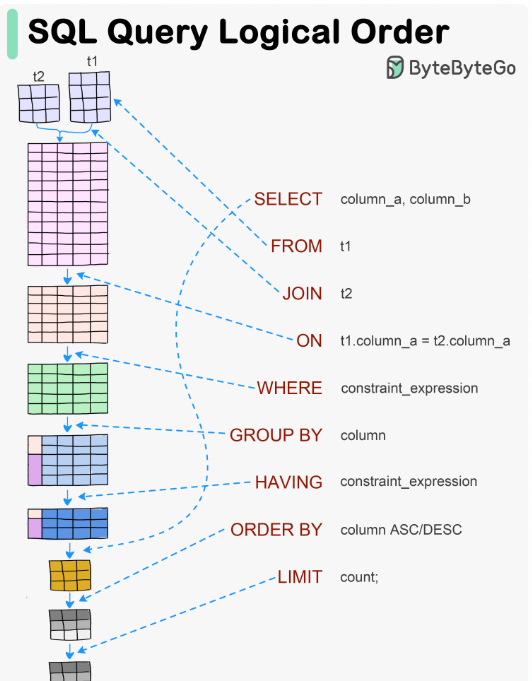
https://bytebytego.com/guides/visualizing-a-sql-query/
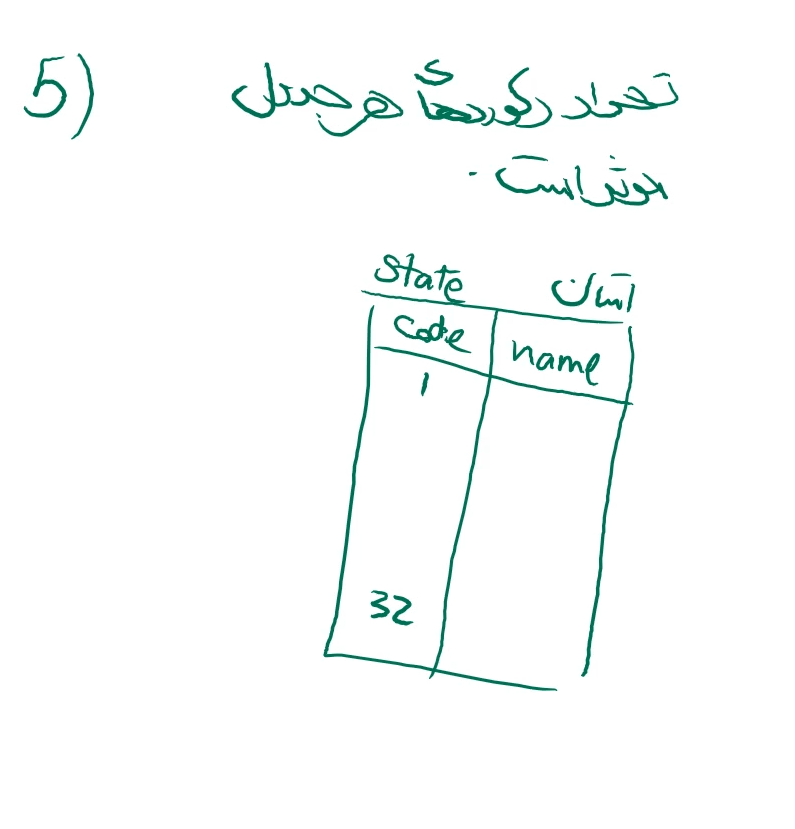
روی این جدول نیازی به ایندکس نیست
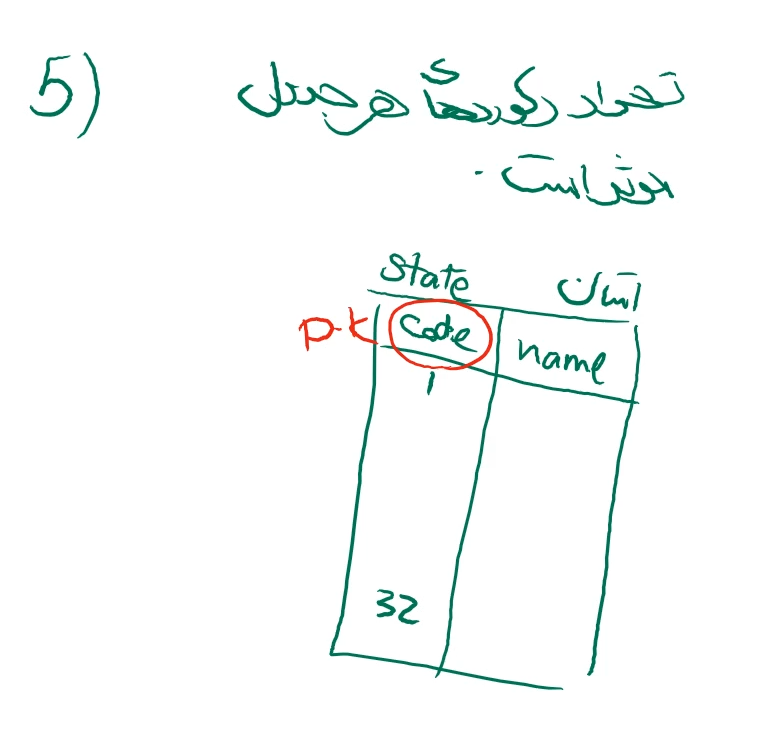
اگر pk تعیین کنیم خودش میاد index میسازه
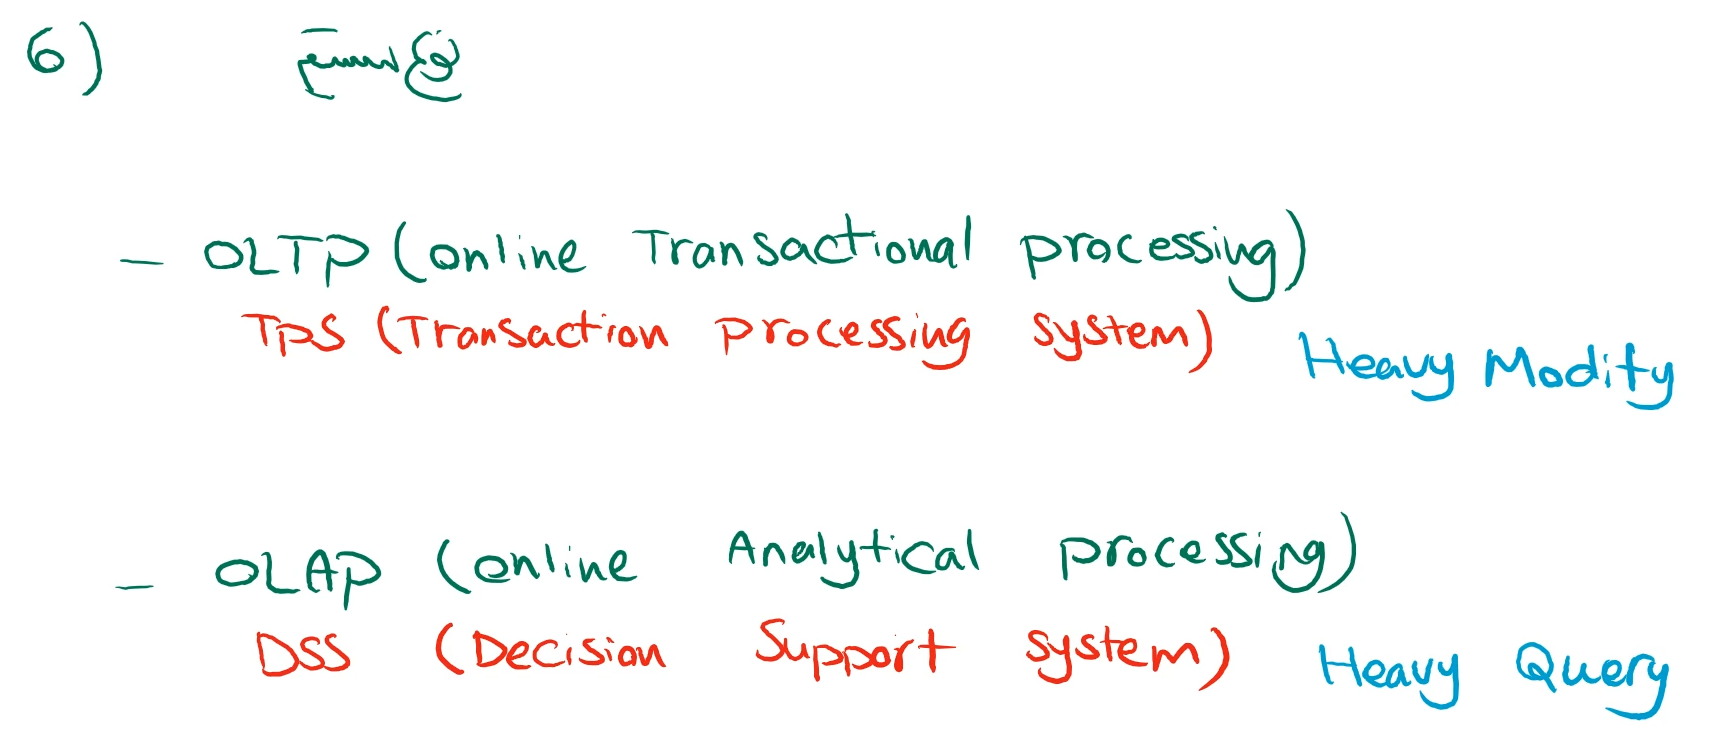
اولی برای crud دومی فقط برای گزارش هستش
مثلا برای یه فروشگاه - موجودی کالا داریم - ما به هیچ عنوان روی تعداد کالا ایندکس نمیزاریم چون همش در حاله تغییره و تعدادش رو نمیخوایم sort کنیم کخ
خوب سیستم های بانکی رو دو بخش میکنیم : همون دو بخش بالا - جدول واریز و برداشت - تمامی مشتریان اونجا دارن insert , update , delete میشه این اطلاعات رو توی یه دیتابیس با کمترین ایندکس میریزیم
و بعدش شب میریزیمش توی یه دیتابیس analytical برای گزارش ها - دیتا ها معمولا با یه تاخیر 24 ساعته وارد یه ware house میشه - و توی این دیتابیس ایندکس گزاری میکنیم تا میتونیم
اتمام جلسه 10